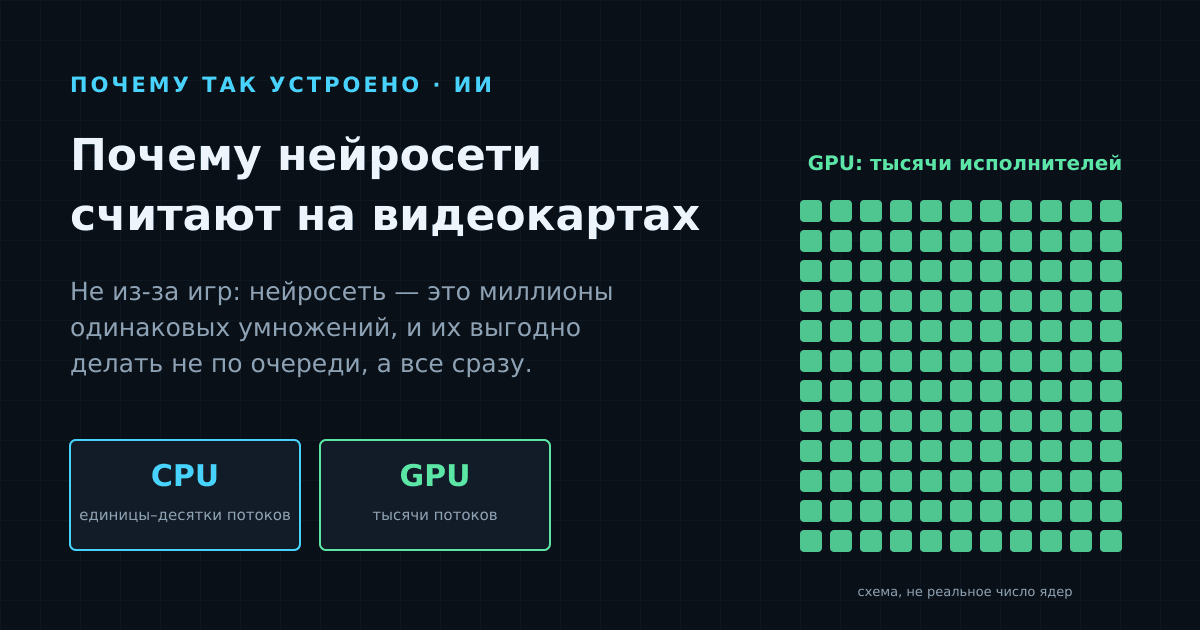

Если коротко: нейросеть почти целиком состоит из умножения огромных таблиц чисел (матриц), причём тысячи этих умножений не зависят друг от друга. Процессор — это несколько очень умных и быстрых исполнителей, которые справляются с разнородными задачами по очереди. Видеокарта — это тысячи простых исполнителей, которые делают одно и то же одновременно. Для работы, где нужно миллионы раз сделать одинаковое действие, второй вариант выигрывает в десятки раз. Игры тут вторичны: так получилось, что у графики и у ИИ одна и та же математика.
Я пишу на канале «Всё про ИИ и Роботов» про то, как устроены вещи, которыми мы пользуемся каждый день, и сегодня разберём один вопрос: зачем ИИ видеокарта и почему нельзя просто взять процессор помощнее. Ответ окажется проще, чем кажется, а «ага!»-момент случится на третьей минуте чтения.
Что на самом деле делает нейросеть, когда «думает»
Когда вы пишете вопрос в чат с ИИ, внутри не происходит ничего мистического. Ваш текст превращается в набор чисел, эти числа проходят через слои модели, а на выходе получается следующее слово. Каждый слой — это, по сути, большая таблица чисел (веса), на которую умножается таблица чисел с предыдущего шага. Всё. Миллиарды «параметров», о которых любят писать в новостях, — это и есть числа в этих таблицах.
Если вам интересно, откуда эти числа берутся, мы разбирали это в статье про то, как нейросеть «учится». Здесь важно другое: как бы красиво ни называлась архитектура, внизу всегда лежит одна и та же операция — перемножение матриц. В документации NVIDIA это называют GEMM, и там прямо сказано, что это «фундаментальный строительный блок» для полносвязных, рекуррентных и свёрточных слоёв, то есть практически всех основных видов нейросетей.
Сколько это — «много» умножений
Возьмём две матрицы. Чтобы получить одну ячейку результата, нужно перемножить числа из строки первой матрицы и столбца второй и сложить результаты. По формуле из руководства NVIDIA по матричным умножениям, для матриц размеров M×K и K×N требуется 2·M·N·K операций с плавающей точкой: по одному умножению и одному сложению на каждый элемент суммы.
Теперь прикинем масштаб. В работе Каплана и соавторов о законах масштабирования языковых моделей приведена оценка: прямой проход модели стоит примерно 2N операций на каждый токен, где N — число параметров, а полное обучение оценивается как около 6N операций на токен. Подставим сюда модель на 7 миллиардов параметров. Это порядка 14 миллиардов операций на каждый токен (кусочек слова) при ответе. Ответ в тысячу токенов — это уже около 14 триллионов операций. А обучение той же модели на триллионах токенов приводит к числам с двадцатью с лишним нулями.
Такие числа нельзя «пережить» последовательным счётом. Нужен способ делать очень много однотипной арифметики одновременно. Здесь мы подходим к главному.
Ага-момент: ячейки результата не ждут друг друга
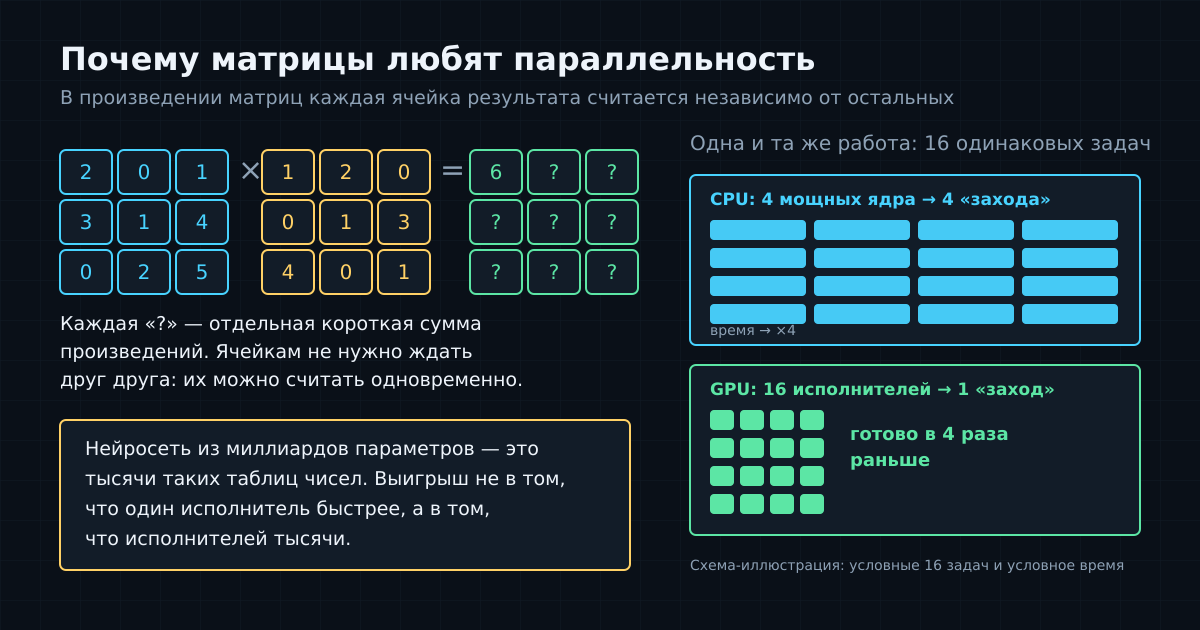
Посмотрите на умножение матриц внимательно. Чтобы вычислить левую верхнюю ячейку результата, мне не нужно знать, чему равна соседняя. Каждая ячейка — отдельная короткая задача: «возьми строку, возьми столбец, перемножь, сложи». Ни одна не зависит от результата другой. Если в таблице миллион ячеек, то это миллион независимых задач, которые можно раздать миллиону исполнителей (а если исполнителей поменьше, то раздать порциями).
Вот и весь секрет. Нейросеть быстро считается на видеокарте не потому, что видеокарта «умнее», а потому, что задача идеально параллельна. Умножение матриц — почти эталонный пример работы, которая разваливается на тысячи независимых кусочков без потерь и без ожидания друг друга.
Как устроены ядра: много простых против нескольких мощных
Теперь про сами чипы. Процессор (CPU) проектируют так, чтобы выполнять одну цепочку команд как можно быстрее. Он умеет предсказывать ветвления, держит большие кэши, чтобы не простаивать в ожидании данных, и справляется с любой задачей: от запуска браузера до расчёта таблицы. Но таких цепочек одновременно у него немного.
Видеокарта (GPU) устроена иначе. В руководстве по программированию CUDA это сформулировано так: процессор способен выполнять параллельно несколько десятков потоков, а видеокарта рассчитана на то, чтобы выполнять их тысячами. Причина — в распределении транзисторов: GPU тратит их в основном на вычисления, а не на кэши и сложное управление потоком команд. Выглядит это как компромисс: отдельный поток на GPU медленнее, но суммарная пропускная способность, как сказано в том же документе, оказывается гораздо выше.
Представьте кухню. Процессор — это пара шеф-поваров мирового уровня: они могут приготовить любое блюдо, но делают это по очереди. Видеокарта — это две тысячи поваров, которые умеют только одно: нарезать овощи. Если вам нужно приготовить сложное блюдо по уникальному рецепту, берите шефов. Если нужно нарезать миллион одинаковых морковок, шефы проиграют просто потому, что их мало.
Насколько это быстрее на практике
Идея не нова. Ещё в 2009 году Раджат Райна, Ананд Мадхаван и Эндрю Ын опубликовали работу о глубоком обучении на графических процессорах. По их данным, реализация обучения глубокой сети доверия на видеокарте оказалась до 55 раз быстрее, чем на двухъядерном процессоре, а обучение сети со 100 миллионами параметров сократилось с нескольких недель примерно до одного дня.
Заметьте оговорку «до»: цифра зависит от задачи, от того, с каким именно процессором сравнивают, и от того, насколько хорошо написан код. Честнее говорить о том, что выигрыш составляет порядок десятков раз на хорошо параллелящихся задачах, а не обещать «в сотни раз» всегда и везде. Но даже десятикратный разрыв превращает «обучать год» в «обучать пару недель», и именно такой скачок сделал современные нейросети практичными.
Переломный момент пришёл в 2012 году. Сеть AlexNet, выигравшая конкурс по распознаванию изображений, была обучена, как написано в самой статье, на двух видеокартах GTX 580 с 3 ГБ памяти за пять-шесть дней. Авторы отдельно отметили, что результаты можно улучшить, «просто дожидаясь более быстрых видеокарт и бо́льших наборов данных». Так и вышло: следом за AlexNet началась эпоха, в которой мы живём.
Тензорные ядра: когда железо заточено под матрицы
Следующий шаг логичен: если вся работа сводится к умножению матриц, зачем делать универсальные ядра? Современные ускорители NVIDIA содержат специальные блоки — тензорные ядра, которые умножают небольшие матрицы целиком за одну операцию. На странице ускорителя H100 компания указывает, что четвёртое поколение тензорных ядер вместе с Transformer Engine и 8-битной точностью FP8 даёт до четырёхкратного ускорения обучения модели уровня GPT-3 по сравнению с прошлым поколением. Это цифра производителя, так что читать её нужно как «в лучшем случае на подходящей задаче», но направление понятно: чипы всё больше подстраивают под матрицы.
Отсюда и лёгкая ирония названия. «Видеокарта» для ИИ давно не видеокарта в бытовом смысле: у многих ускорителей для дата-центров нет выхода на монитор вовсе. Но принцип остался тем же, что и у игровых GPU: тысячи параллельных арифметических блоков.
Развенчиваем миф: «видеокарта нужна только для игр»
Миф понятен: в магазине такие устройства лежат в разделе для геймеров. Но давайте посмотрим, что делает игра. Чтобы нарисовать кадр, нужно преобразовать координаты миллионов вершин (это умножение на матрицы) и посчитать цвет миллионов пикселей, причём цвет каждого пикселя считается независимо от соседних. То есть графика — это тоже «много одинаковой арифметики над независимыми данными». Видеокарту создавали для картинки, а заодно получили идеальную машину для нейросетей. Совпадение математики — и всё.
Верно и обратное: процессор вовсе не бесполезен. Небольшие модели вполне запускаются на нём, а для операционной системы, баз данных и логики приложения он незаменим. И сам GPU без процессора не работает: тот подготавливает данные и командует. В руководстве по CUDA прямо оговорено, что платой за массовый параллелизм служит более медленный отдельный поток. Если ваша задача последовательна, где каждый шаг зависит от предыдущего, видеокарта не поможет.
Про другие частые вопросы об ИИ у нас есть отдельные разборы, например про то, почему нейросеть уверенно выдумывает факты: это свойство самой модели, а не железа, на котором она считается.
Видеопамять: ограничитель размера модели
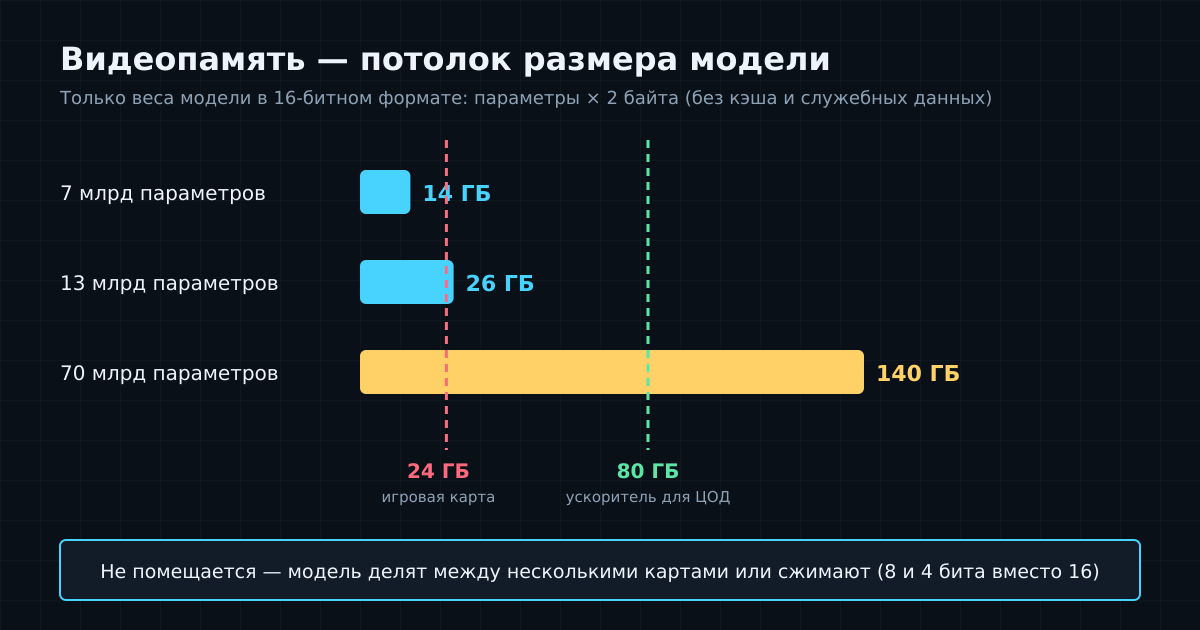
Скорость вычислений — только половина дела. Вторая — память. Чтобы модель работала быстро, её веса должны лежать в памяти самой видеокарты (VRAM), а не где-то далеко в оперативной. Размер считается просто: число параметров умножить на размер одного числа в байтах. Модель на 7 миллиардов параметров в 16-битном формате (2 байта) занимает 14 ГБ, на 13 миллиардов — 26 ГБ, на 70 миллиардов — 140 ГБ. Это только веса, а ведь нужны ещё служебные данные для самого разговора.
Авторы AlexNet упёрлись в то же самое ещё в 2012 году: размер сети, по их словам, был ограничен прежде всего объёмом памяти видеокарт, поэтому им пришлось разделить сеть между двумя GPU. Сегодня решение то же: большую модель режут между несколькими картами или сжимают числа до 8 или 4 бит, жертвуя частью точности ради размера.
Есть и тонкость, о которой редко пишут. В руководстве NVIDIA разобрано, что умножение матрицы на вектор (когда одна из размерностей равна единице) всегда упирается в память, а не в вычисления: на каждое прочитанное число приходится меньше одной операции. А крупные умножения матриц, наоборот, упираются в вычисления. Поэтому для ИИ важны два параметра ускорителя сразу: сколько арифметики он делает в секунду и как быстро читает память. Вот почему в характеристиках ИИ-карт так важен объём памяти, и вот почему стоимость разговора с ИИ в конечном итоге складывается из аренды таких ускорителей.
Что из этого следует для вас
Если вы просто пользуетесь ИИ через сайт или приложение, видеокарта вам не нужна: все эти тысячи ядер работают в дата-центре, а у вас обычный браузер. Именно так устроен, например, чат с нейросетью на нашем сайте: вы пишете вопрос, а тяжёлую матричную арифметику делают чужие ускорители. Можно попробовать Schai GPT и убедиться, что на вашем ноутбуке при этом ничего не греется.
Если же вы хотите запускать модели у себя, из механизма следуют три вывода. Первый: смотрите на объём видеопамяти раньше, чем на тактовую частоту, потому что модель либо помещается, либо нет. Второй: сжатые версии (8 и 4 бита) позволяют уместить модель покрупнее, но с потерей части точности. Третий: на процессоре тоже можно, но будет медленно, и теперь вы знаете почему.
Коротко
Нейросеть — это перемножение матриц. Миллиарды параметров — числа в таблицах, а каждый ответ и каждый шаг обучения — это триллионы умножений и сложений.
Ячейки результата не зависят друг от друга. Поэтому работу можно раздать тысячам исполнителей, и в этом весь секрет.
CPU — несколько мощных ядер, GPU — тысячи простых. По документации NVIDIA, процессор исполняет несколько десятков потоков параллельно, а видеокарта тысячи. Для параллельных задач выигрыш измеряется десятками раз (в классической работе 2009 года, до 55 раз).
Видеокарта нужна не только для игр. У графики и ИИ общая математика, поэтому одно железо подходит обоим.
Видеопамять задаёт размер модели. 7 млрд параметров в 16 битах занимают около 14 ГБ, 70 млрд около 140 ГБ.
Пока нет комментариев