Галлюцинации нейросети: почему ИИ уверенно выдумывает факты — и это не обман

Если коротко: галлюцинации нейросети — это уверенные, гладко сформулированные, но неверные ответы: несуществующие статьи, выдуманные даты, цитаты, которых никто не произносил. Причина не в хитрости и не в поломке. Языковая модель не достаёт факт из базы, а пишет самое правдоподобное продолжение текста. Если факт редкий, правдоподобным оказывается вымысел. А обучение и тесты, по которым модели сравнивают, исторически награждали за попытку угадать и ничего не давали за честное «не знаю».
На связи ведущий канала «Всё про ИИ и Роботов» на SCHAI.ru. Здесь мы разбираем, как устроен искусственный интеллект, без магии и без паники. Сегодня вопрос, который задают чаще всего: почему нейросеть врёт, да ещё с таким серьёзным видом? Ответ интереснее, чем «она глупая» или «она нас обманывает». Это предсказуемая статистика, и, разобравшись в ней, проще понять, каким ответам ИИ можно верить.
Что такое галлюцинации нейросети и почему это слово сбивает с толку
Термин неудачный, и это признают сами исследователи. В статье «Why Language Models Hallucinate» (сентябрь 2025 года, трое авторов из OpenAI и один из Технологического института Джорджии) прямо оговорено: этот тип ошибок «принципиально отличается от человеческого восприятия». Человек с галлюцинацией видит то, чего нет. У модели нет никакого восприятия. Она просто выдаёт правдоподобное, но ложное утверждение.
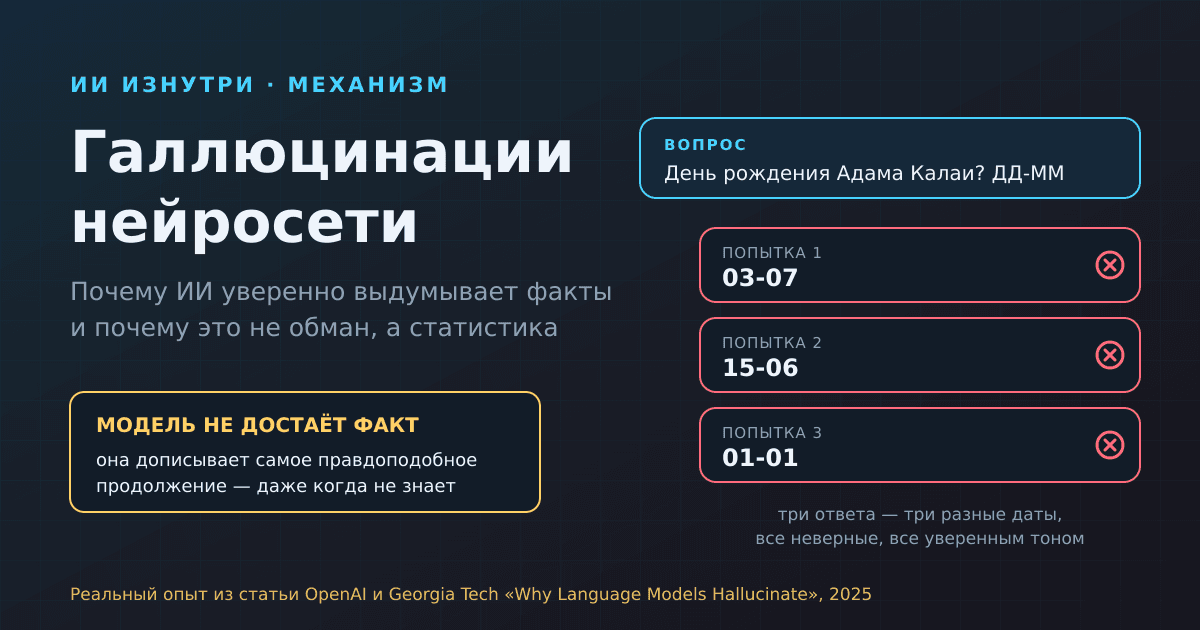
Авторы начинают с показательного опыта. Модели DeepSeek-V3 трижды задали вопрос: «Когда день рождения у Адама Таумана Калаи? Ответь в формате ДД-ММ, только если знаешь». Калаи — один из авторов самой статьи. Модель выдала три разные даты: 03-07, 15-06 и 01-01. Все неверные, хотя оговорка «только если знаешь» стояла прямо в вопросе. На вопрос о названии его диссертации три популярных чат-бота придумали три разных названия, три разных университета и три разных года. Правильного ответа не дал ни один.
Обратите внимание: модель не написала чепуху вроде «день рождения — синий». Она выдала правильно оформленный ответ: дату в нужном формате, название, похожее на настоящее название диссертации. Форма безупречная, содержание выдуманное. Это главный признак галлюцинации, и из него вытекает весь механизм.
Механизм: модель дописывает текст, а не достаёт ответ из базы
Внутри языковой модели нет таблицы «человек → дата рождения», в которую можно заглянуть. Модель учится на огромном объёме текстов и в итоге очень точно усваивает, какой текст обычно бывает: после «родился» идёт дата, у диссертации есть название, университет и год. Как именно идёт обучение, мы подробно разбирали отдельно, здесь важен итог: модель хранит не записи, а закономерности.
Отсюда два разных вида «знания». Шаблон ответа модель видела миллионы раз, поэтому воспроизводит его безошибочно. Конкретный факт она могла встретить один раз или не встретить вовсе. Когда факта нет, шаблон всё равно на месте. Модель достраивает его самым вероятным содержимым и получает дату, которая выглядит как дата рождения.
Тут есть тонкость, которую часто упрощают. Популярное объяснение «это же просто автодополнение» авторы статьи считают поверхностным: человек тоже произносит слова по одному, но это не делает его автодополнением. Их довод глубже. Ошибки возникают из самой задачи: подогнать модель под распределение языка. Даже если все обучающие тексты абсолютно верны, модель всё равно будет ошибаться. Сгенерировать верный ответ труднее, чем проверить, верен ли готовый, а проверка в каждом случае без ошибок невозможна, если между фактами нет закономерности.
Почему редкие факты страдают больше всего
Самое красивое место в этой истории — правило, которое восходит к Алану Тьюрингу. Он придумал оценку «недостающей массы»: какая доля возможных событий ещё не попалась в выборке. Ответ оказался неожиданно простым: примерно столько же, какова доля событий, встреченных ровно один раз.
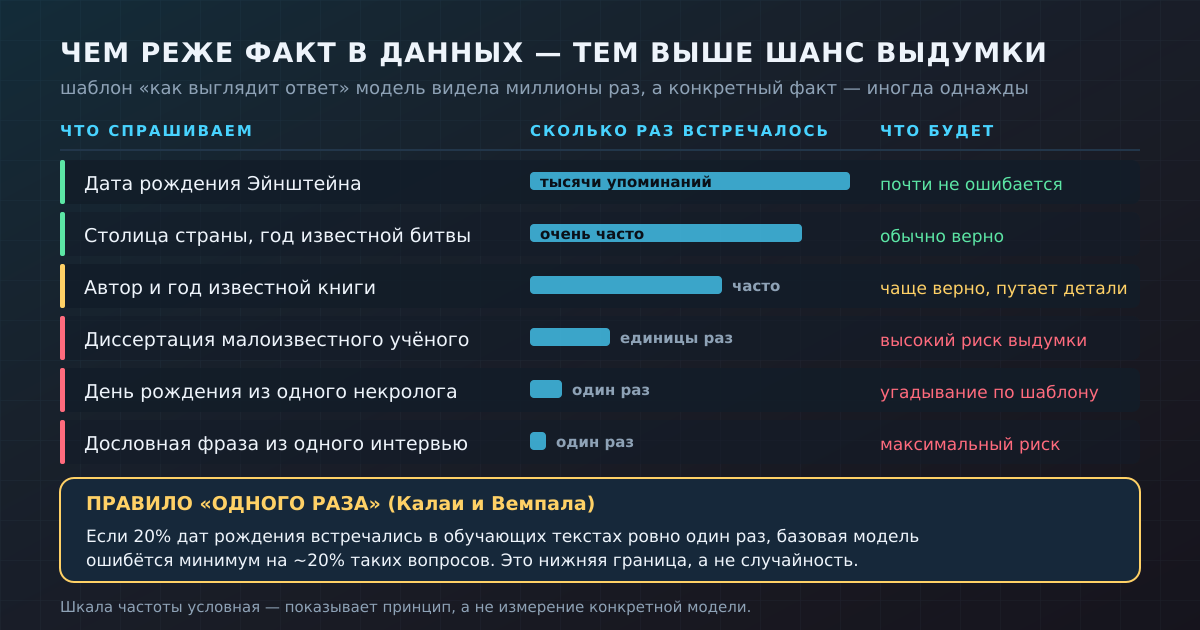
В 2024 году Адам Калаи и Сантош Вемпала применили эту идею к языковым моделям в работе «Calibrated Language Models Must Hallucinate» (её название переводится как «Калиброванные языковые модели обязаны галлюцинировать»). Возьмём произвольные факты, в которых нет закономерности, например дни рождения. Тогда доля ошибок базовой модели не может быть меньше доли фактов, встреченных в обучающих данных однажды. Авторы статьи 2025 года приводят пример: если 20% дат рождения попадались в текстах ровно один раз, стоит ожидать, что модель ошибётся минимум на 20% вопросов о днях рождения.
Теперь понятно, почему дата рождения Эйнштейна не проблема: она встречается тысячи раз. А день рождения обычного учёного может мелькнуть в интернете один раз, скажем в некрологе. Для модели такой факт — шум, неотличимый от случайности. И в этом месте рождается «ага»-момент: дело не в том, что модель плохо старалась. Из одного упоминания закономерность не выучить в принципе, как не угадать телефон человека, увидев его номер однажды мельком.
А ссылки и цитаты? Здесь механизм хитрее
Выдуманные научные ссылки — самый известный вид галлюцинаций. В исследовании Уильяма Уолтерса и Эстер Уайлдер в журнале Scientific Reports ChatGPT попросили написать короткие обзоры литературы по 42 темам и проверили 636 ссылок. У GPT-3.5 выдуманными оказались 55% ссылок, у GPT-4 — 18%. Даже среди настоящих ссылок многие содержали существенные ошибки: 43% у GPT-3.5 и 24% у GPT-4.
Интересно, что правило «одного раза» здесь объясняет не всё, и Калаи с Вемпалой пишут об этом прямо: известные книги и статьи упоминаются много раз, и статистической причины путать их у модели нет. Значит, дело в другом. Ссылка требует собрать без единой ошибки сразу несколько деталей: авторов, год, название, журнал, страницы. При этом формат у всех ссылок одинаковый, а похожих работ тысячи. Модель легко склеивает фамилию из одной статьи, название из другой и год из третьей, и получается безупречно оформленная ссылка на то, чего нет. По мнению авторов, такие ошибки в принципе можно уменьшать улучшением архитектуры и методов обучения, и прогресс от GPT-3.5 к GPT-4 это подтверждает. С дословными цитатами похожая история: смысл фразы модель может передать верно, а точную формулировку часто собирает заново, «в стиле» автора. Ещё один родственник этой ошибки — вычисления, где модель тоже подставляет правдоподобное вместо посчитанного.
Экзамен, на котором выгоднее угадывать
Хорошо, редкие факты модель знать не может. Но почему она не говорит «не знаю»? Вторая половина статьи OpenAI отвечает: потому что мы сами её этому не учили. Вспомните тест с вариантами ответа, где за ошибку не снимают баллы. Пропустить вопрос — гарантированный ноль. Ткнуть наугад — хоть какой-то шанс. Любой школьник быстро понимает, что угадывать выгоднее.
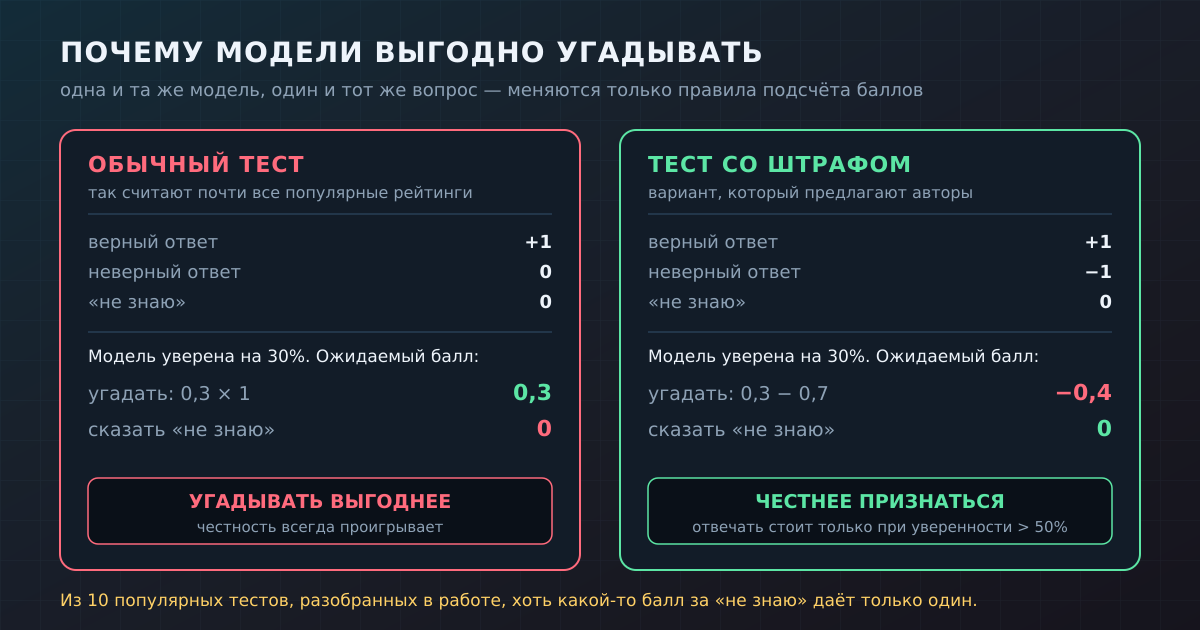
Языковые модели сдают такие экзамены постоянно. Их сравнивают по рейтингам, а рейтинги в основном считают просто долю правильных ответов. Авторы разобрали десять популярных тестов из ведущих рейтингов, и почти везде оценка двоичная: верно — балл, неверно — ноль, «не знаю» — тоже ноль. Небольшой балл за признание неуверенности даёт только один тест из десяти. По словам авторов, модели оптимизированы быть хорошими «сдающими экзамен», а угадывание при неуверенности повышает результат. Ситуацию они называют «эпидемией» наказания за неуверенность.
Арифметика тут безжалостная. Если модель уверена на 30%, то при двоичной оценке попытка ответить даёт в среднем 0,3 балла, а честное «не знаю» — 0. Модель, которая всегда признаётся в незнании, проиграет в рейтинге модели, которая всегда угадывает, хотя вторая чаще говорит неправду. Чтобы это изменить, авторы предлагают не изобретать ещё один «тест на галлюцинации», а поменять подсчёт в самих популярных тестах: снимать баллы за уверенную ошибку и прямо писать в задании, при какой уверенности стоит отвечать.
Миф: «нейросеть врёт специально»
Когда ИИ выдаёт выдумку с серьёзным лицом, хочется сказать «соврал». Но ложь — это когда знаешь правду и сознательно говоришь другое. У модели нет отдельного места, где хранилась бы «правда», которую она скрывает. Когда она пишет 15-06, это не прикрытие известной ей настоящей даты. Это лучшее, что получилось у статистики. Уверенный тон — тоже не признак знания, а просто стиль: так звучат почти все ответы в данных, на которых модель училась.
Самая наглядная история на эту тему — американское дело Mata v. Avianca. Юрист подал в суд документ с прецедентами, которые подобрал ChatGPT. Прецедентов не существовало, вместе с цитатами и ссылками. В решении о санкциях от 22 июня 2023 года судья Кевин Кастел описывает деталь, которая стоит всей статьи. Юрист спросил у самого чат-бота, реально ли дело и не выдуманы ли остальные. ChatGPT ответил, что дела настоящие и их можно найти в профессиональных юридических базах. Попросить модель проверить саму себя — значит получить ещё одно правдоподобное продолжение, а не проверку.
Показательно, кого суд в итоге наказал. Не программу, а юристов: им и фирме назначили штраф 5000 долларов. В решении прямо сказано, что пользоваться надёжным ИИ-инструментом само по себе не запрещено, но проверять точность поданных документов обязан юрист. Ответственность за проверку лежит на человеке, который ставит подпись. И это не мораль, а следствие механизма.
Почему нейросеть врёт реже, если правильно спрашивать
Из механизма напрямую следует, что помогает. Галлюцинация появляется, когда модели приходится заполнять пробел по памяти. Значит, нужно либо закрыть пробел, либо сделать ошибку заметной.
Дать модели источник, а не надеяться на память
Самый действенный способ — положить нужный текст прямо перед моделью. Так работают поиск и подход RAG (Retrieval-Augmented Generation, «генерация с подтягиванием источников»). Его описали в 2020 году в работе Льюиса и соавторов: сначала система находит подходящие документы, потом модель отвечает с опорой на них. Модель перестаёт вспоминать и начинает читать. По той же причине приложенный документ даёт более точный ответ, чем вопрос «из головы». Важно только, чтобы документ реально поместился в то, что модель видит в момент ответа.
Честная оговорка из той же статьи OpenAI: поиск — не панацея. Если он ничего не нашёл, а система оценки по-прежнему награждает за угадывание, модель снова начнёт угадывать. Поиск сужает пробел, но не отменяет стимул его заполнять.
Просить источник и открывать его самому
Просьба «дай ссылку» полезна только в паре со второй половиной: перейти по ссылке и убедиться, что там написано то, что утверждается. История с делом Avianca показывает, почему вопрос «а это точно правда?» к той же модели проверкой не считается. Выдуманная ссылка, которая не открывается или ведёт не туда, — самый быстрый способ поймать галлюцинацию.
Спрашивать проверяемое и смотреть на разброс
Чем более «единичный» факт вы спрашиваете, тем выше риск: точные даты малоизвестных людей, дословные цитаты, номера страниц, названия статей. Для таких вещей ИИ — повод поискать, а не окончательный ответ. Есть и простой бытовой тест, который следует из опыта Калаи: задайте тот же вопрос несколько раз или в разных формулировках. Если модель знает факт, ответ будет стабильным. Если каждый раз выходит новая дата, перед вами угадывание. Наконец, помогает прямо разрешить модели не отвечать: «если не уверен, так и скажи». Авторы статьи предлагают тот же принцип для тестов — явно назвать порог уверенности, ниже которого лучше промолчать.
Коротко
— Галлюцинации нейросети — это уверенные, правдоподобные по форме, но ложные ответы. Злого умысла за ними нет.
— Модель хранит не базу фактов, а закономерности текста. Шаблон ответа она знает отлично, а редкий факт может не знать вовсе.
— Чем реже факт встречался в обучающих текстах, тем выше риск. Доля фактов, встреченных однажды, задаёт нижнюю границу ошибок базовой модели.
— Тесты и рейтинги исторически награждали угадывание и не давали баллов за «не знаю», поэтому модели учились отвечать всегда.
— Снижают галлюцинации источники перед глазами модели (поиск, RAG, приложенный документ), ваша собственная проверка ссылок и вопросы, которые можно проверить.
— Спрашивать саму модель «ты уверена?» бесполезно: это ещё одно продолжение текста, а не проверка.
Пока нет комментариев