
Привет, это Profile — я тут объясняю, как устроен искусственный интеллект, без тумана и умных слов. Сегодня разберём, что вообще значит «обучить» нейросеть. Если совсем коротко: обучить ИИ — это не вписать ему правила на каждый случай жизни, а показать гору примеров и дать ему самому подстроиться под них. Внутри у сети — миллионы, а у больших моделей миллиарды числовых «ручек», их называют весами. Сеть делает догадку, сравнивает её с правильным ответом, замечает ошибку и чуть-чуть поворачивает все ручки туда, где ошибка меньше. Повторите этот цикл миллиарды раз на огромных данных — и получится модель, которая отвечает осмысленно. Всё остальное — детали этого простого круга.
«Обучить» — это не «запрограммировать»
Первое, что сбивает с толку: мы говорим «обучили ИИ» так же, как «написали программу». Но это принципиально разные вещи. Обычную программу человек пишет правилами: если пользователь нажал кнопку — сделай то-то. Каждый случай расписан заранее. Так в прошлом веке пытались делать и «умные» системы: эксперты вручную задавали тысячи правил вида «если на картинке есть усы, острые уши и хвост — это кот». Получалось хрупко: стоит коту отвернуться или лечь — и правила рассыпаются. Перечислить все варианты реального мира невозможно.
Нейросеть идёт другим путём. Ей не пишут правило «как выглядит кот». Ей показывают тысячи фотографий, помеченных «кот» и «не кот», а дальше сеть сама нащупывает признаки. Внутри она состоит из простых элементов — искусственных «нейронов», соединённых связями. У каждой связи есть вес: число, которое говорит, насколько сильно один нейрон влияет на другой. Именно эти веса и есть то, что меняется при обучении. Никакой человек не выставляет их вручную — их слишком много. Задача обучения — найти такой набор весов, при котором сеть на примерах почти не ошибается.
Один шаг обучения: догадка → ошибка → поворот ручек
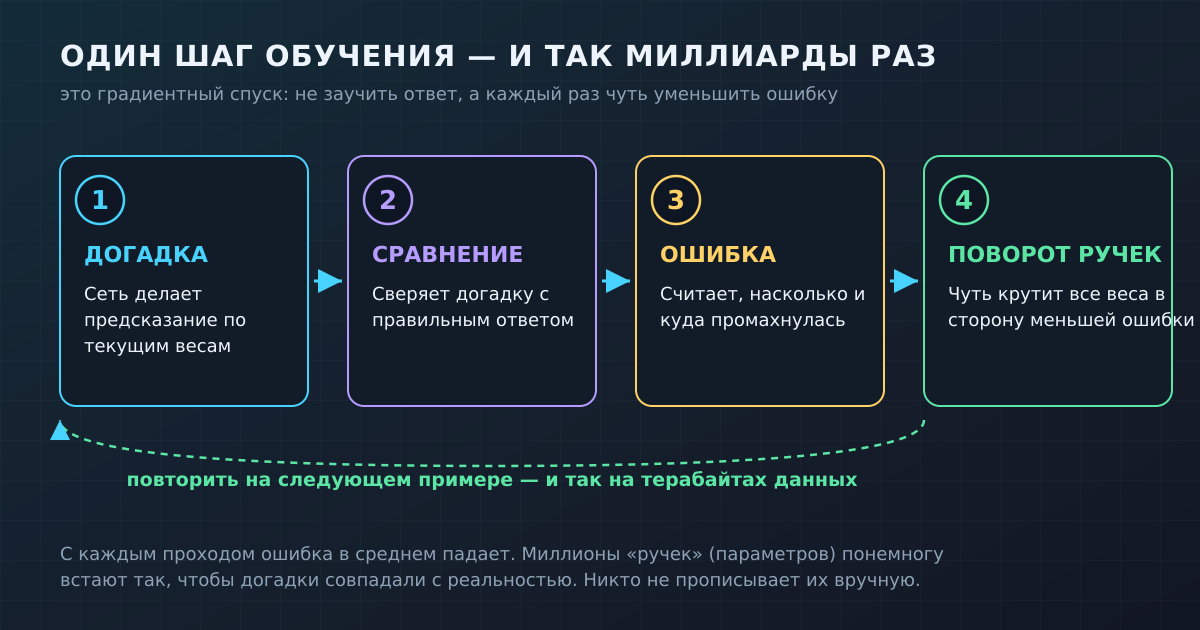
Теперь главное — как именно крутятся эти ручки. Представьте сеть с какими-то случайными весами в самом начале. Вы даёте ей пример (скажем, фото) и спрашиваете: кот или нет? Сеть выдаёт догадку — поначалу почти наугад. Вы сравниваете её ответ с правильным и считаете ошибку: насколько и в какую сторону сеть промахнулась. А дальше происходит магия, которая на самом деле — обычная математика: сеть вычисляет, как надо чуть-чуть подвинуть каждый вес, чтобы на этом примере ошибка стала меньше. И делает маленький шаг в эту сторону.
Этот приём называют градиентным спуском: представьте, что ошибка — это рельеф с холмами и ямами, а сеть вслепую нащупывает, куда наклон ведёт вниз, и делает шажок туда. Хорошая аналогия — настройка старого радиоприёмника: вы крутите ручку чуть вправо, слышите, что шумит сильнее, крутите обратно и ловите станцию. Только у сети таких ручек не одна, а миллионы, и крутит она их все сразу и очень маленькими долями. А способ быстро посчитать нужную поправку сразу для всех слоёв сети называется обратным распространением ошибки (backpropagation): поправка как бы «протекает» от выхода обратно к входу. Это не новая мода: метод описали ещё в 1986 году в журнале Nature Румельхарт, Хинтон и Уильямс. Один шаг почти ничего не меняет. Но таких шагов — миллиарды, на терабайтах примеров. И постепенно случайный набор весов превращается в сеть, которая угадывает уверенно.
Почему языковые модели учатся «угадывать следующее слово»
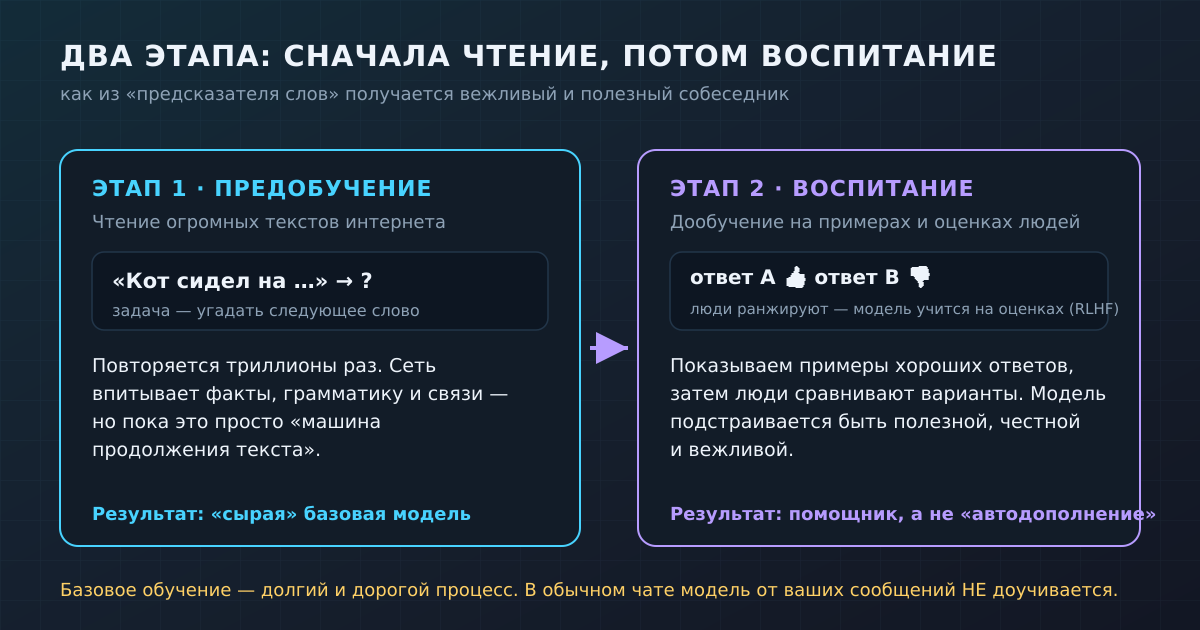
С текстовыми моделями — теми, что стоят за чат-ботами, — ровно та же механика, но с хитрой постановкой задачи. Чему их учат? Казалось бы, они должны «знать ответы». На деле основная тренировка проще некуда: предскажи следующее слово. Модели дают кусок текста — «Кот сидел на...» — и просят угадать, что идёт дальше. Она делает догадку, сверяется с реальным продолжением, считает ошибку, крутит веса. И так на гигантском объёме текстов интернета — книгах, статьях, форумах.
Звучит скромно, но у этой задачи есть побочный эффект. Чтобы хорошо угадывать следующее слово в миллионах разных текстов, приходится «впитать» грамматику, факты, устойчивые связи между понятиями и даже стиль рассуждений. Как объясняют в обзорной статье в Nature Ян Лекун, Йошуа Бенжио и Джеффри Хинтон — три исследователя, которых называют крёстными отцами глубокого обучения, — сеть из множества слоёв сама выстраивает всё более абстрактные представления о данных. Отсюда же, кстати, растут и слабости: модель, натренированная «продолжать текст», не считает в столбик, а именно угадывает правдоподобное — поэтому и ошибается там, где человек просто посчитал бы. Про это у нас есть отдельный разбор — почему ИИ ошибается в простой математике.
Второй этап — воспитание: примеры и человеческие оценки
После такого «чтения интернета» получается, честно говоря, не собеседник, а машина продолжения текста. Она может продолжить ваш вопрос ещё десятью похожими вопросами — просто потому, что в интернете так часто бывает. Чтобы из этого вышел вежливый и полезный помощник, модель дообучают на втором этапе. Сначала показывают примеры хороших ответов, написанных людьми: вот так надо отвечать на просьбу. А потом — самое интересное: людям дают несколько вариантов ответа модели, и те отмечают, какой лучше. Модель подстраивается выдавать то, что люди оценивают выше.
Этот приём называют обучением с обратной связью от человека (RLHF). В 2022 году исследователи OpenAI показали в работе про InstructGPT, что небольшая модель, аккуратно «воспитанная» на человеческих оценках, нравится людям больше, чем модель в сто с лишним раз крупнее, но без такого дообучения. То есть дело не только в размере: важно, как модель причесали после базового обучения. Именно второй этап делает ответы вежливыми, более честными и менее токсичными. И именно он стоит за ощущением, что с моделью «можно нормально поговорить».
Главный «ага»-момент: ИИ не достаёт ответы из базы
Вот ключевая мысль, ради которой всё и затевалось. Легко вообразить, что внутри ИИ — огромная база с готовыми ответами, и он просто ищет подходящий. Это не так. Внутри нет текстов и нет «ответов» — есть только настроенные веса, те самые миллионы ручек. Когда вы задаёте вопрос, модель не достаёт заготовку, а заново считает ответ, прогоняя ваш запрос через свои веса. Поэтому она может отвечать на то, чего дословно никогда не видела: она уловила закономерности, а не заучила фразы.
У той же медали есть обратная сторона. Раз модель не хранит фактов, а восстанавливает правдоподобное по закономерностям, она иногда уверенно выдаёт то, чего не было, — это и называют «галлюцинациями». Это не баг-опечатка, а прямое следствие того, как устроено обучение: модель всегда выдаёт самое похожее на правду продолжение, а не проверенный факт. Есть и ещё одна ловушка — переобучение: если модель слишком долго и слишком буквально заучивает тренировочные примеры, она начинает «зубрить», а не обобщать. На знакомом она отвечает идеально, а на новом плывёт — как студент, вызубривший билеты, но не понявший предмет. Поэтому инженеры специально придерживают обучение и проверяют модель на данных, которых она не видела. Хорошее обучение — это всегда баланс между «запомнить» и «понять общий принцип».
Больше данных и параметров — значит умнее? До предела
Вы наверняка слышали: «в новой модели триллион параметров». Параметры — это и есть те самые веса, ручки настройки. Грубое правило последних лет: больше качественных данных и больше параметров — модель в среднем умнее и реже ошибается. Поэтому индустрия и гналась за размером: сети росли от миллионов параметров к сотням миллиардов. Отчасти это честно работает — у крупной сети больше «места», чтобы ухватить тонкие закономерности.
Но «больше» не бесконечно превращается в «умнее». Во-первых, упираемся в данные: хорошего текста в мире конечное количество, и мусор на входе портит модель. Во-вторых, гигантские модели дорого обучать и тяжело запускать — не каждому нужен такой монстр ради простых задач. Поэтому сегодня в ходу и компактные модели, которые при аккуратном обучении работают на удивление бойко и даже запускаются прямо на домашнем компьютере. Выбор модели под задачу — отдельное умение; если интересно, у нас есть разбор, как не гнаться за самой большой моделью, а брать подходящую.
Три мифа, которые пора отпустить
Миф 1: «ИИ программируют правилами на каждый случай». Нет. Современный ИИ учится на примерах и сам настраивает веса — никто не прописывает «что делать, если спросят про погоду». В этом его сила (справляется с тем, чего не предусмотрели) и слабость (иногда делает совсем не то).
Миф 2: «ИИ понимает мир, как человек». Он находит статистические закономерности в данных и очень ловко их продолжает. Это невероятно полезно, но это не человеческое понимание со смыслом и намерением. Поэтому модель может блестяще рассуждать и тут же выдать уверенную чушь — для неё и то и другое просто «правдоподобное продолжение».
Миф 3: «Обученную модель легко переучить одной фразой». Базовое обучение — это долгий и очень дорогой процесс на кластерах видеокарт, а не то, что меняется от одного сообщения. Когда вы пишете в чат, модель не «доучивается» на ваших словах: ваше сообщение влияет только на текущий ответ, но веса остаются прежними. Например, наш Schai GPT работает на готовых больших моделях и подбирает под задачу нужные инструменты — он тоже не меняет свои веса от того, что вы ему написали. Память о вас (если она есть) — это отдельная заметка рядом с моделью, а не переобучение самой сети.
Коротко
• Обучить ИИ — не задать правила, а показать примеры. Сеть сама настраивает миллионы «ручек»-весов.
• Механизм один: догадка → сравнение с ответом → ошибка → маленький поворот всех весов. Повторить миллиарды раз (градиентный спуск + обратное распространение ошибки).
• Языковые модели учатся угадывать следующее слово на текстах интернета, а потом их «воспитывают» на примерах и человеческих оценках (RLHF).
• ИИ не достаёт ответы из базы — он их пересчитывает по весам. Поэтому отвечает на новое, но поэтому же «выдумывает».
• Больше данных и параметров ≈ умнее, но до предела: упираемся в объём данных и стоимость.
• В чате модель не доучивается от вашего сообщения — базовое обучение это отдельный большой процесс.
Пока нет комментариев