Почему ИИ ошибается в простой математике: умная нейросеть, которая путается в числах

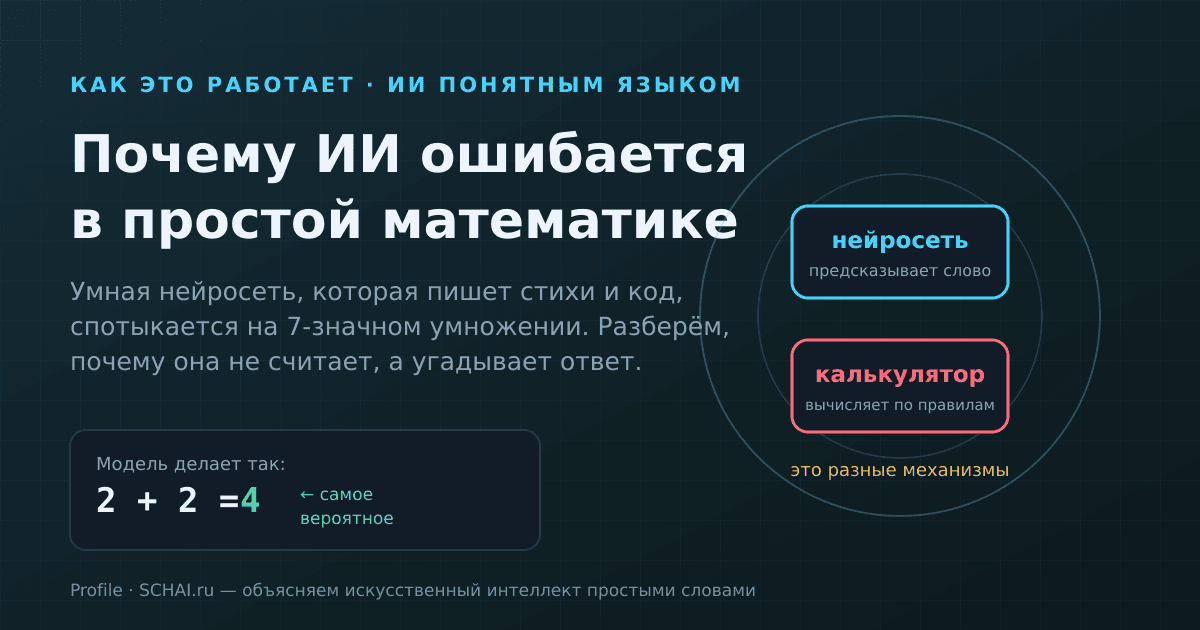
Если коротко: современная языковая модель (та самая, что стоит за чат-ботами) не считает как калькулятор. Она не применяет правила арифметики, а подбирает самое правдоподобное продолжение текста — буквально угадывает, какое слово или цифра должны стоять следующими. На «2 + 2» это почти всегда «4», потому что такую фразу она видела миллионы раз. А на «738 × 491» угадывать уже негде — и она ошибается. Это не глупость и не поломка: модель создана для языка, а не для цифр.
На связи Profile — мы на SCHAI.ru разбираем искусственный интеллект простым языком, без магии и без снисходительного тона. Сегодня тема, которая многих искренне злит: как нейросеть, пишущая стихи, код и дипломы, умудряется напутать в школьном примере. Давайте заглянем внутрь — и всё встанет на свои места.
«Компьютер — значит считает точно»? Здесь это не работает
Первая ловушка — в слове «компьютер». Мы привыкли, что машина = точный счёт: калькулятор не ошибается в умножении никогда. Поэтому кажется, что уж ИИ-то должен считать идеально. Но языковая модель устроена принципиально иначе, чем калькулятор. Калькулятор — это жёсткий набор правил: взять два числа, сложить по разрядам, выдать результат. Нейросеть правил сложения не хранит вообще. Внутри у неё — гигантская статистика о том, какие кусочки текста обычно идут друг за другом.
Представьте человека, который наизусть знает тысячи разговоров, но никогда не учил таблицу умножения. Спросите его «сколько будет шестью семь» — и он, скорее всего, ответит «сорок два», потому что слышал эту фразу сотни раз. А вот «сколько будет 613 умножить на 274» он не слышал ни разу — и начнёт наугад называть похоже выглядящее число. Модель ведёт себя ровно так же. Она отвечает не потому, что посчитала, а потому, что такой ответ выглядит вероятным.
И вот первое «ага»: когда ИИ выдаёт «42», он не проверяет этот результат арифметикой. У него в принципе нет шага «а теперь посчитаю и удостоверюсь». Есть только один шаг — «какое продолжение выглядит самым естественным». Для нас это непривычно: мы-то, называя ответ примера, где-то в глубине всё-таки опираемся на правило. Модель не опирается ни на какое правило сложения — его просто нет в её устройстве. Она целиком живёт в мире вероятностей текста.
Как языковая модель на самом деле выдаёт ответ
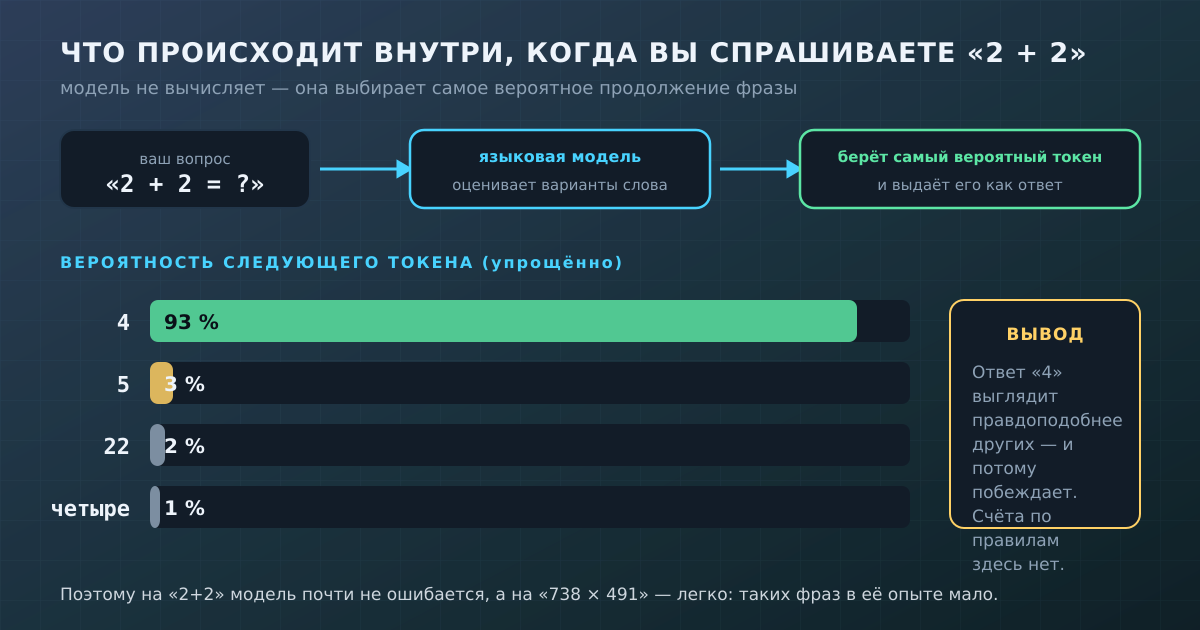
Внутри всё крутится вокруг одного действия — предсказания следующего токена. Токен — это кусочек текста: иногда целое слово, иногда часть слова, иногда отдельная цифра или пара цифр. Модель получает ваш вопрос, разбивает его на токены и прикидывает: какой токен вероятнее всего идёт дальше? У каждого варианта — своя вероятность. Дальше она берёт самый вероятный (или почти самый) и приписывает его к ответу. Потом повторяет всё заново — токен за токеном, как будто достраивает фразу по одному слову.
Вот почему на простых примерах ИИ почти не ошибается. «2 + 2 =» — продолжение «4» встречалось в текстах бесчисленное число раз, его вероятность огромна, конкурентов нет. А на «738 × 491 =» правдоподобных кандидатов множество, и ни один из них модель «не видела» достаточно часто, чтобы уверенно выбрать. Она выдаёт что-то похожее на правду по форме — нужной длины, с нужными цифрами на концах — но неверное по сути. Та же механика лежит в основе всего, что делают нейросети; мы подробно разбирали её на примере музыки в материале как нейросеть сочиняет музыку — там модель точно так же «достраивает» наиболее вероятную ноту.
Почему ломаются большие числа и «сколько букв „р“ в слове»
Теперь самое интересное — про токены и цифры. Казалось бы, число 4917 — это четыре разряда: тысячи, сотни, десятки, единицы. Но модель видит его не так. Токенизатор может нарезать это число как угодно: «49» и «17», или «4» и «917», или ещё как-то — границы токенов зависят от того, как часто такие кусочки встречались при обучении, а не от разрядов. В результате у модели нет чистого, «поразрядного» представления числа, с которым удобно складывать и умножать. Исследователи прямо показали: способ записи числа сильно влияет на то, насколько хорошо модель справляется с арифметикой — на обычной токенизации даже пятизначное сложение даётся с трудом.
Отсюда же растут знаменитые провалы вроде «сколько букв „р“ в слове „арбитраж“». Человек видит отдельные буквы и просто пересчитывает их. Модель же видит не буквы, а токены — крупные куски слова. Отдельные буквы внутри токена для неё не «разложены», поэтому честно пересчитать их она не может и снова угадывает. Это тот же корень, что и с цифрами: там, где нам нужна точная работа с мелкими символами, токенизация «замыливает» картинку.
Полезно держать в голове такую картину: для нас цифры и буквы — это атомы, которые мы перебираем по одному. Для модели атом — это токен, кусок покрупнее, и что там внутри, она «подробно не разглядывает». Поэтому задачи, где надо аккуратно пройтись по каждому символу — пересчитать буквы, перевернуть слово задом наперёд, сложить длинные числа разряд за разрядом, — даются ей труднее всего. Не потому что они сложные для нас, а потому что они устроены против её природы.
Нет черновика: почему длинное сложение рассыпается
Есть и вторая причина, помимо токенов. Когда мы складываем 4917 и 2688 в столбик, мы держим в голове переносы: сложили единицы, запомнили перенос, перешли к десяткам, и так далее. Это пошаговая работа с промежуточными записями — черновик. У модели по умолчанию такого черновика нет. Если попросить её сразу выдать ответ, она генерирует его «одним махом», не раскладывая на шаги, без места, где можно аккуратно провести переносы. Для короткого примера это проходит, для длинного — почти гарантированно накапливается ошибка.
Грубая аналогия: попросите человека перемножить два трёхзначных числа в уме и мгновенно, не давая ни секунды подумать и ни клочка бумаги. Большинство ошибётся — не потому что глупые, а потому что задача требует промежуточных записей, которых не дали сделать. Модель по умолчанию всегда в таком режиме «отвечай немедленно, без бумаги».
Сложите две причины вместе — и картина складывается полностью. Числа модель видит не по разрядам, а крупными токенами, и держать их «в столбик» ей неудобно. Плюс у неё нет места под переносы и промежуточные шаги. Неудивительно, что на длинной арифметике она спотыкается: это сочетание неудобного представления чисел и запрета на черновик. А простые примеры проходят лишь потому, что ответ на них она, по сути, помнит целиком, а не вычисляет.
Что реально помогает: рассуждать по шагам и звать калькулятор
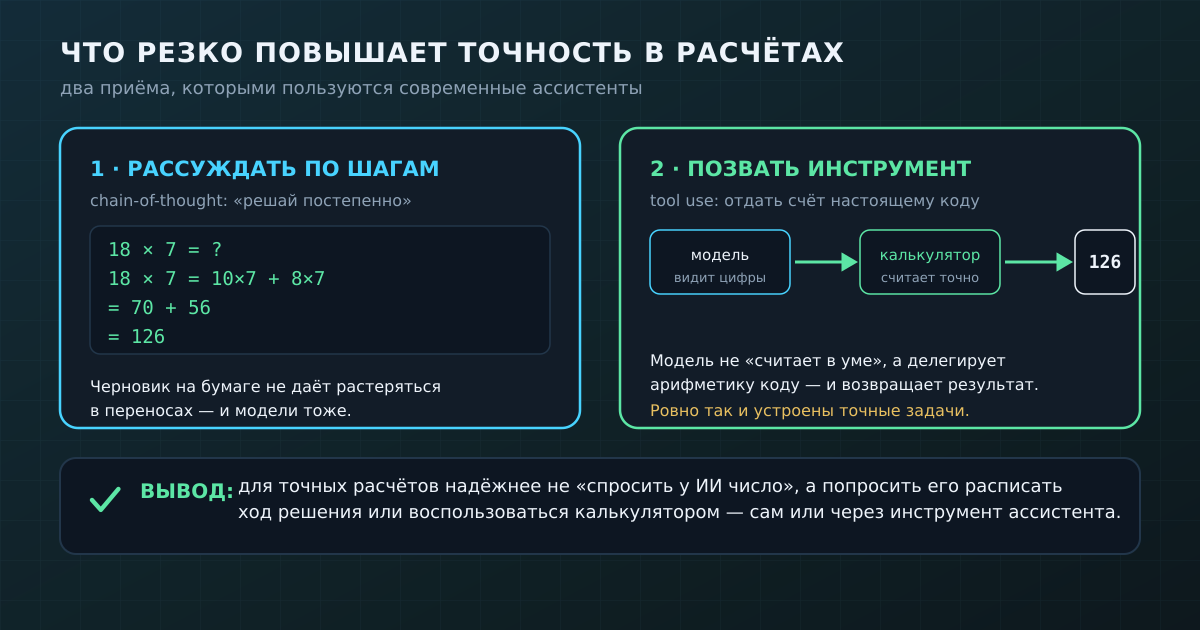
Хорошая новость: раз мы понимаем причину, понятно и лекарство. Первый приём — попросить модель рассуждать по шагам. Если вместо «дай ответ» сказать «решай постепенно, распиши ход», точность на арифметике и логике резко вырастает. Это не фокус, а подтверждённый эффект: в работе Google, которая ввела термин chain-of-thought, показано, что пошаговые рассуждения заметно повышают результат на арифметических и логических задачах. По сути мы разрешаем модели вести тот самый черновик прямо в тексте ответа — и переносы перестают теряться.
Второй приём мощнее — дать модели настоящий инструмент. Зачем нейросети угадывать произведение, если рядом есть калькулятор или кусок кода, который посчитает точно? Современные ассистенты так и устроены: модель распознаёт, что перед ней расчёт, вызывает внешний инструмент, передаёт ему числа и возвращает готовый результат. Идею, что языковая модель может сама научиться вовремя звать внешние инструменты — калькулятор, поиск, календарь — ввела работа Toolformer, где модель учится вызывать инструменты и подставлять их ответы. Именно поэтому для точных задач серьёзные ассистенты не считают «в уме», а делегируют счёт коду.
На нашем сервисе Schai GPT платные модели работают через такой же реестр инструментов: модель сама решает, вызвать ли поиск, карточку товара, статистику сайта или другой инструмент, вместо того чтобы отвечать «из головы». Это ровно тот подход, о котором речь, — модель не притворяется калькулятором, а поручает специализированную задачу тому, кто сделает её точно. Как выбирать модель под конкретную задачу, мы разбирали в тексте гонка ИИ-моделей: как выбирать модель под задачу, а про то, где инструменты экономят время, а где создают риск, — в материале про ИИ-агентов в работе.
Три мифа, из-за которых злятся на ИИ
Миф 1: «Компьютер — значит считает точно». Калькулятор — да. Языковая модель — нет: это не вычислитель, а генератор правдоподобного текста. Ошибка в умножении для неё так же естественна, как для нас — забыть, в каком году была какая-то малоизвестная битва. Не тот инструмент для этой работы.
Миф 2: «Ошибся в счёте — значит глупый». Модель, которая пишет связный код и переводит тексты, не может быть «глупой» в бытовом смысле. Просто её сила — язык и закономерности, а не арифметика. Оценивать её по устному счёту — всё равно что судить о поэте по тому, как быстро он перемножает в уме шестизначные числа.
Миф 3: «Раз ошибается в математике — ему вообще нельзя доверять». Тоже перебор. Доверять можно там, где модель играет по своим сильным сторонам, и особенно — когда она подкреплена инструментами и проверкой. Расчёт поручите калькулятору (или попросите ИИ им воспользоваться), факты перепроверьте по источникам, а формулировки, черновики, идеи и разбор текста спокойно оставьте нейросети. Вопрос не в «доверять или нет», а в том, под какую задачу вы её берёте.
Коротко
• Языковая модель предсказывает следующий токен, а не вычисляет по правилам: она выдаёт самый правдоподобный ответ, а не посчитанный.
• Числа режутся на токены не по разрядам, поэтому у модели нет удобного «поразрядного» представления — отсюда ошибки в больших умножениях и в подсчёте букв.
• По умолчанию у модели нет черновика: длинные вычисления с переносами она генерирует одним махом и накапливает ошибку.
• Резко помогают два приёма: рассуждение по шагам (chain-of-thought) и вызов настоящего инструмента (калькулятора или кода).
• Поэтому «ИИ ошибся в математике» — не признак глупости и не повод не доверять ему вовсе. Это повод давать ему правильные задачи и правильные инструменты. Больше таких разборов простым языком — на главной SCHAI.ru.
Пока нет комментариев