Если коротко: у нейросети нет памяти в человеческом смысле. При каждом ответе ей заново показывают всё, что помещается в «окно контекста», — историю чата, ваши файлы и её собственные прошлые ответы. Что не поместилось или потеряло вес внутри длинного текста, для модели просто не существует. Поэтому ИИ «забывает» не как человек, а как лист бумаги, на который больше ничего не влезает.
Меня зовут Кира Нейман, я пишу про нейросети по-человечески, и это один из вопросов, которые мне задают чаще всего: «Я же три часа назад ему всё объяснил — почему он спрашивает снова?» Ниже без магии: что такое окно, как оно заполняется, почему длинный разговор портится и что с этим делать.
Что такое окно контекста
Документация Anthropic определяет окно контекста как весь текст, на который языковая модель может опираться при генерации ответа, включая сам ответ. Это «рабочая память» модели, а не то, чему её учили: данные обучения и контекст разговора — разные вещи. Всё, что вы написали, всё, что ответила модель, прикреплённые документы и инструкции системы — всё это делит одно пространство.
Измеряют окно в токенах — кусочках текста, на которые модель режет слова. Токен — это не слово и не буква: короткое слово бывает одним токеном, длинное и редкое — несколькими. Для русского языка токенов на слово обычно уходит больше, чем для английского, поэтому на русском окно «кончается» быстрее, чем кажется по числу страниц. Точный размер зависит от конкретной модели и тарифа: у разных моделей он разный, и узнавать его надо в описании самой модели.
Почему модель «забывает»: она ничего и не помнила
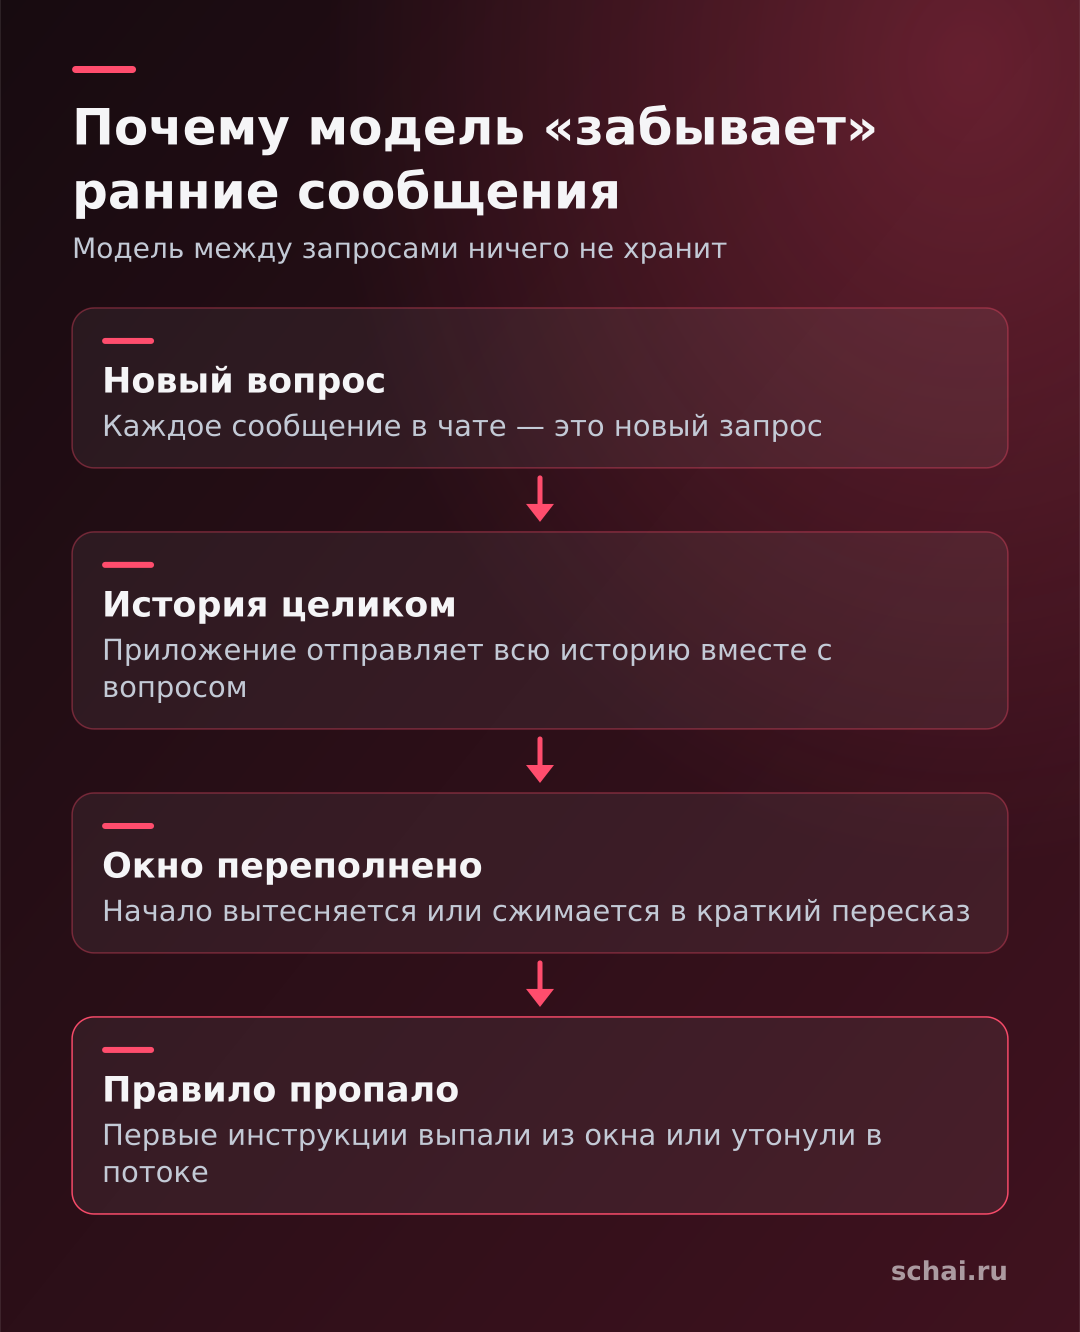
Каждый ваш новый вопрос в чате — это новый запрос. Приложение берёт историю разговора и отправляет её целиком вместе с новым сообщением. По документации, на каждом шаге ввод включает всю предыдущую историю плюс текущее сообщение, а ответ модели становится частью ввода для следующего шага. Модель между запросами ничего не хранит; «память» — это текст, который приложение каждый раз подкладывает обратно.
Отсюда три следствия. Первое: когда история перестаёт помещаться, что-то нужно выбросить или сжать. Как сказано в документации, чат-интерфейсы могут управлять окном по принципу «первым пришёл — первым ушёл», то есть начало разговора вытесняется, а вместе с ним и ваши первые инструкции. Второе: приложение может заранее сжимать историю в краткий пересказ — и в пересказе детали теряются. Третье: если вы дали правило в самом начале и оно перестало выполняться, это не обида модели, а признак того, что правило уже выпало из окна или утонуло в потоке.
Окно большое, но внимание не бесконечное
Казалось бы, если окна сегодня измеряются сотнями тысяч токенов, проблема решена. Не совсем. В той же документации прямо сказано: больше контекста — не всегда лучше; с ростом числа токенов точность и полнота извлечения падают, и это явление называют «гниением контекста» (context rot). Поэтому важно не только сколько влезло, но и что именно лежит в окне.
Это подтверждается исследованиями. В статье «Lost in the Middle» Нельсон Лю с соавторами проверили, как модели используют длинный контекст на задачах ответов по нескольким документам и поиска значения по ключу. Результат: качество выше всего, когда нужная информация находится в начале или в конце ввода, и заметно падает, когда она в середине; кроме того, чем длиннее ввод, тем хуже результаты даже у моделей, заявленных как «длинноконтекстные». Авторы делают вывод, что модели того времени не вполне надёжно используют информацию из длинного контекста. С тех пор модели улучшились, но сам механизм — повод для осторожности.
Из чего складывается заполнение окна
Многие думают, что окно занимают только их сообщения. На деле в нём лежит гораздо больше. По документации Anthropic, в контекст входят системная инструкция, каждое сообщение разговора (включая результаты инструментов, изображения и документы), описания инструментов и сам сгенерированный ответ, в том числе рассуждения, если они включены. Загруженный PDF на сто страниц, длинная таблица или вставленный лог могут занять половину окна ещё до первого вопроса.
Именно поэтому в долгом рабочем диалоге ответы часто становятся хуже ближе к концу. Окно заполнено ранними промежуточными версиями текста, отвергнутыми вариантами и вашими исправлениями; модель вынуждена выбирать между противоречащими версиями одного и того же. Ей нужно не «подумать», а разобраться в куче собственных правок.
Пример: как окно заполняется за один вечер
Допустим, вы пишете с ассистентом сопроводительное письмо. Сначала вы вставляете резюме и текст вакансии — это уже несколько тысяч токенов. Затем модель предлагает черновик, вы просите переписать мягче, потом короче, потом «как в первой версии, но с вашим исправлением». К десятой реплике в окне лежат резюме, вакансия и десять версий письма. Когда вы просите «вернись к варианту номер три», модель должна найти его среди остальных похожих текстов — и нередко берёт фрагменты из соседней версии.
Решение в таком случае простое: сохраните лучшую версию отдельно, откройте новый чат, вставьте туда только резюме, вакансию и выбранный вариант, и просите правку одного абзаца. Окно будет почти пустым, а внимание модели — сосредоточенным на задаче. Так же работают инженерные приёмы в больших системах: старые результаты инструментов чистят, а длинные истории пересказывают, чтобы окно не превращалось в свалку.
Отдельно про тарифы и скорость. Чем больше окно занято, тем больше текста обрабатывается при каждом ответе, поэтому длинные разговоры чаще отвечают медленнее, а в платных API — стоят дороже, ведь счёт идёт по токенам ввода и вывода. Даже если лимит вас не беспокоит, короткий чистый контекст — это быстрее, дешевле и точнее.
Что делать на практике
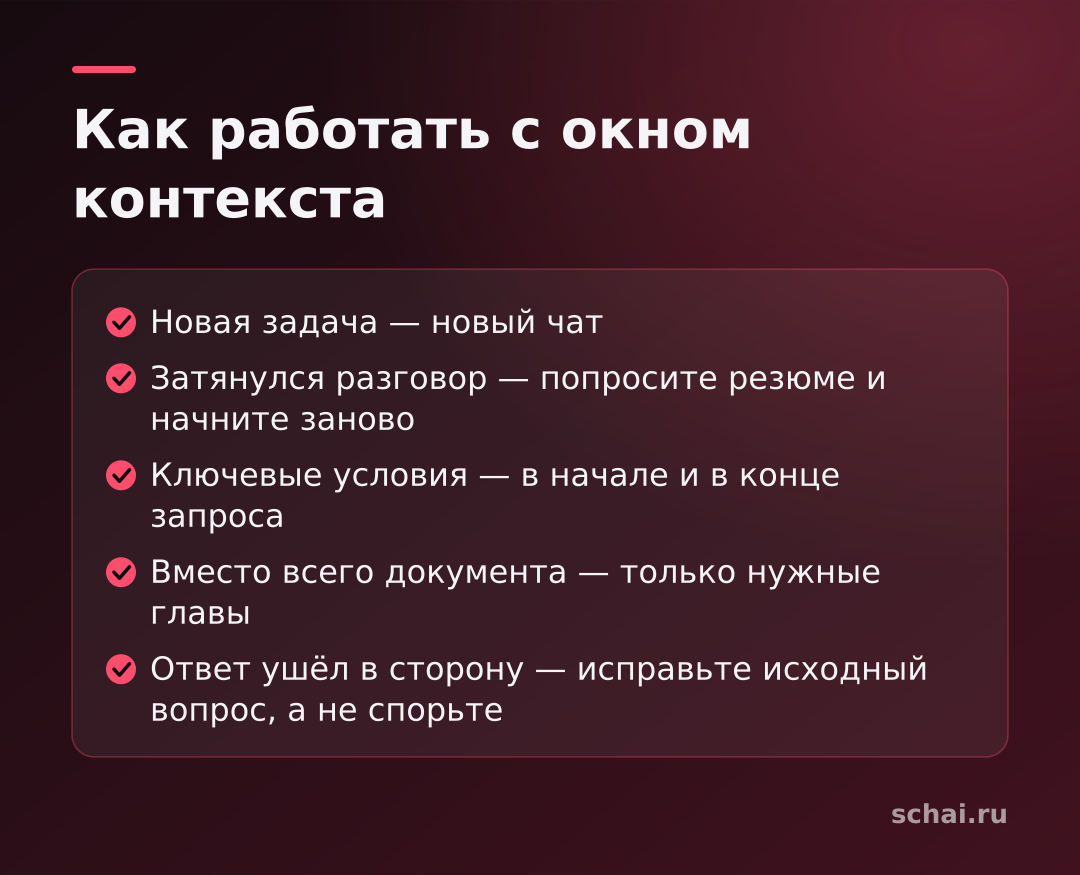
Начинайте новый чат на новую задачу. Это самый простой и самый недооценённый приём. Тематически разные разговоры в одном окне мешают друг другу.
Выносите главное в короткую выжимку. Если разговор затянулся, попросите модель составить краткое резюме решений, ограничений и принятых правил и начните новый чат с него. Вы сами решаете, что сохранить, а не отдаёте это на откуп автоматическому сжатию.
Ключевое ставьте в начало или конец. С учётом эффекта «потерянной середины» важные условия лучше формулировать в начале запроса и повторять в конце, а не прятать в середине длинного текста.
Не загружайте лишнее. Вместо всего документа дайте нужные главы. Меньше текста — меньше шансов, что модель зацепится за постороннее.
Исправляйте, а не спорьте. Если ответ ушёл в сторону, отредактируйте исходный вопрос и перезапустите, вместо того чтобы наращивать цепочку уточнений: каждая реплика спора остаётся в окне и тянет вниз.
Когда ИИ «помнит» между разговорами
Бывает и так, что ассистент помнит вас между чатами. Но это тоже не память модели: это отдельная функция приложения, которая сохраняет заметки и подкладывает их в новое окно. Как это устроено у нас, мы разбирали в статье «Память ИИ: что Schai GPT помнит о вас и что забывает». А если вас интересует, почему модель отвечает уверенно, даже когда деталей в окне уже нет, читайте про галлюцинации и проверку ответов.
Коротко
1. Окно контекста — это всё, что модель видит в момент ответа; вне окна для неё ничего нет.
2. Нейросеть не хранит разговор: приложение каждый раз отправляет историю заново, а при нехватке места сжимает или обрезает.
3. Большое окно не значит хорошее внимание: на длинных текстах качество падает, особенно для информации в середине.
4. Новая задача — новый чат; долгую работу сводите в короткое резюме.
5. Важное ставьте в начало и конец запроса и не загружайте лишнего.
Пока нет комментариев