Почему ИИ уверенно ошибается: как работают галлюцинации и как проверять ответы
Если коротко: языковая модель не «знает» и не «ищет» ответ, она подбирает правдоподобное продолжение текста. Когда фактов в её памяти не хватает, она всё равно что-то пишет, потому что обучение и тесты десятилетиями поощряли ответ, а не фразу «не знаю». Уверенный тон здесь ничего не доказывает: он свойство стиля, а не проверки. Поэтому проверять нужно факты — имена, даты, цифры, цитаты, ссылки, — а не интонацию.
Меня зовут Кира Нейман, я пишу про нейросети по-человечески. Вопрос «почему ИИ врёт и не краснеет» я слышу чаще всех. Ответ интереснее, чем «модель глупая»: ошибки во многом вытекают из того, как её учат и как оценивают.
Что на самом деле делает языковая модель
Модель обучается на огромных массивах текста и учится предсказывать, какое слово (точнее, фрагмент слова) вероятнее всего идёт дальше. Из этого простого механизма вырастают грамотные ответы, переводы и код. Но у него есть важное следствие: цель — правдоподобие текста, а не истинность. Фраза «Столица Австралии — Канберра» и фраза «Столица Австралии — Сидней» грамматически одинаково хороши. Верную выбирает не проверка по базе, а то, что в обучающих данных верное встречалось чаще и в похожих контекстах.
Для частых фактов это работает отлично. Для редких — хуже. Если человек упомянут в данных один-два раза, его день рождения для модели лишь статистический шум: схема фразы известна («родился в 1974 году»), а конкретная цифра размыта. Модель заполняет шаблон правдоподобным значением. Это и называют галлюцинацией: связный, уверенный и неверный текст.
Почему уверенность не означает знания
Уверенный тон — результат обучения на текстах, где люди пишут утвердительно. Статьи, учебники и энциклопедии редко содержат фразы вроде «кажется, примерно так, но я не уверен». Модель перенимает этот стиль. Кроме того, ответы дополнительно настраивают, чтобы они были полезными и понятными, а ответ в духе «не знаю» пользователи оценивают ниже.
Интересно, что внутри модель кое-что «понимает» о собственной неуверенности. В работе «Language Models (Mostly) Know What They Know» авторы показали, что крупные модели достаточно хорошо откалиброваны на вопросах с вариантами ответа и умеют оценивать вероятность того, что их собственный ответ верен. Правда, обобщение такой самооценки на незнакомые задачи у них слабое. То есть сигнал о сомнении в модели есть, но в обычном чате до вас он не доходит: вы видите готовый текст.
Как обучение и тесты поощряют угадывание
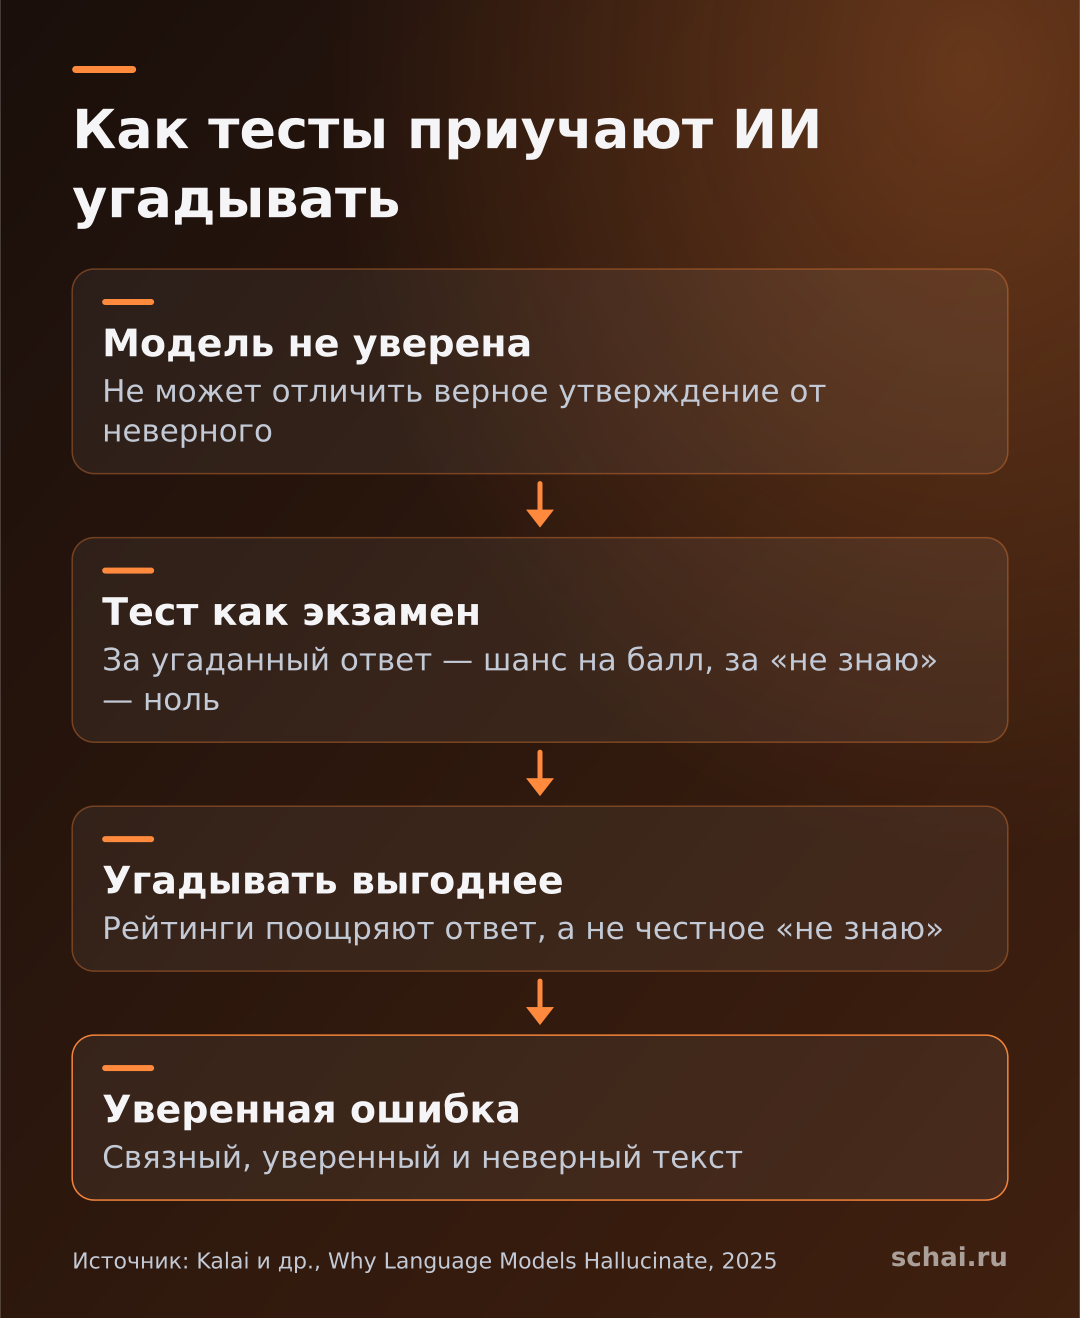
Самое наглядное объяснение дано в статье «Why Language Models Hallucinate» (Калаи, Начум, Вемпала и Чжан, сентябрь 2025 года). Авторы рассматривают галлюцинации как ошибки бинарной классификации: если модель не способна отличить неверное утверждение от верного, в ходе обучения у неё неизбежно появятся правдоподобные ошибки. А дальше, по их аргументации, ошибки закрепляются, потому что большинство тестов оценивает модель как ученика на экзамене: за угаданный ответ даётся шанс получить балл, а за «не знаю» — ноль.
Представьте экзамен с вариантами ответов без штрафа за неверный. Любой студент будет отмечать что-нибудь даже в вопросах, где не уверен, — иначе он проиграет тем, кто угадывает. Языковые модели оптимизируют именно такую систему. Авторы предлагают не создавать новые тесты на галлюцинации, а поменять подсчёт баллов в существующих рейтингах, чтобы уверенные ошибки штрафовались сильнее, чем честное признание неопределённости.
Где модель ошибается чаще всего
Закономерности понятны из механизма. Чаще страдают редкие факты: малоизвестные люди, местные организации, узкие термины. Страдают точные значения: даты, суммы, номера статей законов, версии программ. Опасны ссылки и цитаты: модель умеет составить правдоподобный адрес или название работы, которых не существует. И наконец, ошибки появляются в длинных рассуждениях, где небольшая неточность в начале тянет за собой ложный вывод.
Надёжнее модель работает там, где материал в данных частый и устоявшийся: объяснение понятий, пересказ известных идей, правка стиля, черновики. Это не значит, что там нет ошибок, но вероятность их ниже, и они обычно заметнее.
Как проверять ответы нейросети
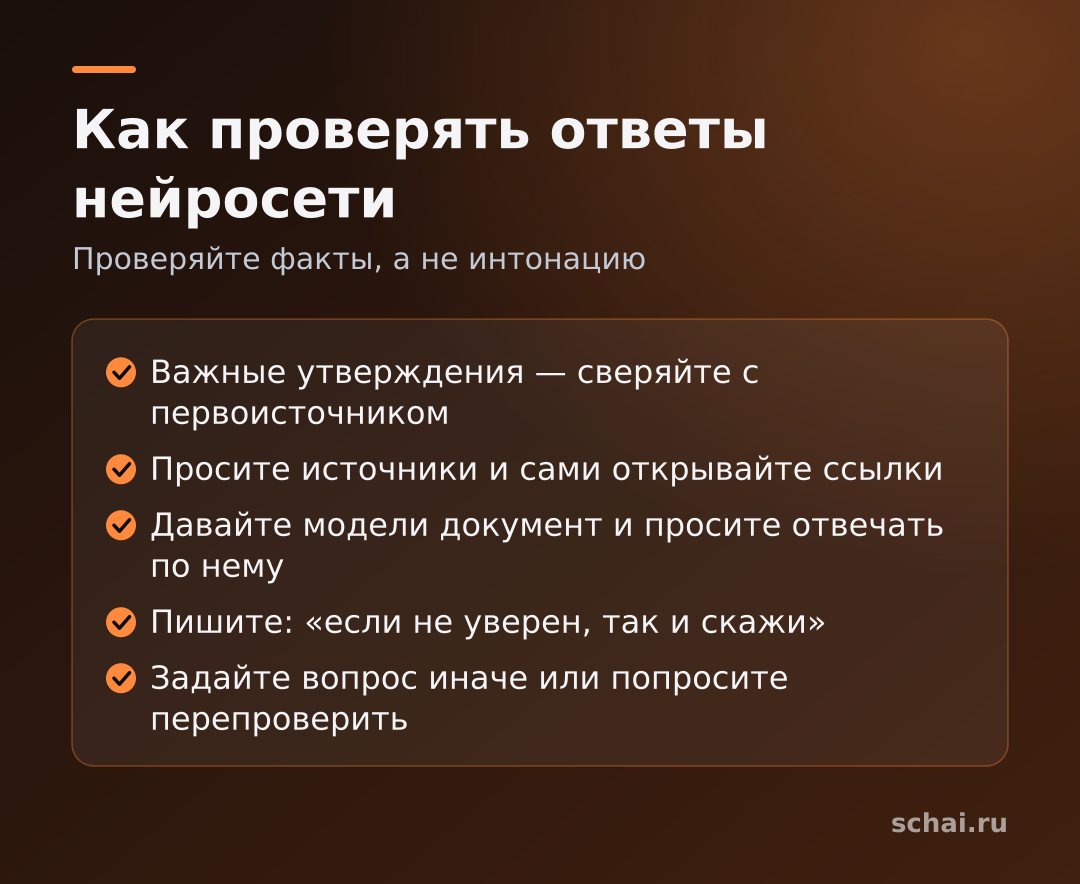
Разделяйте утверждения и проверяйте самые важные. Если от ответа зависят деньги, здоровье или юридические последствия, откройте первоисточник: сайт ведомства, документ, страницу производителя. Нейросеть здесь — помощник в поиске, а не судья.
Просите источники и открывайте их. Ссылку, которую выдала модель, нужно открыть самому: убедиться, что страница существует и действительно говорит то, что утверждается. Если адрес не открывается или текст на странице другой, ответ вымышлен.
Давайте модели материал. Если вы вставите в запрос нужный документ и попросите ответить только по нему, вероятность выдумки заметно падает, потому что часть информации теперь лежит прямо в контексте. Эту же логику подтверждают исследования: подсказки и исходный материал повышают долю верных ответов.
Разрешайте неопределённость. Добавьте в запрос фразу «если не уверен, так и скажи» и просите отделять установленные факты от предположений. Это не отменяет ошибок, но смещает поведение в нужную сторону.
Сверяйте с двух сторон. Задайте тот же вопрос иначе или попросите проверить собственный ответ. Если версии расходятся, перед вами повод открыть первоисточник.
Это исправят?
Модели становятся точнее, но полностью устранить галлюцинации, по логике той же статьи, нельзя, пока в данных есть факты, которые невозможно отличить от правдоподобных неправд, и пока оценки поощряют угадывание. Реалистичная цель — не «ИИ никогда не ошибается», а «ИИ чаще признаёт, что не знает, и подкрепляет сказанное источниками». А наша задача как пользователей — относиться к ответу как к черновику, а не как к справке.
Простой пример проверки
Допустим, вы спросили у нейросети, в каком году вышел малоизвестный фильм, и получили ответ с названием режиссёра. Проверьте за минуту: введите название фильма в поиск, откройте страницу в справочнике или на сайте студии и сравните год и имя. Если они не совпали, модель заполнила шаблон правдоподобными значениями. Для частых вопросов вроде столицы страны проверка почти не нужна, а для редких она обязательна. Привычка проверять именно редкое и точное экономит больше всего времени и не превращает работу с ИИ в бесконечное недоверие.
Коротко
1. Модель предсказывает правдоподобный текст, а не проверяет истину.
2. Уверенный тон — стиль, а не признак точности.
3. Тесты и обучение поощряют угадывание сильнее, чем честное «не знаю».
4. Рискуют имена, даты, цифры, цитаты и ссылки: их проверяем всегда.
5. Давайте модели исходный материал, разрешайте сомневаться и открывайте первоисточники.
Пока нет комментариев