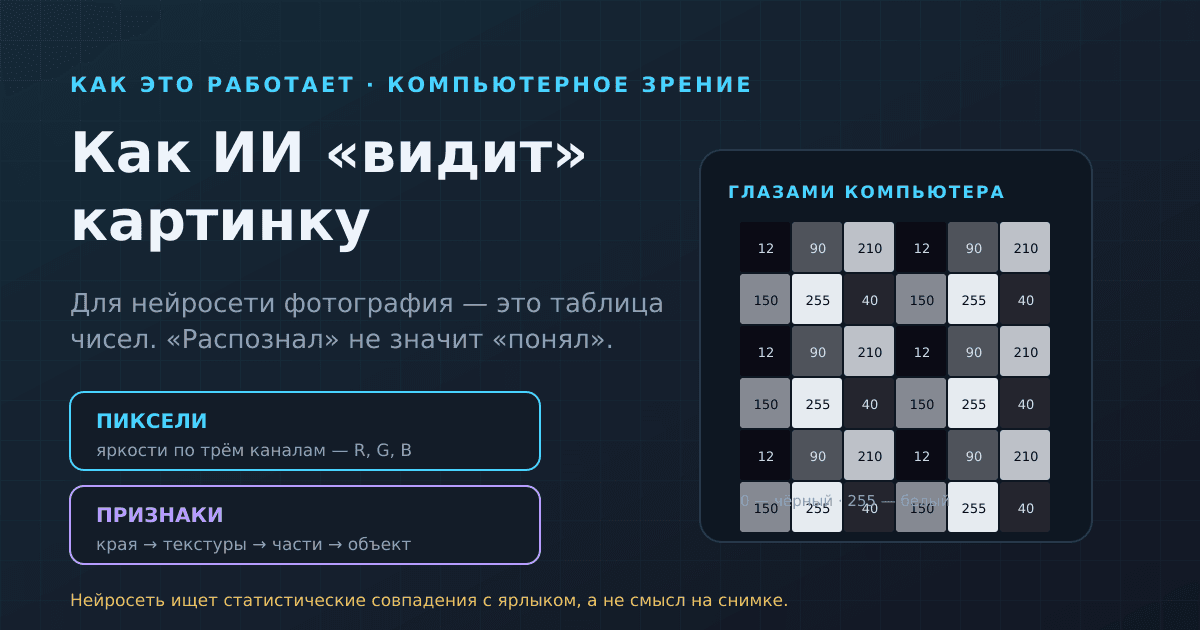

Если совсем коротко: нейросеть не «смотрит» на картинку так, как мы. Для неё фотография — это большая таблица чисел, яркости точек по трём каналам цвета. Сеть не видит кошку — она находит в этой таблице узор, который на тысячах обучающих примеров совпадал с ярлыком «кошка». Отсюда и сила (узнаёт за миллисекунды), и слабость (уверенно ошибается там, где человек бы и не задумался).
Привет, это Profile — я тут объясняю, как устроен ИИ, без магии и без заумных формул. Сегодня разберём, что реально происходит в момент, когда нейросеть «распознаёт» изображение: от сырых пикселей до слова-ответа. Будет механизм, пара честных «ага» и разбор мифов, которые давно пора отпустить.
Картинка для компьютера — это таблица чисел
Начнём с основы, без которой дальше ничего не сойдётся. Любое цифровое изображение состоит из пикселей — крошечных клеток. У каждой клетки есть яркость, и обычно не одна, а три: сколько в ней красного, зелёного и синего (те самые R, G, B). Каждое из этих значений — число, чаще всего от 0 (канал погашен) до 255 (на максимуме).
Значит, фотография 1000×1000 точек — это не «котик», а три таблицы по миллиону чисел каждая. Три миллиона значений, в которых нет ни слова «кошка», ни понятия «усы». Есть только числа и их расположение. Всё, что умеет делать нейросеть, она делает именно с этими числами: складывает, умножает, сравнивает соседние, ищет закономерности. Цвет, граница, пятно — для машины это перепады чисел, и ничего кроме.
Это первый важный сдвиг в голове: там, где мы видим сцену и сразу считываем смысл, компьютер видит матрицу. Весь фокус дальше — в том, как из этой матрицы постепенно вырастает ответ.
Заодно становится понятно, почему мелочи так влияют на результат. Сжали фотографию, добавили фильтр, чуть сдвинули яркость — числа в таблице изменились, пусть и незаметно для глаза. Для нас это та же картинка, для машины — уже немного другие данные. Эту хрупкость мы ещё увидим во всей красе чуть ниже.
Как сеть собирает смысл: лестница признаков
Главная идея компьютерного зрения — не описать кошку правилами («два уха, усы, хвост»), а дать сети гору размеченных примеров и позволить ей самой нащупать, что отличает одно от другого. Так работают свёрточные сети (их называют CNN) и пришедшие им на смену vision-трансформеры.
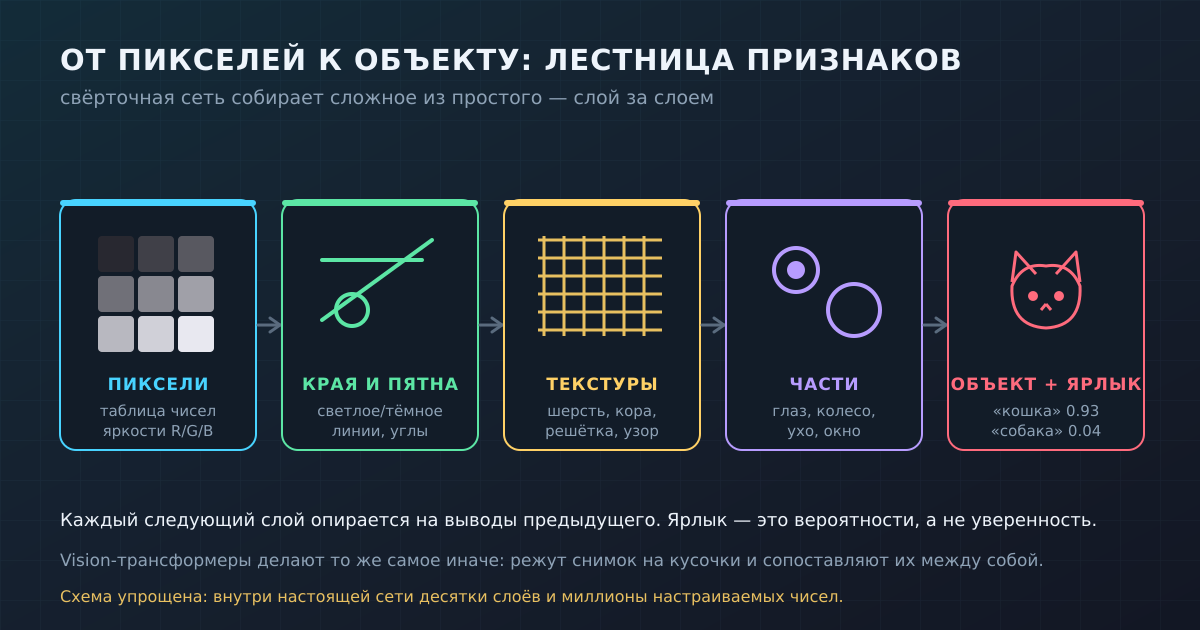
Устроено это лестницей. Первые слои сети смотрят на картинку локально, маленькими окошками, и учатся замечать самое простое: светлое рядом с тёмным, короткую линию, угол, пятно. Следующие слои собирают из этих линий и пятен штуки посложнее — текстуры: шерсть, кору дерева, решётку, сетку ткани. Ещё выше складываются части объектов: глаз, колесо, ухо, окно. И только на верхних слоях всё это соединяется в целое — «кошка», «машина», «лицо». От простого к сложному, снизу вверх — это и называют иерархией признаков.
Важная деталь: никто не писал сети «вот так выглядит шерсть». Она сама подобрала миллионы внутренних чисел-настроек так, чтобы на обучающих картинках как можно реже ошибаться. Перелом случился в 2012 году, когда свёрточная сеть AlexNet резко обошла прежние методы на большом наборе картинок ImageNet — эту работу Крижевского и коллег обычно и считают стартом нынешней волны. Vision-трансформеры добрались до того же другим путём: они режут снимок на кусочки-«патчи» и учатся сопоставлять их между собой, но принцип «от простого к сложному, по примерам» остаётся тем же.
И ещё: ответ сети — это не «да, кошка», а набор вероятностей. «Кошка» — 0.93, «собака» — 0.04, «лиса» — 0.01, и так далее. Мы просто берём самый высокий вариант и показываем его как ответ. Внутри же всегда живёт неуверенность — и это нам скоро пригодится.
Главное «ага»: статистика, а не понимание
Вот ключевая мысль всей статьи. Нейросеть не понимает, что такое кошка. У неё нет представления о том, что это живое тёплое существо, которое мяукает и боится пылесоса. Она нашла статистическую закономерность: определённые сочетания признаков в обучающих данных почти всегда шли вместе с ярлыком «кошка». И теперь, увидев похожий узор, она ставит высокую вероятность.
Это гениально экономно и поэтому так хорошо работает на типичных картинках. Но из этого же растут все странные ошибки. Сеть не ищет смысл — она ищет совпадение. Если в данных смысл и совпадение расходятся, машина спокойно пойдёт за совпадением, даже когда для человека ответ очевиден. Запомним формулу: «распознал» значит «нашёл знакомый узор», а не «понял, что это».
И это не придирка теоретиков. Именно из статистической природы растёт всё поведение таких систем — и удачи, и промахи. Хороший обзор того, как это работает в глубоком обучении, дали Лекун, Бенжио и Хинтон в своей программной статье: сеть не программируют правилами, а настраивают по данным, и качество ответа ровно настолько хорошо, насколько хороши и разнообразны эти данные.
Почему ИИ ошибается там, где человек бы не ошибся
Раз под капотом статистика, то и промахи у неё особенные — не такие, как у нас. Разберём три самых показательных.
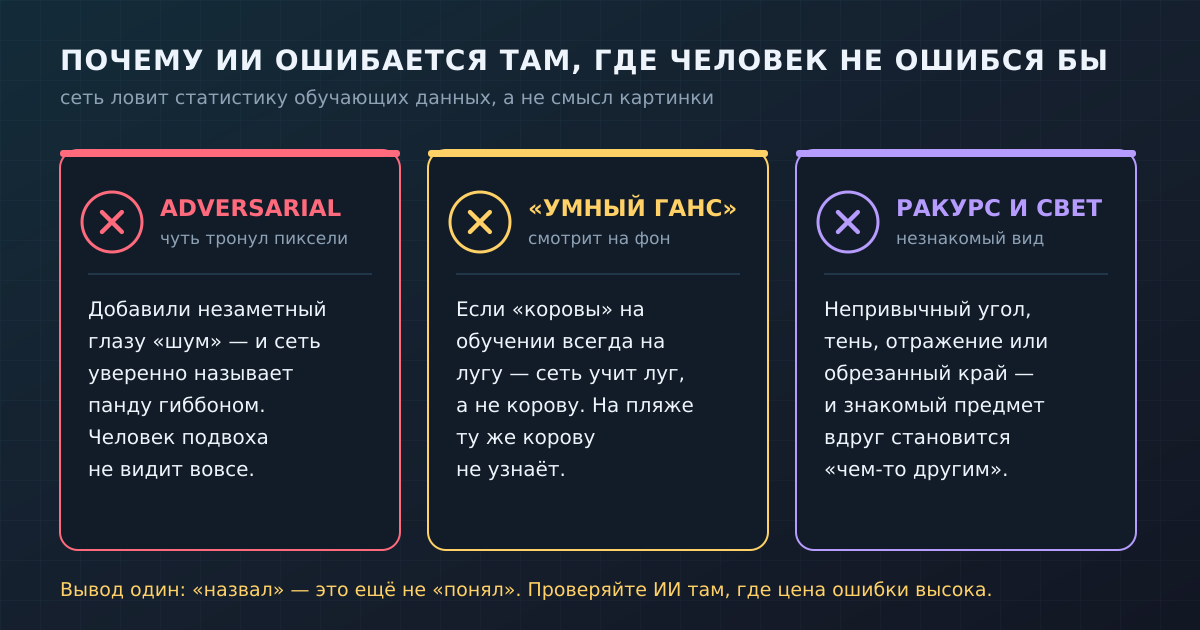
Еле заметный «шум» — и панда становится гиббоном
Это называют adversarial-примерами. Если к картинке аккуратно подмешать крошечные, незаметные глазу изменения яркости пикселей, сеть может уверенно назвать панду гиббоном, а знак «стоп» — ограничением скорости. Для нас две картинки неотличимы, для модели — это две разные точки в её пространстве чисел. Авторы классической работы про такие примеры показали, что это не случайный глюк, а свойство самого способа, которым сети принимают решения. Пугающая часть: такие «обманки» иногда переносятся с одной модели на другую.
«Умный Ганс»: сеть смотрит на фон, а не на объект
Был когда-то конь по кличке Умный Ганс, который будто бы считал в уме, а на деле считывал реакцию людей вокруг. Нейросети попадают в ту же ловушку. Если на всех обучающих фото коровы стоят на зелёном лугу, сеть вполне может выучить «луг», а не «корову» — и ту же корову на пляже уже не узнает. Исследователи называют это обучением на ярлыках-подсказках, или shortcut learning: модель хватается за самый простой признак, который случайно совпадал с ответом. Подробный разбор этого явления показывает, насколько часто сети решают задачу «не тем местом».
Непривычный ракурс, свет и контекст
Человек узнаёт чашку сверху, снизу, в тени, наполовину спрятанную за ноутбуком. Сети это даётся тяжелее: необычный угол, резкая тень, отражение, обрезанный край — и знакомый предмет вдруг «становится» чем-то другим. Причина всё та же: если таких ракурсов было мало в обучении, устойчивого узора для них не сложилось. Поэтому компьютерное зрение так ценит разнообразные данные — чем больше непохожих примеров, тем крепче узнавание.
Эти же ошибки объясняют, почему в серьёзных областях ИИ ставят помощником, а не судьёй. Хороший пример — медицина: нейросеть отлично подсвечивает подозрительные места на снимке, но финальное слово остаётся за врачом. Если интересно, как это устроено на практике, у нас есть отдельный разбор — как ИИ уже меняет медицину: снимки, лекарства и помощь врачам.
Как ИИ связывает картинку и слово
Отдельный большой скачок — модели, которые работают с картинкой и текстом сразу. Идея красивая: научить сеть раскладывать и изображения, и подписи к ним в одном общем «пространстве смыслов» так, чтобы фотография кошки и слова «рыжий кот» оказывались рядом, а «кот» и «самолёт» — далеко друг от друга.
Так устроена, например, модель CLIP: её учили не на фиксированных ярлыках, а на парах «картинка — подпись» из интернета, предсказывая, какая подпись к какому изображению подходит. В результате ей можно словами описать новый класс, и она попробует его найти, даже если специально этому не училась. На этой же идее «общего пространства картинки и текста» стоят и генераторы изображений по описанию, и мультимодальные чаты, которым можно показать фото и спросить, что на нём.
В нашем Schai GPT это заметно с двух сторон: по описанию он может сгенерировать картинку, а к сообщению можно приложить изображение — как и в любом современном мультимодальном чате. Но даже самый ловкий «связыватель» картинки и слова по-прежнему работает со статистикой совпадений, а не с пониманием: он сопоставляет, а не осмысляет. Кстати, если хочется поиграть именно с рисованием по тексту, мы разбирали и это — какие нейросети для генерации изображений реально работают из России.
Мифы, которые пора отпустить
Теперь, когда механизм понятен, легко разобрать три расхожих заблуждения.
Миф 1: «ИИ видит как человек». Нет. Мы считываем смысл сцены целиком, достраиваем недостающее опытом и здравым смыслом. Сеть считает числа и ищет знакомый узор. Иногда результат совпадает с нашим, но путь к нему совершенно другой — и ломается он в других местах.
Миф 2: «Раз ИИ назвал — значит понял». «Назвал» — это выбор самого вероятного ярлыка по статистике. За уверенным ответом может стоять реакция на фон, на ракурс или вовсе на незаметную помеху в пикселях. Высокая вероятность на выходе — не гарантия, что сеть смотрела туда, куда нужно.
Миф 3: «ИИ объективен, он же машина». Модель наследует всё, что было в её обучающих данных, включая перекосы и пробелы. Если каких-то людей, предметов или ситуаций в данных было мало или они были показаны однобоко, сеть будет ошибаться именно на них. Объективность железа тут ни при чём — всё решает то, на чём учили.
Коротко
Картинка для нейросети — это таблица чисел, яркости пикселей по каналам цвета.
Сеть учится по размеченным примерам собирать смысл лестницей: края и пятна → текстуры → части → объект. Так работают и свёрточные сети, и vision-трансформеры.
«Распознал» не равно «понял»: внутри — статистические совпадения с ярлыком, а не смысл.
Отсюда особые ошибки: adversarial-подмена пикселей, реакция на фон («умный Ганс»), провалы на непривычном ракурсе.
Мультимодальные модели кладут картинку и текст в одно пространство — но тоже сопоставляют, а не осмысляют.
Поэтому ИИ хорош как быстрый помощник, но там, где цена ошибки высока, последнее слово стоит оставлять человеку. Больше таких разборов простым языком — на главной Schai.
Пока нет комментариев