
Если коротко. Вы платите не за сообщения и не за минуты, а за токены — кусочки текста, на которые модель режет всё, что видит и пишет. И тратит их не только ваш вопрос: в каждый запрос уезжает вся предыдущая переписка, приложенные файлы, картинки и служебная инструкция. Поэтому двадцатое сообщение в длинном чате стоит в разы дороже первого, одна и та же фраза по-русски дороже, чем по-английски, а выбор модели меняет цену того же ответа в десятки раз.
Это Profile — аккаунт, с которого мы разбираем Schai изнутри: не «как пользоваться», а «как оно устроено и почему ведёт себя именно так». Сегодня — про деньги. Не про наши закупки и не про маржу, а про механику: откуда вообще берётся цифра в счёте за разговор с нейросетью и на что в ней можно повлиять.
Токен — это не слово и не буква
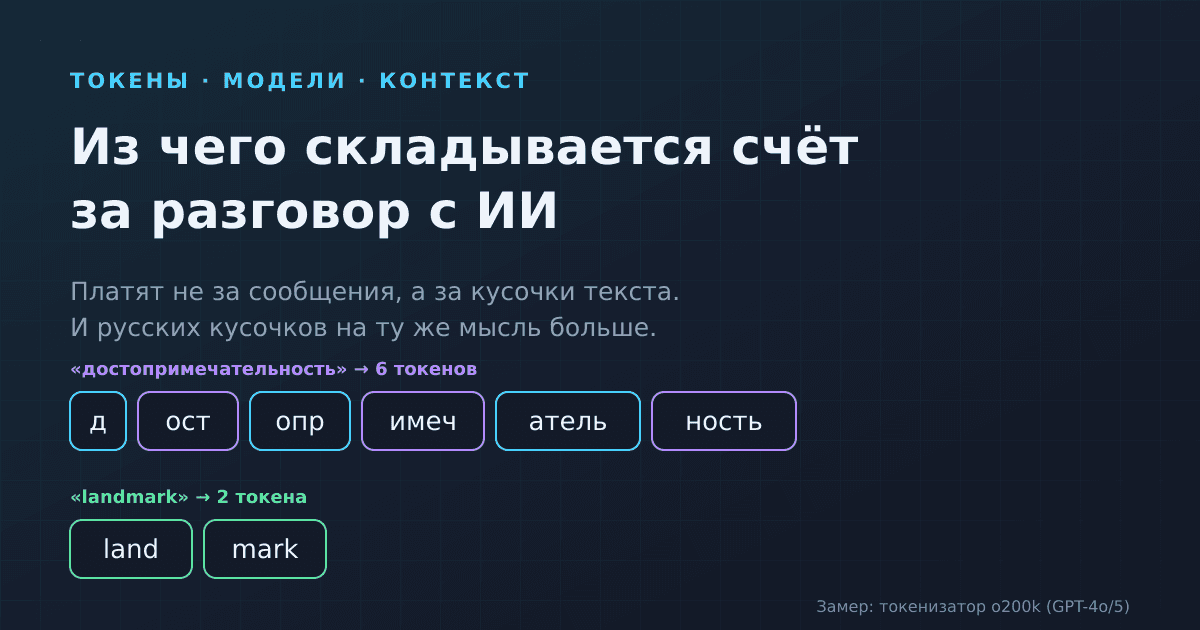
Модель не читает буквы и не знает слов. Перед работой текст режется на токены — частые куски, которые алгоритм-токенизатор выучил заранее на большом корпусе. В документации Anthropic это сформулировано так: один токен — это примерно 3,5 английских символа, но точное число зависит от языка. Английское «landmark» распадается на два куска — `land` и `mark`. Русская «достопримечательность» — на шесть: `д`, `ост`, `опр`, `имеч`, `атель`, `ность`. Одно понятие, разница в три раза.
Причина не в «дискриминации русского», а в арифметике обучения токенизатора. Словарь у него ограничен (у современных — около 200 тысяч кусков), и заполняется он тем, что чаще встречалось в обучающих данных. Английского текста в интернете кратно больше, поэтому английские слова влезают в словарь целиком, а кириллица достаётся обрывками. Плюс русская морфология: одно и то же слово живёт в десятке падежных и родовых форм, и каждая форма претендует на отдельное место в словаре.
Сколько это в цифрах
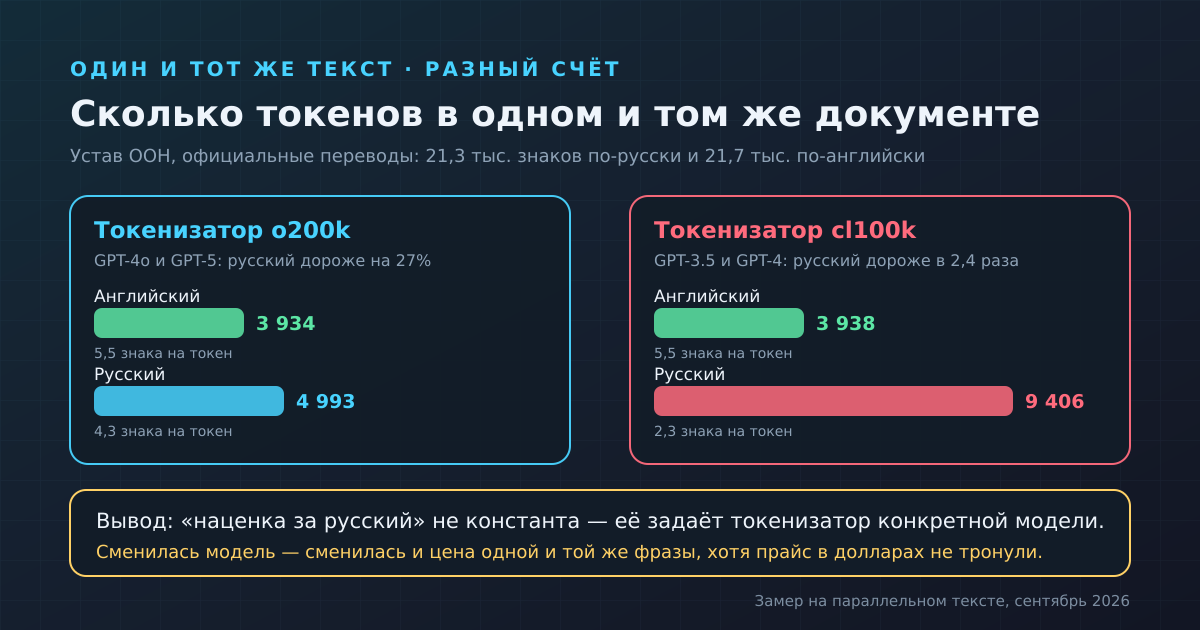
Чтобы не гадать, мы взяли текст, который заведомо существует в двух языках и переведён профессионально, — официальный русский перевод Устава ООН и английский оригинал, по 21 тысяче знаков с каждой стороны, — и прогнали оба через токенизаторы OpenAI. Результат: на современном токенизаторе (o200k, он же у GPT-4o и GPT-5) русский текст занял 4993 токена против 3934 английских — дороже на 27%. На прежнем (cl100k, эпоха GPT-3.5 и GPT-4) тот же русский текст стоил 9406 токенов против 3938 — в 2,4 раза дороже.
Это самый полезный факт для русскоязычного пользователя, и он двойной. Первое: «русская наценка» существует, но она давно не та, что была в 2023-м — с 2,4 раза она упала до примерно четверти. Второе: наценка не константа, а свойство конкретной модели. Anthropic честно предупреждает в прайсе, что модели начиная с 4.7 используют новый токенизатор, который даёт примерно на 30% больше токенов на том же тексте. То есть цена за миллион токенов может не измениться, а счёт за ту же работу вырастет — просто потому, что текст теперь режется мельче.
Почему длинный чат дорожает с каждым сообщением
Главное недоразумение в счетах за ИИ выглядит так: человек пишет короткое «ага, а теперь покороче» и получает списание, как за полноценный запрос. Механизм простой и неочевидный: модель не помнит предыдущие реплики. Совсем. Между запросами у неё нет состояния, и видимость памяти создаёт приложение — оно каждый раз отправляет модели всю переписку заново.
В документации Anthropic это описано прямым текстом: по мере разговора каждое сообщение пользователя и каждый ответ накапливаются в контекстном окне, а предыдущие ходы сохраняются целиком; в счёт входит всё, что уехало в запрос, — системная инструкция, каждое сообщение, результаты инструментов, картинки и документы. Отсюда и арифметика: если один ход разговора занимает тысячу токенов, то на десятом ходу вход — уже около десяти тысяч, а суммарно за десять ходов вы оплатите не десять тысяч, а около пятидесяти пяти. Счёт растёт не линейно, а квадратично.
Отсюда же следует и главный бытовой совет — и теперь он не звучит как «магия»: когда тема сменилась, открывайте новый чат и переносите в него короткое резюме на 5–10 строк. Вы не теряете контекст, вы заменяете его сжатой версией. Заодно улучшаете качество: в той же документации отдельно предупреждают про context rot — по мере роста числа токенов у модели падают точность и способность вспомнить нужное место. Длинный чат не только дороже, он ещё и глупее.
В Schai GPT это сделано автоматически: в модель уезжают последние два десятка сообщений, а всё, что было раньше, дешёвая фоновая модель сжимает в компактную «память диалога» — факты о вас, договорённости, открытые вопросы. Вы этого не видите, но именно поэтому длинная переписка не превращается в снежный ком.
Кэш контекста: когда одно и то же перестаёт стоить дважды
Если в каждый запрос уезжает один и тот же кусок — длинная инструкция, приложенный договор, начало переписки, — провайдер может не считать его заново, а достать уже обработанным из кэша. Экономия огромная и вполне официальная: у Anthropic чтение из кэша стоит 0,1 от обычной цены входа, а запись — 1,25 от неё при пятиминутном хранении; то есть кэш окупается уже со второго обращения. У DeepSeek разрыв ещё резче: попадание в кэш стоит $0,006 за миллион токенов против $0,3 при промахе — разница в пятьдесят раз.
Два практических следствия. Первое: кэш живёт минутами (у Anthropic по умолчанию пять, за отдельную цену — час), поэтому серия вопросов подряд по одному документу обходится дешевле, чем те же вопросы, растянутые на вечер. Второе: кэш срабатывает только на неизменном начале запроса и только если оно достаточно длинное — минимум от 512 до 4096 токенов в зависимости от модели. Правка в первом абзаце инструкции обнуляет кэш целиком; правка в конце — нет. Включает кэш приложение, а не вы, — значит, от вас тут зависит ровно одно: ритм работы.
Уровни моделей: тяжёлая не значит лучше
Внутри одного производителя разброс цен — десятикратный. У Anthropic по открытому прайсу лёгкая Haiku 4.5 стоит $1 за миллион входных токенов и $5 за миллион выходных, средняя Sonnet 5 — $2 и $10, старшая Opus 5 — $5 и $25, а флагманская Fable 5 — $10 и $50. У нас в чате та же лестница видна без долларов: рядом с каждой моделью в меню стоит значок «расход ×N» — во сколько раз быстрее она тратит баланс относительно базовой. У лёгкой это ×2, у старших — ×38 и ×76.
Соблазн понятный: взять самую дорогую и не думать. Но переплата почти всегда возникает там, где разницы не видно. Тяжёлая модель выигрывает на длинной цепочке рассуждений: разбор кода с неочевидной ошибкой, юридический или технический текст, где нужно свести десять условий, задача с арифметикой в несколько шагов, работа агентом — когда модель сама выбирает инструменты и должна не сбиться на пятом шаге. На «перепиши это письмо вежливее», «сделай список дел», «переведи абзац», «придумай десять заголовков» разницу в ответе вы не заметите, а баланс потратите в десятки раз быстрее.
Есть и вторая причина не держать тяжёлую модель постоянно: режим размышления. Внутренние рассуждения модели — это тоже токены, и оплачиваются они как выходные, хотя вы их не видите. На простом вопросе «подумать подольше» — чистая переплата.
Что ещё съедает токены, кроме ваших слов
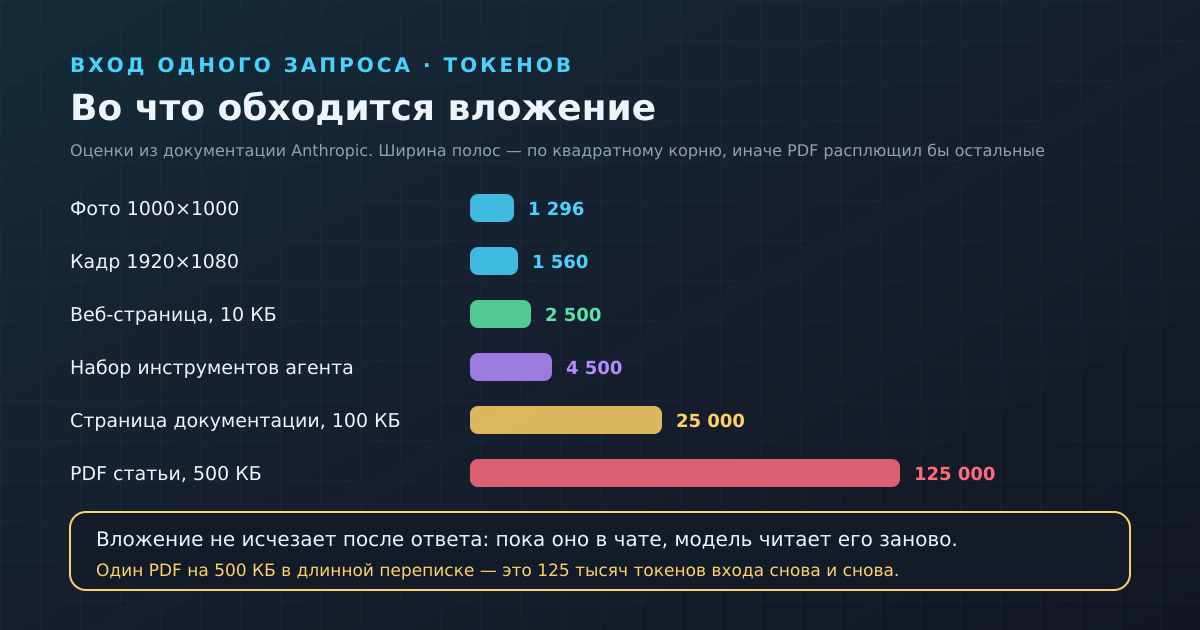
Текст — только часть счёта. Картинка превращается в токены буквально: изображение режется на квадраты 28×28 пикселей, и каждый квадрат — один визуальный токен. По таблице Anthropic фото 1000×1000 стоит 1296 токенов, кадр 1920×1080 — 1560 на обычных моделях и 2691 на моделях высокого разрешения. То есть одна фотография равна примерно странице плотного текста, а скриншот в высоком разрешении — двум.
Файлы и ссылки дороже, чем кажется. По оценкам из той же документации, обычная веб-страница весом 10 КБ — это около 2500 токенов, страница документации на 100 КБ — 25 тысяч, а PDF научной статьи на 500 КБ — 125 тысяч токенов. Причём вложение не исчезает после ответа: пока оно в чате, оно уезжает в модель снова и снова на каждом следующем вопросе.
Незаметный расход добавляют инструменты. Когда ассистент умеет искать в интернете, читать почту или запускать код, описания этих инструментов уезжают в каждый запрос как обычный текст: у набора для управления компьютером это около 4500 входных токенов на запрос, у простого тул-сета — три-четыре сотни. Часть инструментов тарифицируется отдельно от токенов: веб-поиск у Anthropic стоит $10 за тысячу поисков плюс токены за найденное.
Голос и генерация — вообще отдельная касса. Расшифровка речи и озвучка считаются не по токенам чата, а по длительности или символам, а картинки и видео — за изображение и за секунду ролика. Ролик на пять секунд у топовой видеомодели стоит как несколько сотен обычных сообщений, и это нормально: там другая математика.
Как платить меньше и ничего не потерять
Меняете тему — начинайте новый чат. Работает потому, что переписка пересылается целиком: обрубив хвост из двадцати сообщений про отпуск, вы перестаёте оплачивать его в каждом вопросе про работу. Резюме на десять строк сохраняет всё, что реально нужно.
Не прикладывайте файл «на всякий случай». Вырезать нужные две страницы из стостраничного PDF — это разница между тысячей токенов и сотней тысяч на каждом ходу. Если документ нужен целиком, задайте по нему все вопросы сразу, одной серией.
Спрашивайте пачкой, пока контекст горячий. Кэш живёт минуты, а не часы: пять вопросов подряд по одному договору обойдутся дешевле, чем те же пять вопросов за день.
Просите короткий ответ явно. Выход почти у всех моделей ровно в пять раз дороже входа: у Opus 5 это $5 за миллион входных токенов и $25 за миллион выходных, у Haiku — $1 и $5. Фраза «ответь тремя пунктами, без вступления» экономит больше, чем любая оптимизация вопроса.
Правьте точечно. «Перепиши второй абзац, остальное не трогай» вместо «перепиши всё» — модель не будет заново генерировать (и тарифицировать) текст, который вас устраивает.
Держите лестницу моделей. Рутина — на лёгкой, разбор и код — на тяжёлой. Переключение занимает два клика, а разница в расходе баланса — десятки раз. И выключайте режим размышления там, где думать не над чем.
Английский — там, где важен смысл, а не формулировка. Технический промпт, список ключевых слов, инструкция для агента по-английски дадут примерно четверть экономии на входе. А вот текст, который вы потом опубликуете по-русски, писать по-английски бессмысленно: перевод съест разницу.
Почему цены меняются каждые пару месяцев
Прайсы моделей живут своей жизнью, и это не капризы. За полтора года в этой отрасли произошло всё сразу: старые флагманы подешевели вдвое при смене поколения, появились «лёгкие» версии за десятую долю цены, провайдеры ввели скидки за пакетную обработку (у Anthropic — 50% за асинхронный Batch API) и за время суток (у DeepSeek вне пиковых часов те же токены стоят ровно вдвое дешевле — буквально одна и та же фраза, отправленная в разное время). Плюс смены токенизаторов, о которых мы говорили выше.
Как это видно вам. Мы не выставляем счёт в долларах за каждую модель — у нас единый баланс в токенах: 4 млн за 299 ₽, 16 млн за 1200 ₽, 70 млн за 5000 ₽, то есть 75 ₽ за миллион (и 71 ₽ на самом большом пакете — скидка за объём). Разница в стоимости моделей проявляется не в цене пакета, а в скорости, с которой он тает: отсюда значок «расход ×N» в меню и таблица расхода по моделям на странице тарифов. Когда поставщик меняет прайс, меняется множитель — пакет остаётся прежним. Это честнее, чем плавающая цена подписки, но требует привычки: смотреть надо не на «сколько сообщений осталось», а на то, какой моделью вы их пишете.
Коротко
— Платят за токены, а не за сообщения: в счёт идут ваш вопрос, ответ модели и весь контекст.
— Русский текст на современных токенизаторах дороже английского примерно на четверть; на моделях прошлого поколения было в 2,4 раза.
— Длинный чат дорожает квадратично: каждое сообщение тащит за собой всю историю. Новый чат с коротким резюме — самый сильный приём экономии.
— Кэш контекста удешевляет повторное чтение в 10–50 раз, но живёт минуты и ломается от правки в начале запроса.
— Разброс цен между лёгкой и флагманской моделью — десятикратный, а разница в ответе видна только на сложных задачах.
— Картинки, файлы, инструменты и режим размышления тратят токены молча: фото 1000×1000 — 1296 токенов, PDF на 500 КБ — около 125 тысяч.
— Цены поставщиков меняются постоянно; в Schai это видно как множитель расхода у модели, а не как изменение цены пакета.
Пока нет комментариев