
Если коротко: «больше параметров» не значит «лучше для вашей задачи». Модель покрупнее почти всегда сильнее по широте знаний, но для узкой, повторяющейся задачи малая модель, хорошо обученная на качественных данных или «выжатая» из большой, часто даёт тот же результат быстрее, дешевле и даже надёжнее. Разберём, откуда это берётся.
Я Кира Нейман, пишу про нейросети по-человечески, так что без лозунгов: сначала механизм, потом выводы.
Размер модели не работает в одиночку
Интуитивно кажется, что качество зависит от числа параметров: больше «нейронов», больше ума. На деле у модели есть три рычага: число параметров, объём данных, на которых её учили, и вычислительный бюджет обучения. Если крутить только первый, остальные становятся узким местом.
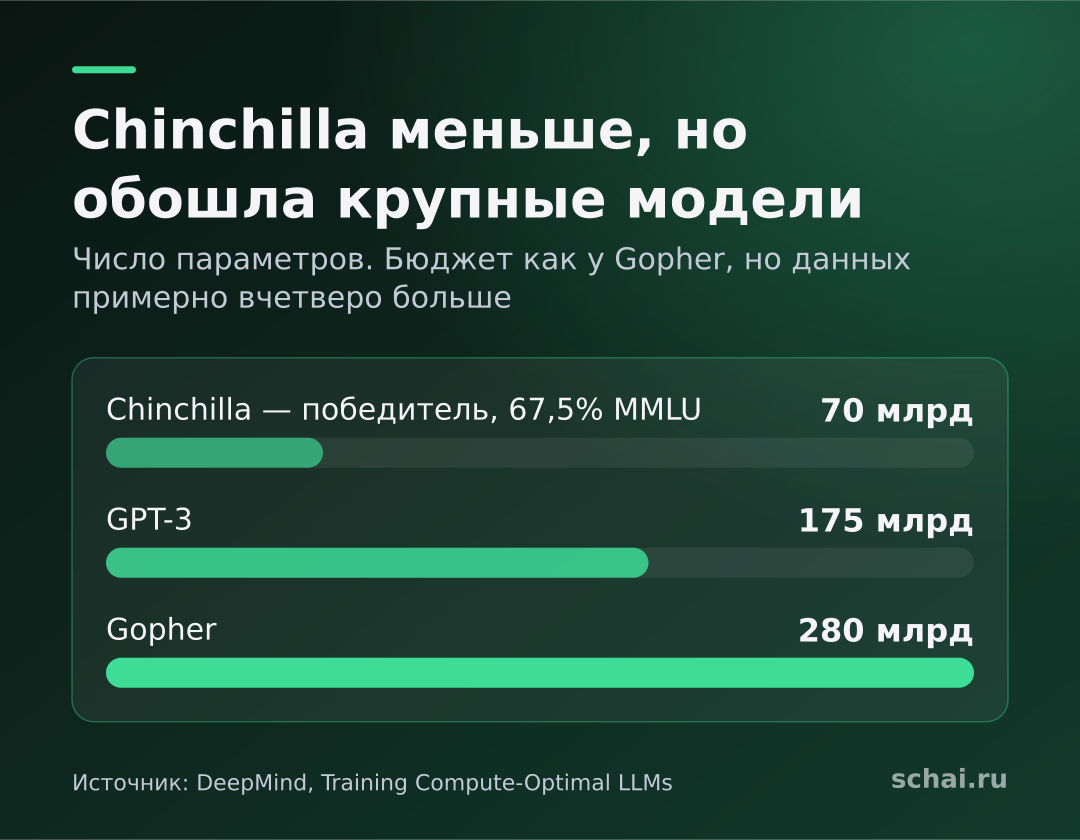
Классический пример — работа DeepMind о модели Chinchilla. Авторы показали в статье «Training Compute-Optimal Large Language Models», что при фиксированном бюджете размер модели и число токенов в обучающих данных нужно наращивать вместе: каждое удвоение размера должно сопровождаться удвоением данных. Крупные модели того времени, по выводу авторов, были недообучены: параметры росли, а данных оставалось примерно столько же.
Чтобы это проверить, они обучили Chinchilla на 70 миллиардов параметров с тем же бюджетом, что и у Gopher на 280 миллиардов, но на примерно вчетверо большем объёме данных. Результат: Chinchilla обошла Gopher, а также GPT-3 на 175 миллиардов параметров на широком наборе задач и набрала 67,5% на тесте MMLU, больше чем на 7 пунктов выше Gopher. Побочный эффект, о котором авторы пишут отдельно: меньшая модель дешевле и при дообучении, и при каждом запуске.
Вывод для обывателя простой: модель в четыре раза меньше может выиграть у большой, если её лучше «кормили».
Качество данных важнее объёма параметров
Следующий шаг — понять, что не все данные одинаково полезны. Если учить маленькую модель на тщательно отобранных, «учебникоподобных» текстах и синтетических примерах, она усваивает больше полезного на каждый токен.
Хороший пример — семейство Phi от Microsoft. В техническом отчёте о Phi-3 сказано, что phi-3-mini имеет 3,8 миллиарда параметров, обучалась на 3,3 триллиона токенов и показывает 69% на MMLU и 8,38 на MT-bench. По словам авторов, это сопоставимо с Mixtral 8x7B и GPT-3.5, причём модель достаточно мала, чтобы работать на телефоне. Старшие версии, phi-3-small (7 млрд) и phi-3-medium (14 млрд), дают 75% и 78% на MMLU.
Здесь стоит быть честным: это результаты на бенчмарках, которые выбрали сами авторы, и на реальных задачах цифры могут расходиться. Но тенденция понятна: качество датасета способно компенсировать разницу в размере.
Дистилляция: большая модель учит маленькую
Второй механизм, из-за которого малые модели «умнее своего размера», называется дистилляцией. Идея описана ещё в статье Хинтона и коллег 2015 года: знания громоздкой модели или ансамбля моделей переносят в одну небольшую, которую намного проще и дешевле запускать. Маленькая модель учится не только на «правильных ответах», но и на том, как большая распределяет уверенность между вариантами. Это более богатый сигнал, чем просто «ответ А верный».
Поэтому многие компактные модели в продуктах — это ученики крупных. Они повторяют поведение учителя в нужной области, но весят и «думают» в разы меньше.
Скорость, цена и приватность
Теперь практика. Время ответа и стоимость модели растут вместе с размером: на каждый сгенерированный токен приходится порядка двух операций на параметр, а ещё надо держать веса в памяти видеокарты. Меньше параметров означает:
- ответ приходит быстрее, это критично для подсказок в реальном времени и для голосовых ассистентов;
- сервер обслуживает больше пользователей на том же железе, то есть запрос дешевле;
- модель можно запустить на ноутбуке или телефоне, и тогда данные не покидают устройство;
- проще дообучить под свою задачу и держать это дообучение актуальным.
Для приватности последний пункт ключевой: если модель работает локально, переписка, документы и голос остаются у вас.
Что говорят исследователи про «агентов»
В 2025 году группа авторов опубликовала работу «Small Language Models are the Future of Agentic AI». Её мысль: агентные системы чаще всего повторяют узкие, специализированные операции (разобрать письмо, вызвать инструмент, отформатировать ответ). Для таких задач малые модели достаточно мощные, лучше подходят и экономичнее. Где нужен широкий диалог, авторы предлагают гибрид: несколько моделей разного размера в одной системе, а большая подключается, когда без неё не обойтись.
Это позиция авторов, а не доказанный факт. Но логика здравая: нет смысла нанимать профессора, чтобы переименовывать файлы.
Когда большая модель всё-таки лучше
Не стоит делать вывод, что «малое всегда лучше». Крупные модели выигрывают, когда:
- задача открытая и требует широких знаний: вопросы «обо всём», сложные рассуждения в несколько шагов;
- нужно уловить тонкий контекст или редкий факт;
- вы заранее не знаете, о чём спросят: универсальность стоит параметров;
- нужно работать с длинным и неоднородным контекстом.
Малая модель чаще всего ошибается там, где знания «не влезли»: редкие факты, сложная арифметика, длинные цепочки логики. И она может увереннее, чем нужно, выдавать неверное, поэтому важные факты стоит проверять независимо от размера модели.
Как выбирать на практике
Короткая схема, которой пользуюсь сама:
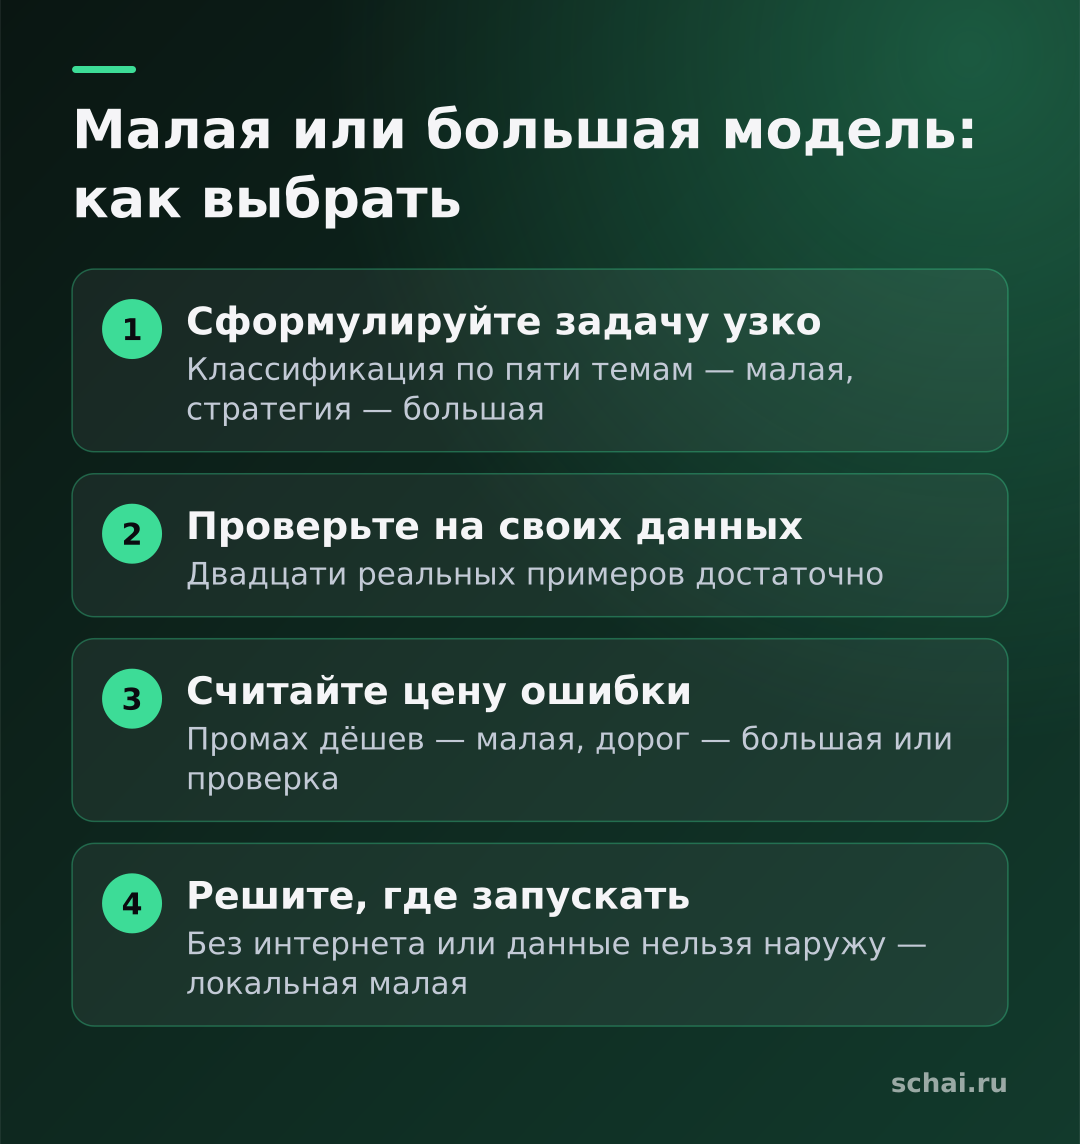
1. Сформулируйте задачу узко. «Классифицировать обращения по пяти темам» — это малая модель. «Обсудить стратегию компании» — большая.
2. Проверьте на своих данных, а не по рейтингам. Двадцати реальных примеров достаточно, чтобы увидеть разницу.
3. Считайте не качество в среднем, а цену ошибки. Если промах дёшев, берите быструю малую модель; если дорог, платите за большую или добавьте проверку человеком.
4. Подумайте о месте запуска. Нужна работа без интернета или данные нельзя отправлять наружу — смотрите на локальные малые модели.
Частые заблуждения
«Маленькая модель глупая». Нет, она узкая. На знакомой задаче она может быть не хуже большой, а вот на незнакомой теряется быстрее.
«Чем больше параметров, тем меньше ошибок». Не обязательно: ошибки зависят и от данных, и от способа обучения, и от того, как модель проверяют.
«Для локального запуска нужен суперкомпьютер». Для малых моделей нет: как следует из отчёта о Phi-3, модель с несколькими миллиардами параметров может работать на телефоне. Качество при этом ниже, чем у облачных гигантов, но для многих повседневных задач его хватает.
«Рейтинги всё скажут». Бенчмарки удобны для сравнения, но измеряют не вашу задачу. Модель, высоко стоящая в рейтинге, может хуже справляться именно с вашими данными.
Коротко
- Размер модели — только один из рычагов: данные и бюджет обучения не менее важны (пример — Chinchilla против Gopher).
- Качественные данные и дистилляция позволяют малой модели приблизиться к большой на конкретных задачах.
- Малые модели быстрее, дешевле и могут работать локально, что хорошо для приватности.
- Для широких, непредсказуемых и сложных задач большая модель всё ещё сильнее.
- Выбирайте по своей задаче и своим тестам, а не по числу параметров в названии.
Пока нет комментариев