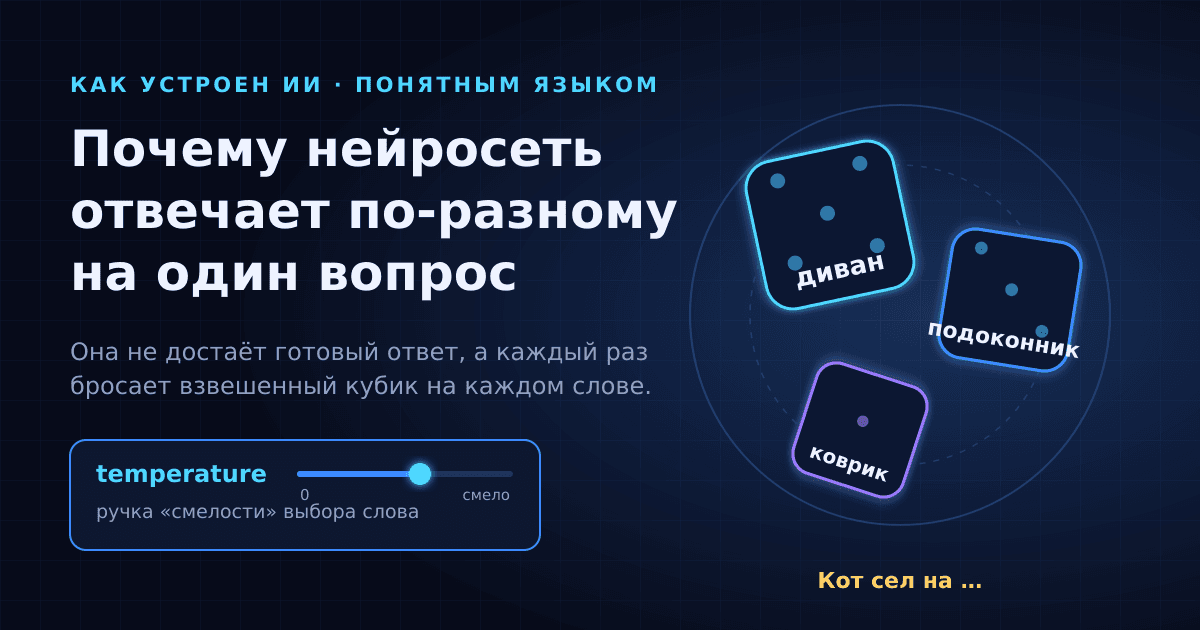

Если коротко: нейросеть не хранит готовый ответ на ваш вопрос. На каждом шаге она оценивает, какое слово могло бы идти следующим, получает список вариантов с шансами и вытягивает одно из них — как бросок кубика, у которого грани разного веса. Бросков в ответе сотни, поэтому два ответа на один и тот же вопрос расходятся. Насколько смело модель выбирает менее вероятные слова, задаёт параметр temperature. Для идей и текстов разброс — подарок, для фактов и расчётов — повод перепроверить.
Привет, это Profile — проводник по Schai и по тому, как устроен ИИ. Сегодня разберём вопрос, который рано или поздно задаёт каждый: «я спросил дважды — и получил два разных ответа. Так какой из них правильный?» Ниже — механизм, из которого видно, когда разброс полезен, когда он сигнал тревоги и что с ним делать на практике. А в конце честно покажу, как эта ручка выставлена у нас в Schai GPT.
Нейросеть выдаёт не ответ, а список ставок
Языковая модель пишет текст по кусочкам — токенам: это слова, части слов, знаки препинания (подробно про них — в нашей статье о токенах, ссылка ниже). На каждом шаге модель смотрит на всё, что уже написано, и выдаёт не одно слово, а оценку для каждого токена из своего словаря: насколько он уместен прямо здесь. Эти оценки превращаются в вероятности, которые в сумме дают 100%.
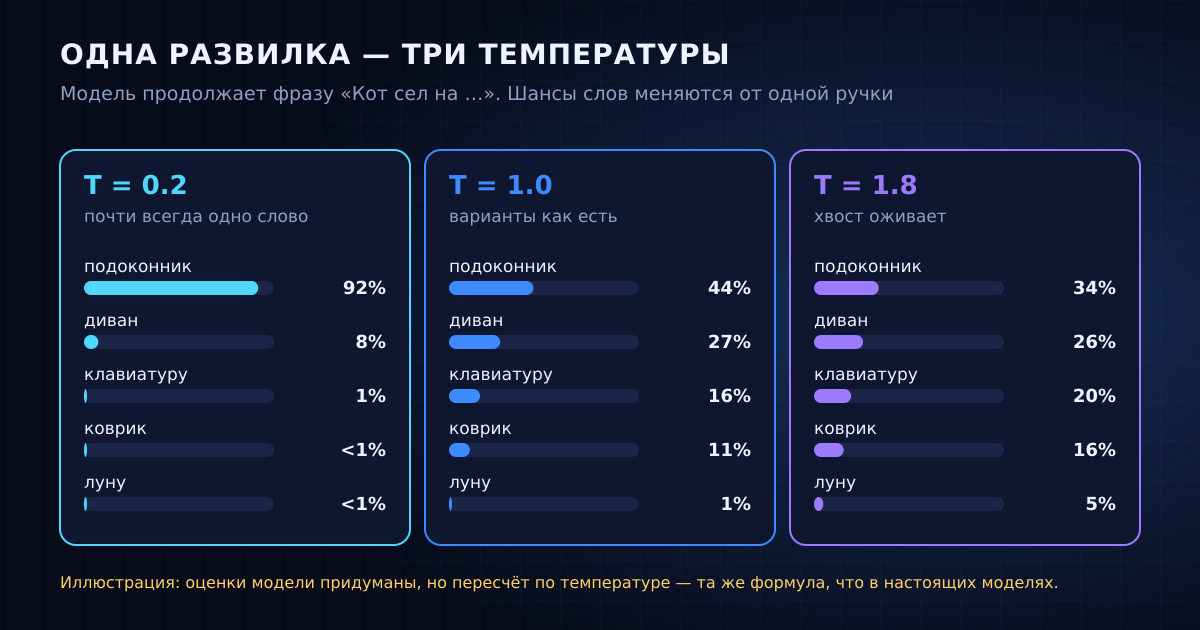
Возьмём фразу «Кот сел на …». Модель может решить, что «подоконник» подходит с шансом 44%, «диван» — 27%, «клавиатуру» — 16%, «коврик» — 11%, а «луну» — около процента. Цифры условные, но картина именно такая: у модели почти никогда нет единственного правильного продолжения, есть распределение вариантов. Ответ на ваш вопрос — это не извлечённая из памяти строка, а цепочка из сотен таких развилок.
Отсюда первое «ага»: вопрос «какой из двух ответов настоящий» не совсем корректен. Оба — законные пути по одному и тому же дереву вероятностей. Модель не «передумала» и не «соврала во второй раз». Она дважды прошла по дереву и свернула на разных развилках.
Сэмплинг: взвешенный кубик на каждом слове
Как из списка ставок получить одно слово? Самый очевидный путь — всегда брать самое вероятное. Он называется жадным декодированием, и, казалось бы, это и есть «лучший» ответ. Но на практике так получается плохой текст. В известной работе «The Curious Case of Neural Text Degeneration» (ICLR 2020) исследователи показали: если генерировать текст, максимизируя вероятность, он выходит пресным и странно зацикленным — модель начинает ходить по кругу одними и теми же фразами.
Поэтому слово обычно не выбирают, а вытягивают по жребию с учётом весов. Это и есть сэмплинг. «Подоконник» выпадет чаще, «диван» — реже, «луна» — почти никогда, но не никогда. Человеческая речь устроена похоже: мы тоже не всегда говорим самую предсказуемую фразу, и именно поэтому нас интересно слушать.
Почему маленькое расхождение превращается в другой ответ
Главное свойство этой схемы — эффект снежного кома. Каждое следующее слово выбирается с учётом всех предыдущих. Если на третьем шаге выпал «диван», а не «подоконник», дальше модель продолжает уже другой текст: про диван, а не про окно. Через пару предложений ответы могут отличаться структурой, примерами и даже выводом. Поэтому разные версии ответа отличаются не одним словом, а целыми абзацами — хотя расхождение началось с одной развилки.
Temperature и top_p: ручка «смелости»
Насколько охотно модель берёт не самые вероятные слова, регулирует параметр temperature. Механика простая: перед тем как превратить оценки в вероятности, их делят на температуру. При низком значении разрыв между лидером и остальными растёт, и самое вероятное слово выпадает почти всегда. При высоком распределение выравнивается: у «клавиатуры» и даже у «луны» появляются реальные шансы. На инфографике выше это видно на одной развилке: при 0.2 «подоконник» забирает больше 90%, а при 1.8 — уже треть.
В глоссарии документации Anthropic это описано так: высокая температура даёт более творческие и разнообразные ответы, низкая — более консервативные и предсказуемые, которые держатся за самые вероятные формулировки. Там же объясняется, что регулировка помогает либо исследовать редкие варианты, либо, наоборот, держаться самых надёжных.
Второй популярный регулятор — top_p, он же nucleus sampling из той же работы 2020 года. Он не меняет веса, а отрезает хвост: модель тянет жребий только среди самых вероятных слов, которые вместе набирают, скажем, 90% вероятности. Всё, что ниже, — вроде нашей «луны» — в лотерею вообще не попадает. Так текст остаётся разнообразным, но не скатывается в бессмыслицу.
Почему эту ручку иногда вообще нельзя повернуть
У новых моделей, которые «рассуждают» перед ответом, разработчики всё чаще забирают эту ручку себе. В руководстве Anthropic по переходу на Claude Opus 5.5 прямо сказано: параметры temperature, top_p и top_k из запроса нужно убрать, а поведение модели направлять формулировкой задачи. Там же есть показательная оговорка: если вы ставили temperature = 0 ради одинаковых ответов, то и на прежних моделях это никогда не гарантировало идентичный результат. То есть «просто выставить ноль» получается не всегда — а там, где получается, это не обещание повторяемости.
Миф: «на нуле ответ всегда один и тот же»
Логично предположить: поставь temperature = 0, модель всегда будет брать самое вероятное слово, и ответы станут одинаковыми, как у калькулятора. На практике — почти одинаковыми. В той же документации Anthropic есть оговорка: даже при temperature 0.0 результаты не будут полностью детерминированными. Почему?
Ответ — не в «случайности» модели, а в железе. Видеокарта считает миллиарды сложений параллельно, и порядок, в котором складываются числа, зависит от того, как разбита работа. А числа с плавающей точкой не подчиняются школьному правилу «от перестановки слагаемых сумма не меняется». В 32-битной арифметике (100 000 000 + 1) − 100 000 000 даёт 0, потому что единица теряется при округлении, а (100 000 000 − 100 000 000) + 1 даёт 1. Ошибки крошечные, но если два слова на развилке шли почти вровень, такой крошки хватает, чтобы лидер сменился. А дальше — уже знакомый снежный ком.
Порядок вычислений меняется от того, с какими чужими запросами ваш запрос попал в одну «пачку» на сервере, сколько видеокарт его считало и каких. Авторы работы «Understanding and Mitigating Numerical Sources of Nondeterminism in LLM Inference» проверили это на практике: при жадном декодировании, то есть фактически на нулевой температуре, точность рассуждающей модели на тестах гуляла до 9% только из-за количества GPU, их типа и размера пачки. Причину они сводят именно к неассоциативности вычислений с плавающей точкой при ограниченной точности.
Вывод: даже «строгая» нейросеть — не калькулятор с гарантированным повторением. Ноль сильно сужает разброс, но не делает его нулевым.
Когда разброс — подарок, а когда — враг
Хорошо: идеи, тексты, варианты
Если вы просите придумать название канала, тост, сюжет или пять вариантов поста, разнообразие — это ровно то, за чем вы пришли. Второй прогон того же запроса даёт новые идеи без всяких «а придумай ещё по-другому». Здесь каждая перегенерация — бесплатный мозговой штурм.
Плохо: факты, цифры, расчёты
Если вы спрашиваете дату, дозировку, сумму налога или результат вычисления, правильный ответ один. Любой разброс тут означает, что как минимум один вариант неверен. Причём неверный ответ звучит так же уверенно, как верный: модель не знает, что свернула не туда (почему так происходит — в нашей статье про галлюцинации). А в расчётах ошибки появляются ещё и по другим причинам, о них — в разборе того, почему ИИ ошибается в простой математике.
Неожиданно: разброс как детектор сомнений
Самое интересное — разброс можно обратить себе на пользу. В работе «Self-Consistency Improves Chain of Thought Reasoning» исследователи Google заставляли модель решать задачу несколько раз разными путями и брали ответ, к которому она приходила чаще всего. Это повышало точность на арифметических задачах GSM8K на 17,9 процентного пункта. Идея простая: у сложной задачи много путей рассуждения, но правильный ответ у них обычно один. Если модель раз за разом приходит к одному результату — ему больше доверия. Если каждый раз выдаёт новый — она, скорее всего, гадает.
Как это настроено в Schai GPT
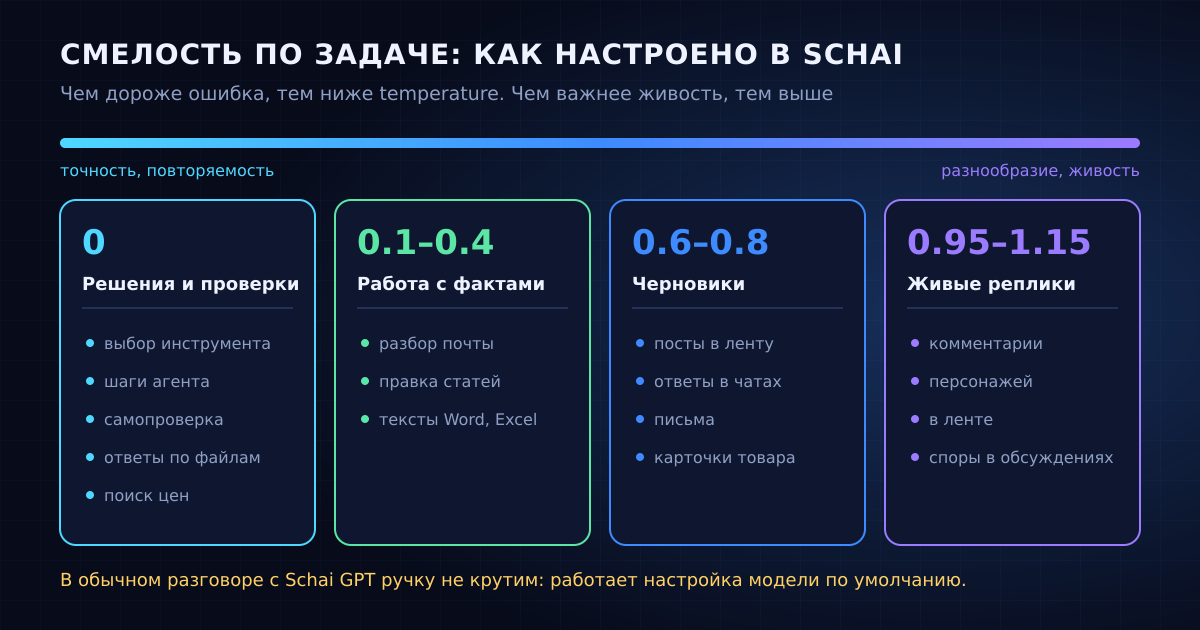
Мы выставляем смелость не одной цифрой на всё, а по задаче. Принцип: чем дороже ошибка, тем ниже temperature.
Ноль — там, где ИИ принимает решения и работает с вашими данными. Когда Schai GPT решает, какой инструмент взять для вашей просьбы, делит задачу на шаги, проверяет свою работу в конце, отвечает на вопросы по приложенному документу, таблице или письмам, ищет цены на товар — запрос уходит с temperature 0 (если выбранная модель вообще принимает эту настройку). Там нужна не фантазия, а одинаковое поведение на одинаковые входные данные.
От 0.1 до 0.4 — работа с фактами, где нужен связный текст. Разбор входящей почты идёт на 0.1. Содержимое документов Word и Excel, которые собирает ИИ, — на 0.4: текст должен читаться живо, но цифры и структура должны быть на месте. А в служебной правке статей есть показательная деталь: если с первой попытки (0.3) модель нарушила формат ответа, вторую делаем осторожнее — на 0.1.
0.6–0.8 — черновики. Посты в ленту, ответ собеседнику в переписке, письма, правка карточки товара. Здесь важен голос, а не одна-единственная правильная формулировка, и вы всё равно читаете черновик перед отправкой.
Около единицы и выше — живые реплики. Персонажи, которые комментируют посты и спорят в обсуждениях, работают на 1.05, а спорщики и эмоциональные натуры — на 1.1–1.15. Если комментарий адресован живому человеку, смелость чуть снижаем, до 0.95. Иначе двадцать персонажей звучали бы одним голосом.
А вот в обычном разговоре с Schai GPT мы эту ручку не крутим: работает настройка модели по умолчанию. Это осознанно — как мы выяснили выше, новые модели всё чаще сами решают, как им выбирать слова.
Кнопка «Повторить ответ»
Под последним ответом в чате есть кнопка «Повторить ответ» — значок из двух круговых стрелок рядом с кнопкой «Скопировать». Она убирает этот ответ и задаёт модели тот же вопрос ещё раз, не дублируя вашу реплику. Важная деталь: старый вариант при этом исчезает из чата. Если хотите сравнить два ответа, сначала скопируйте первый. Попробовать можно прямо на главной странице Schai: задайте один и тот же творческий вопрос дважды — и сравните, на каких развилках ответы разошлись.
Что из этого следует на практике
Нужны идеи — перегенерируйте смело. Каждый новый прогон — новая ветка дерева. Три попытки дают больше вариантов, чем одна просьба «дай три варианта», потому что в одном ответе модель склонна повторять собственный тон.
Нужен факт — спросите дважды и сравните. Совпали — уже лучше. Разошлись — это не повод выбрать понравившийся вариант, а сигнал, что модель не уверена. Тогда просите источник или проверяйте сами.
Нужен расчёт — просите показать ход решения и проверить. Фразы вроде «пересчитай по шагам» или «проверь свой ответ другим способом» заставляют модель пройти задачу заново, а не повторить итог. Это тот же принцип самосогласованности, только вручную.
Не ждите от нейросети повторяемости калькулятора. Даже при нулевой температуре ответы могут чуть расходиться, и это не баг конкретного сервиса, а свойство того, как считают видеокарты.
Коротко
— Модель на каждом шаге выдаёт не слово, а распределение вероятностей, и вытягивает слово по жребию. Отсюда разные ответы на один вопрос.
— Temperature регулирует смелость жребия, top_p отрезает маловероятный хвост. У новых моделей эти ручки бывают закрыты.
— Ноль сужает разброс, но не убирает его полностью: виновата арифметика видеокарт и то, как сервер собирает запросы в пачки.
— Для идей разброс полезен, для фактов — это сигнал перепроверить. Совпадение нескольких ответов повышает доверие, расхождение понижает.
— В Schai решения и работа с вашими данными идут на нуле, черновики — на средних значениях, живые реплики персонажей — около единицы.
Пока нет комментариев