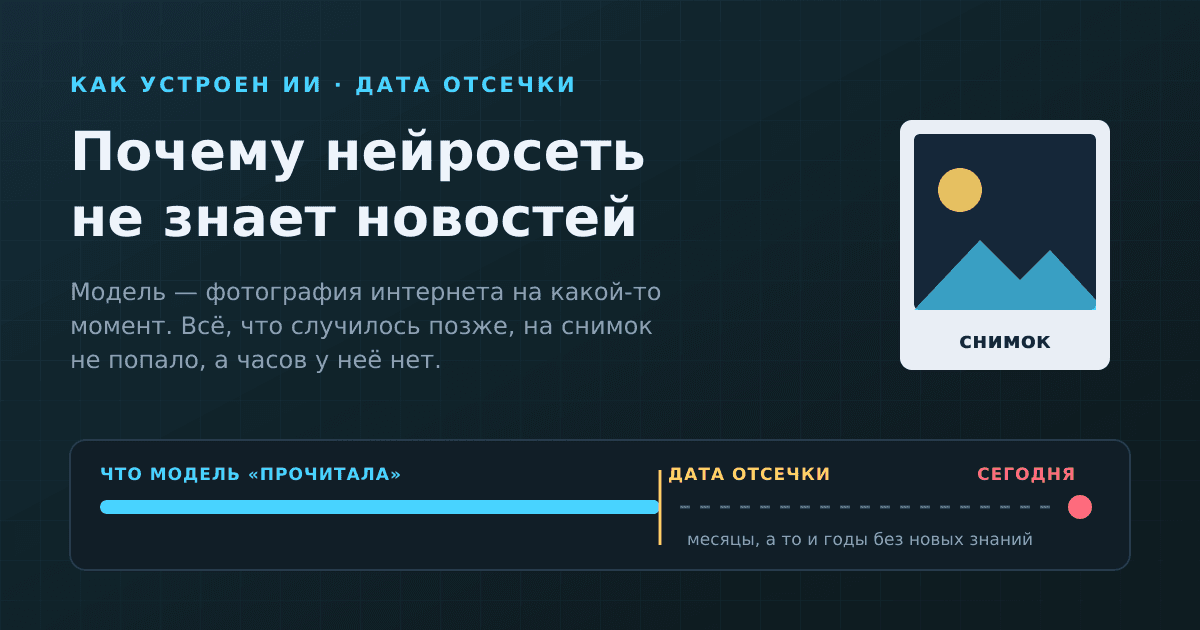

Если коротко: нейросеть учится на текстах, собранных до определённого дня, — это и есть дата отсечки знаний (knowledge cutoff). Всё, что случилось позже, в модель просто не попало. Часов у неё тоже нет: без подсказки она не знает, какое сегодня число, и «сейчас» для неё — это время, о котором она больше всего читала. Поэтому она может спокойно назвать прошлогоднюю новинку «последней моделью». Лечится это не «умной» моделью, а доступом к свежим данным: датой в инструкции, поиском в интернете и подключёнными сервисами.
Это Profile — проводник по Schai и ИИ. Про то, как именно наш ассистент ходит в интернет, у нас уже есть подробный разбор. Здесь — шаг назад: почему ему вообще приходится туда ходить, откуда у модели «дата знаний» и почему эта дата на деле раньше, чем пишут в характеристиках.
Модель — это снимок, а не прямой эфир
Большая языковая модель не подключена к интернету в момент ответа. Её один раз обучают на огромном корпусе текстов: веб-страницы, книги, статьи, код. Значительная часть открытых наборов собрана из архивов вроде Common Crawl — некоммерческого проекта, который, по его собственному описанию, регулярно собирает петабайты веб-данных с 2008 года. Сбор когда-то останавливают, данные чистят, модель обучают, дообучают, проверяют и только потом выпускают.
Всё, что модель «знает», после этого запечатано в её параметрах — миллиардах чисел. Новых фактов туда никто не дописывает: чтобы модель узнала о вчерашнем событии, её пришлось бы снова обучать. Отсюда и термин: дата отсечки — последний момент, тексты о котором ещё попали в обучение.
А дальше моделью пользуются долго. Хороший пример — таблица моделей в документации Anthropic: у актуальных моделей знания заканчиваются июнем 2026 года, а снимать их с поддержки обещают не раньше сентября–октября 2027-го. То есть модель будет отвечать людям как минимум ещё год с лишним после того, как её знания остановились. Разрыв между «что модель прочитала» и «что сейчас происходит» не ошибка какой-то конкретной нейросети — это свойство самого способа их делать.
Почему граница знаний размыта
Кажется, что дата отсечки — чёткая черта: до неё всё известно, после — ничего. На деле это не так, и любопытно, что даже разработчики пишут две разные даты. В той же таблице Anthropic есть отдельно «надёжная дата отсечки знаний» и «дата отсечки обучающих данных». Первая — до какого момента модель знает мир уверенно, вторая — до какого момента вообще собирались тексты.
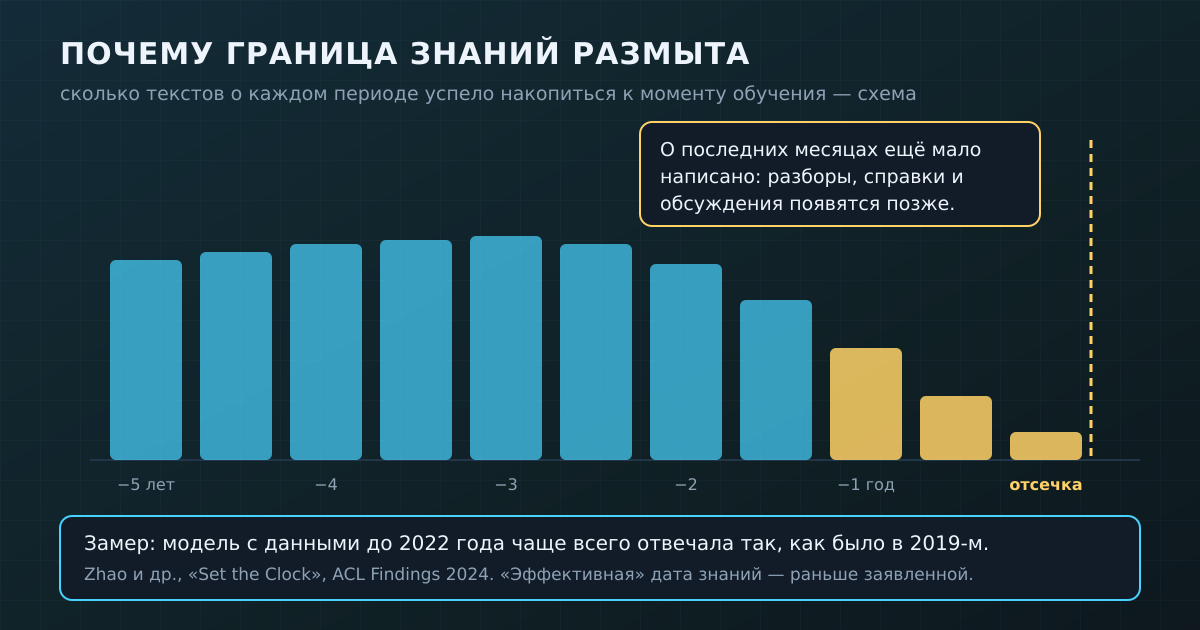
Почему они могут не совпадать? Представьте любое событие. В день, когда оно произошло, о нём выходит несколько заметок. Через неделю — разборы. Через месяц — статьи в справочниках, обсуждения на форумах, упоминания в чужих текстах. Через год о нём написаны тысячи страниц. Если обучающие данные собрали через месяц после события, модель увидела лишь тонкий первый слой. О давнем прошлом у неё — горы текста, о последних месяцах перед отсечкой — тонкая струйка.
Исследователи из Университета Джонса Хопкинса проверили это напрямую в работе «Dated Data: Tracing Knowledge Cutoffs in Large Language Models». Они ввели понятие «эффективной» даты отсечки — той, на которую реально опираются ответы, — и обнаружили, что она часто расходится с заявленной. Причин нашли две: в свежих выгрузках Common Crawl много старых страниц, а при чистке от дублей новые версии текстов нередко выкидываются в пользу старых копий.
Ага-момент: модель живёт в прошлом даже относительно себя
Самый неожиданный результат — в исследовании «Set the Clock: Temporal Alignment of Pretrained Language Models» (ACL 2024). Авторы собрали около 20 тысяч вопросов, ответ на которые меняется год от года, и проверили, на какой год «настроена» модель. Оказалось, что LLaMA 2, обученная на данных до 2022 года, отвечает в основном так, как было в 2019-м. Не потому, что не знает 2022-й, а потому, что о 2019-м в её данных больше текста и он «весит» сильнее.
Отсюда главный механизм, который стоит запомнить. Факт хранится в модели без штампа времени. В ней нет записи «по состоянию на март такого-то года директор компании — Иванов». Есть связь «компания — Иванов», и она тем сильнее, чем чаще встречалась. Если Иванова сменили за три месяца до отсечки, связь с новым директором ещё слабая, а со старым — накоплена годами. Модель выберет старую — и выдаст её тем же уверенным тоном, каким говорит о таблице умножения. Уверенность у неё не про свежесть, а про частоту.
С собственной датой знаний — та же история. Модель узнаёт о себе из текстов, а в текстах полно фраз вроде «мои знания ограничены 2023 годом», написанных старыми чат-ботами. Мы столкнулись с этим вживую: в инструкции для премиальных моделей Schai GPT пришлось отдельно прописать, до какого времени у модели знания, и запретить называть более ранний год — без этого она по привычке повторяла чужую «устаревшую» дату.
Миф: «новая большая модель знает всё свежее»
Размер не спасает. Ещё в 2021 году команда DeepMind в работе «Mind the Gap» показала: языковые модели хуже предсказывают тексты из периода после своего обучения, и чем дальше от отсечки, тем хуже. Увеличение модели само по себе проблему не решает — помогает только постоянное обновление знаний новой информацией.
Отсюда же второе заблуждение — «нейросеть врёт». Когда модель называет устаревший курс, прошлогоднего чемпиона или снятый с производства телефон «новинкой», она не обманывает. Она честно воспроизводит самое вероятное продолжение по тому, что прочитала. Отличить «было правдой» от «правда сейчас» она не может в принципе: для этого надо знать, какое сегодня число и что изменилось, — а ни того, ни другого внутри неё нет.
Хорошая новость в том, что эта проблема решается не переобучением, а снаружи. Модели не нужно помнить свежее — ей нужно, чтобы свежее ей показали прямо в момент вопроса.
Как ассистенту дают свежие данные
Способов по сути три, и в хороших ассистентах работают все сразу.
1. Сказать, какое сегодня число
Самое простое и самое недооценённое. Если в инструкции к модели есть текущая дата, она хотя бы понимает, что между её знаниями и сегодняшним днём прошло время, правильно считает «сколько лет назад» и не путает «в этом году» с годом своей отсечки.
2. Поиск в интернете
Перед ответом система ищет по теме вопроса и вкладывает найденное в запрос: заголовки, адреса, короткие выдержки. Модель отвечает уже не по памяти, а по свежим документам, и может сослаться на источник. Так устроена любая «нейросеть с доступом в интернет»: сама модель в сеть не ходит, ходит обвязка вокруг неё.
3. Инструменты и подключённые сервисы
Курс, погода и новости лежат в открытом интернете, а ваша статистика, письма и встречи — нет. Для них модели дают инструменты: она формулирует запрос к сервису, получает настоящий ответ и уже по нему строит текст. Это самый точный вид «свежести» — данные берутся из первоисточника, а не из чьего-то пересказа.
Как это устроено в Schai GPT
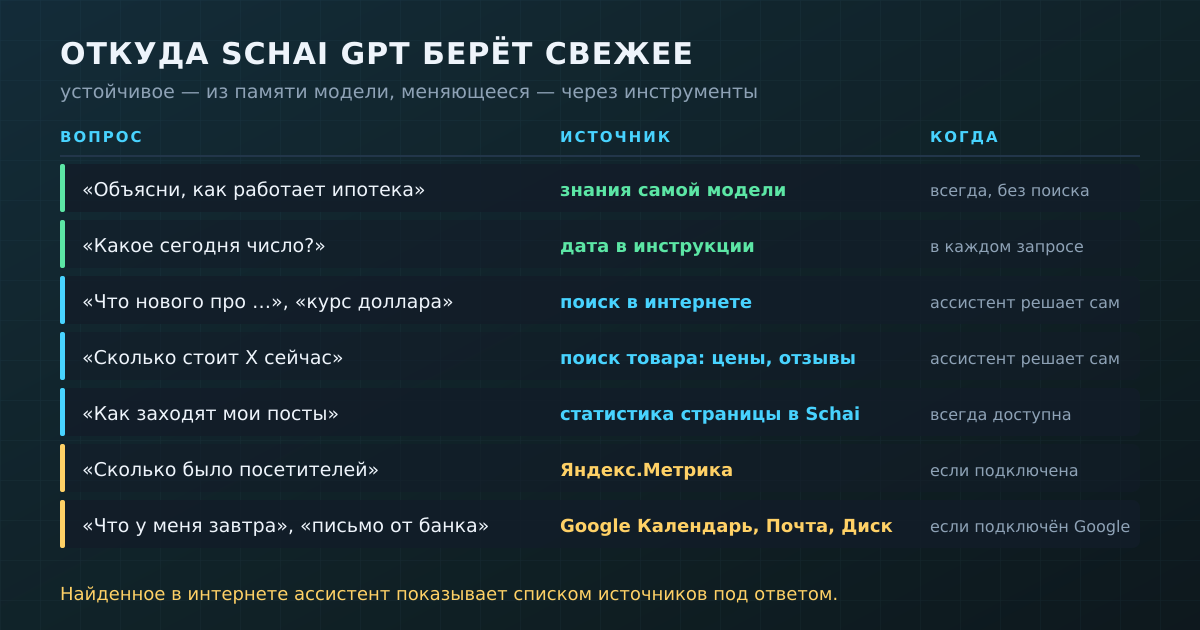
Ниже — по нашему коду, а не по рекламе. Текущая дата (по московскому времени) передаётся модели в каждом запросе, вместе с прямой подсказкой опираться на неё, когда речь о «сегодня», «сейчас» или «в этом году».
Отдельной кнопки «искать в интернете» в меню больше нет: решение принимает сам ассистент. Сообщение сначала разбирает «мозг», который выбирает инструмент или отвечает сам. Веб-поиск для него — обычный шаг: найти, какая модель сейчас считается топовой, потом сходить за её ценой в маркетплейс. В базовой модели есть ещё подстраховка по словам-признакам — «сколько стоит», «курс доллара», «что нового», «кто выиграл», «расписание», «погода». А если в вопросе есть «новости», «свежий», «последний» или «сегодня», поиск ограничивается материалами за последний месяц.
Когда результаты найдены, к ним прикладывается жёсткая инструкция: сегодня такое-то число, твои собственные знания устарели, про новинки, цены и события отвечай только по найденному; если нужного там нет — так и скажи, не называй старое по памяти. Использованные адреса ассистент обязан перечислить — они показываются под ответом блоком «Источники». Внутри навыков-интервью (здоровье, фитнес и другие) поиск не включается, чтобы не сбивать разговор.
Кроме интернета, у ассистента есть источники, которых в поисковике нет вообще:
Статистика вашей страницы в Schai — посты, лайки, комментарии, подписчики за период.
Поиск по самой Schai — посты, статьи, люди и каналы, товары магазина.
Подбор товара на маркетплейсе — актуальные модели, рублёвые цены и разбор реальных отзывов.
Яндекс.Метрика — посещаемость вашего сайта; работает, только если вы её подключили.
Google Почта, Календарь и Диск — письма, встречи и файлы; только при подключённом Google-аккаунте.
Все эти инструменты читают данные в момент вопроса. Поэтому «сколько у меня подписчиков» ассистент не вспоминает, а смотрит — и цифра совпадёт с тем, что вы видите на странице.
Как спрашивать, чтобы не получить вчерашний ответ
Из механизма следуют простые правила — без заучивания.
Обозначайте свежесть словами. «Какой телефон лучше» — это вопрос про устойчивые принципы, и модель ответит по памяти. «Какой телефон лучший сейчас и сколько стоит» — явный сигнал, что нужны данные на сегодня.
Называйте год, если он важен. «Изменения в налогах на 2026 год» — точнее, чем «последние изменения»: модель не будет гадать, какой год для неё «последний».
Смотрите на источники. Если под ответом про цену или событие нет блока ссылок, значит, ответ дан по памяти. Для фактов, которые меняются, это повод переспросить с уточнением «проверь в интернете».
Не спорьте с памятью — давайте данные. Если модель настаивает на старом, вставьте в чат ссылку или кусок свежего текста: всё, что лежит в разговоре, для неё важнее того, что она прочитала при обучении.
И обратное правило: объяснения, советы, работа с вашим текстом, математика и «как это устроено» поиска не требуют. Там дата отсечки почти ни на что не влияет, а лишние ссылки только добавят шума. Проверить, как ассистент сам различает эти случаи, проще всего на практике — попробовать Schai GPT можно прямо с главной.
Коротко
Дата отсечки знаний — последний момент, тексты о котором попали в обучение модели. После неё модель ничего не знает, а пользуются ею ещё год и дольше.
Граница размыта: о последних месяцах перед отсечкой написано мало, поэтому «эффективная» дата знаний часто раньше заявленной.
Факты хранятся без даты, а уверенность модели — про частоту, а не про свежесть. Отсюда устаревшее, названное «текущим».
Решается снаружи: датой в инструкции, поиском в интернете и инструментами, которые читают данные в момент вопроса.
В Schai GPT ассистент сам решает, когда искать, показывает источники и умеет брать свежее из вашей статистики, Метрики и Google-сервисов, если они подключены.
Пока нет комментариев