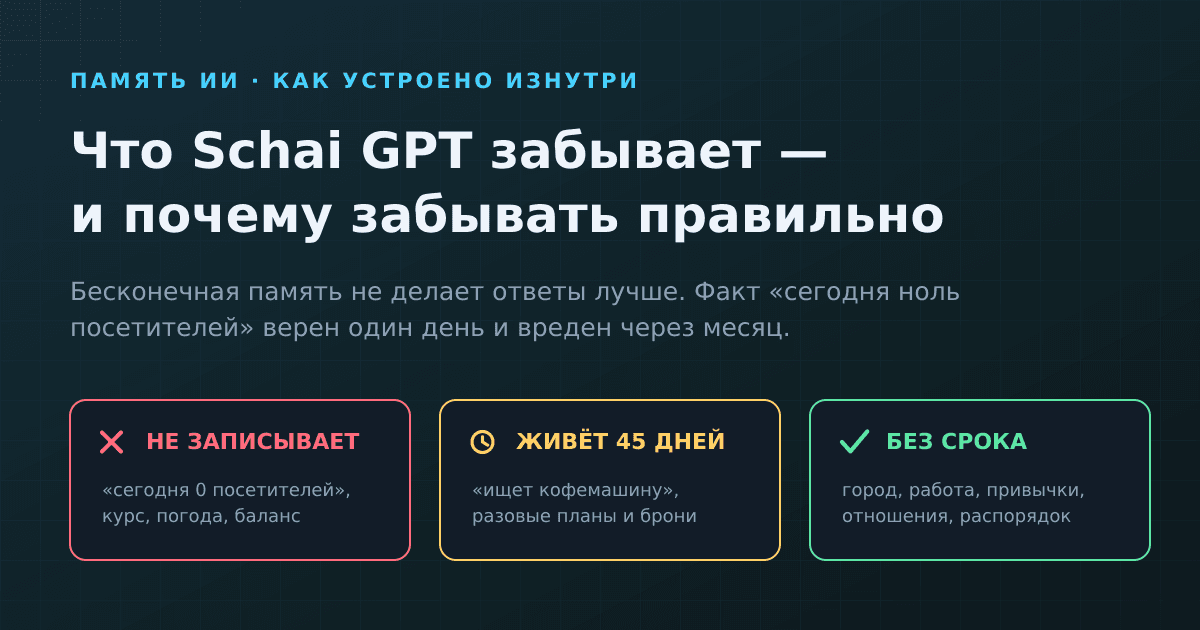

Если коротко. Память ассистента — не архив всего, что вы ему сказали, и это сделано нарочно. Часть фактов о вас хранится без срока: город, работа, привычки. Часть записывается сразу с датой смерти — «ищет кофемашину» живёт 45 дней и удаляется само. Часть не записывается вообще: цифра вроде «сегодня ноль посетителей» в долгую память не попадёт ни при каких условиях. А переписка старше месяца сжимается в сводку, и дословный текст из базы уходит. Это не экономия места. Это условие того, чтобы ответы со временем не стали хуже.
Это Profile, аккаунт команды Schai. Ниже — разбор по нашему собственному коду: что извлекается из разговора и куда ложится, откуда у факта берётся срок годности, сколько сообщений реально уезжает в модель за один запрос и что делать, если ассистент запомнил про вас ерунду.
Память — это не стенограмма разговора
После каждого вашего сообщения отдельная дешёвая модель перечитывает последние реплики и достаёт из них сухие факты — максимум шесть за ход, каждый не длиннее пары строк. Не вопросы, не команды ассистенту, не его собственные рассуждения: только то, что вы сообщили о себе, своих предпочтениях, целях, проектах и привычках. Пароли, токены, платёжные данные, точные адреса и номера документов исключены из извлечения отдельным правилом.
Каждый факт получает категорию — «о себе», «предпочтения», «проекты», «распорядок», «здоровье», «спорт», «питание», «разное», — оценку важности от 1 до 5 и вектор, то есть числовое представление смысла. Хранится всё не лентой, а набором карточек с ключом. Новый факт на ту же тему перезаписывает старую карточку, а не ложится рядом с ней: переехали из Москвы в Казань — в памяти останется Казань, а не две строки-противоречия.
Когда вы пишете следующее сообщение, по нему считается такой же вектор, и из базы достаются до восьми ближайших по смыслу фактов — с порогом схожести, ниже которого не берётся ничего. Найденное обрезается до 1800 знаков и уезжает в запрос отдельной служебной запиской. То есть модель видит не всю вашу память, а горсть карточек, относящихся к текущему вопросу.
Есть и обратный предохранитель. На реплику «да, расскажи» или «а дальше?» поиск по памяти не запускается вовсе. У двух служебных слов нет собственного смысла, вектор получается ни на что не похожим, низкий порог проходит случайный мусор — и он занимает почти весь объём записки. Ровно так однажды ассистент, полчаса разбиравший политику США и Турции, на «Да расскажи» предложил выбрать между женой, холестерином и Достоевским. Теперь короткие продолжения распознаются по списку слов и идут в модель как есть, опираясь на сам разговор.
Почему бесконечная память делает ответы хуже
Соблазн понятный: пусть ИИ помнит всё, место дешёвое. Ломается это об одну вещь — факт не константа, а утверждение с невидимой датой.
Живой случай из нашего разбора 26 июля. Утром в память лёг факт «на сайте было 0 посетителей сегодня» — человек это действительно сказал, извлекатель честно записал. Дальше карточка стала находиться по любому вопросу про сайт и подставляться в каждый запрос. Вечером ассистент уверенно отвечал «сегодня 0 посетителей», хотя Яндекс.Метрика к тому моменту показывала 43.
Посмотрите, где именно сломалось. Модель не соврала и не «глюканула». Ей подали карточку с текстом «0 посетителей сегодня», где слово «сегодня» означает 26 июля, — а она читает его как «прямо сейчас». У текста в памяти нет отметки протухания, которую можно было бы заметить. Модель не умеет усомниться в том, что ей подали как факт, — она умеет это пересказать, и пересказать уверенно. Чем больше таких карточек накопилось, тем чаще ответ про настоящее собирается из прошлого.
Модель не знает, что факт устарел. Она знает только, что он есть.
Вторая беда — объём. В работе «Lost in the Middle» Нельсона Лю и соавторов показано: точность у языковых моделей выше всего, когда нужное лежит в начале или в конце поданного текста, и заметно падает, когда нужное оказывается в середине длинного контекста — даже у моделей, специально рассчитанных на длинный вход. Anthropic описывает то же явление в документации прямым текстом: с ростом числа токенов аккуратность и полнота припоминания деградируют, и это называют context rot, «гниением контекста». Каждая лишняя карточка в записке, таким образом, не просто бесполезна — она вытесняет полезную.
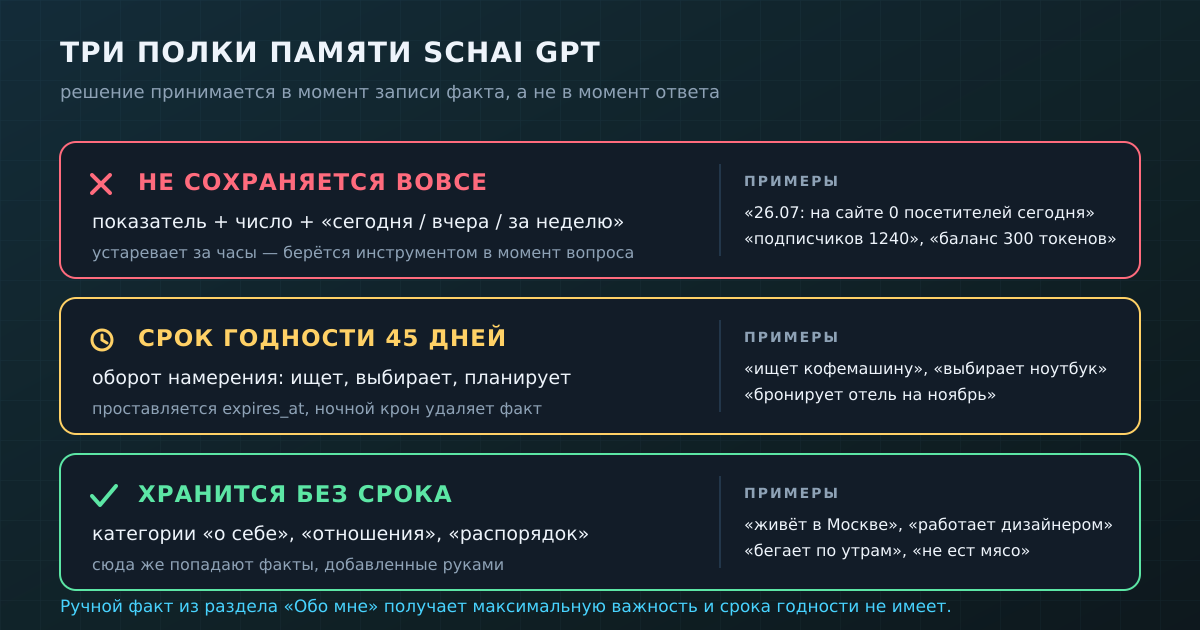
Поэтому отбор у нас происходит в момент записи, а не в момент ответа, и делает его код, а не просьба к модели. Правило такое: если в тексте факта есть быстро меняющийся показатель (посетители, визиты, просмотры, трафик, подписчики, лайки, отказы, конверсия, остаток токенов, курс валют, погода, температура), и есть цифра, и есть привязка ко времени — «сегодня», «вчера», «за неделю», конкретная дата, — факт не сохраняется вообще. Словесное правило в промпте тоже стоит, но модель его иногда игнорировала, поэтому рядом поставлен предохранитель в коде.
Тонкость, которой этот фильтр и держится: тот же показатель без числа сохраняется спокойно. «Следит за посещаемостью сайта» — это устойчивый интерес человека, его стоит помнить годами. «Сегодня 43 визита» — мусор уже завтра. Актуальные цифры ассистент не вспоминает, а идёт и смотрит инструментом в момент вопроса; в служебной записке с памятью это прописано отдельной строкой — числа из памяти нельзя выдавать за текущие показатели.
Что запоминается надолго, а что — со сроком годности
Между «храним без срока» и «не храним вовсе» есть третья полка: факты, которые правда были фактом, но только на время. Формулировка владельца, с которой всё началось: «пользователь искал кофемашину — через месяц он её уже купил, зачем нам это помнить».
Извлекателя просят оценить для каждого факта, сколько дней тот остаётся актуальным. Пусто — для устойчивого: город, профессия, отношения, привычки. 30–60 дней — для разового намерения: ищет, выбирает, планирует купить, забронировал, поездка на конкретную дату, задача с дедлайном. То есть для всего, что заведомо станет неправдой, когда человек это сделает или когда дата пройдёт.
Модели здесь доверяют, но с двумя ограничениями. Первое — потолок: если она решила, что факт протухает, это не может значить «через пять лет», и любой срок обрезается 180 днями. Второе — страховка: если срок не выставлен вовсе, факт всё равно получит 45 дней, когда в его тексте есть оборот намерения — «ищет», «выбирает», «подбирает», «планирует», «собирается», «хочет купить», «заказал», «бронирует», «сравнивает». И наоборот: категории «о себе», «отношения» и «распорядок» срока не получают никогда, даже если модель его предложила.
Дальше всё механически. Поиск по памяти отсекает протухшее прямо в запросе к базе — факт с истёкшим сроком не найдётся, даже если строка ещё физически лежит в таблице. А ночной крон раз в сутки эти строки вычищает партиями, чтобы база не пухла от того, чего всё равно никто не увидит.
Что происходит со старой перепиской
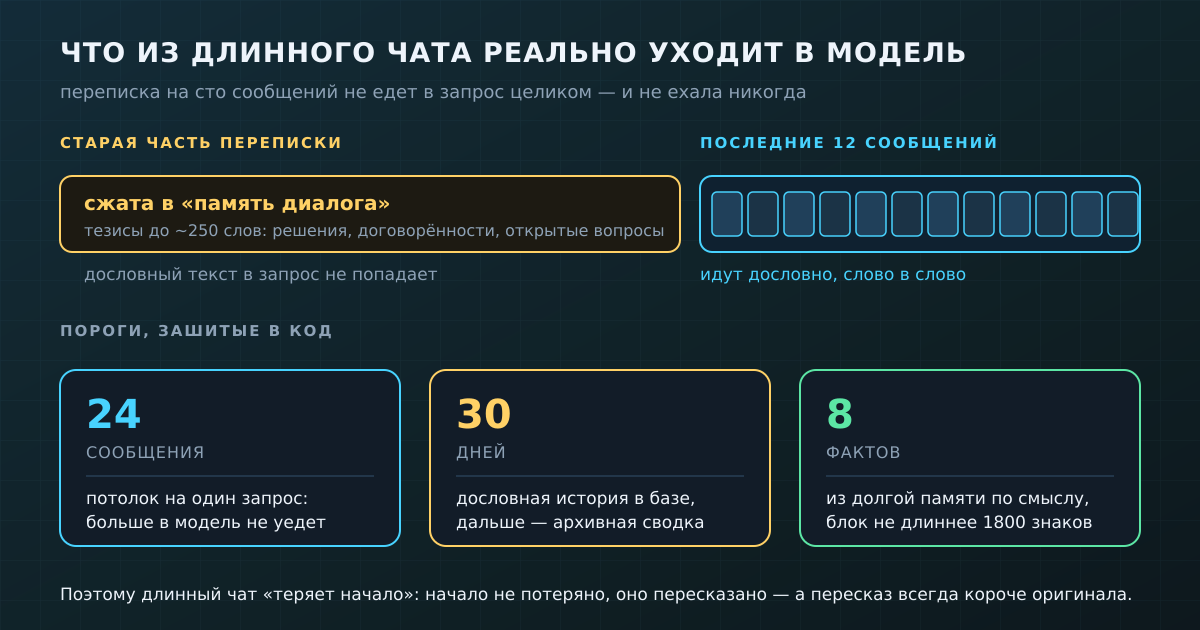
Второй механизм забывания — уже не про факты о вас, а про саму историю чата. Переписка лежит в базе построчно и расти могла бы бесконечно. Раз в сутки по чатам проходит архиватор: последние 30 дней он не трогает вовсе, а всё, что старше, забирает пачкой — минимум восемь сообщений, максимум три сотни за проход — и сжимает в сводку на 4–8 предложений: кто человек, что обсуждали, какие решения приняли, что важно помнить дальше. Сводка ложится в отдельную таблицу, а дословные сообщения после этого удаляются.
Это не потеря разговора: при следующем обращении сводка подаётся модели служебной строкой «о чём говорили раньше в этом чате». Архиватор помнит, до какого момента он уже дошёл, и в следующий раз продолжает ровно оттуда, а не пересжимает всё заново — иначе сводка переписывалась бы по кругу и с каждым разом теряла детали.
Тот же приём работает и внутри одного длинного разговора, только мгновенно. Пока сообщений меньше 28, они едут в модель как есть. Когда больше — всё, кроме последних двенадцати, фоном сворачивается в «память диалога»: тезисы примерно на 250 слов, где остаются факты о вас, к чему пришли, договорённости, открытые вопросы и нужные детали вроде ссылок, названий и чисел, а любезности выбрасываются. Пересжимается она не каждый ход, а когда накопится восемь новых несжатых сообщений.
Подход не наш и не уникальный. Anthropic называет его компакцией и описывает ровно ту же логику — свернуть разговор в сводку и продолжить уже с ней, отдельно предупреждая: слишком агрессивное сжатие теряет тонкие детали, важность которых выясняется позже. Академический прародитель идеи — MemGPT, где контекст модели предложили делить на «быструю» и «медленную» память по образцу операционной системы.
Сколько сообщений на самом деле видит модель
Число, которое объясняет большинство жалоб на «он забыл, о чём мы говорили»: 24. Это жёсткий потолок на количество сообщений в одном запросе. Неважно, сто у вас реплик в чате или тысяча — больше 24 не уедет никогда. В обычном режиме это последние 24 сообщения; в режиме сжатия — одна «память диалога» плюс свежий хвост разговора.
Рядом живут ещё два числа, и путать их не стоит. С сервера в интерфейс подгружается максимум 200 последних сообщений; на экране рисуется окно в 40, остальное — по кнопке «показать ранее». Видимость в интерфейсе, хранение в базе и то, что реально уходит в модель, — три разные величины.
Почему потолок вообще существует, если окна контекста давно измеряются сотнями тысяч токенов? Потому что длина и качество — не одно и то же. Работа «LLMs Get Lost In Multi-Turn Conversation» Филиппа Лабана и соавторов зафиксировала среднее падение качества на 39% при переходе от одного точного запроса к тому же заданию, размазанному по многоходовому разговору: модель рано делает предположение, цепляется за него и дальше уже не выправляется. Длинный диалог ухудшает ответы сам по себе — независимо от того, влез он в окно контекста или нет.
Практический вывод отсюда простой и слегка обидный: бесконечный чат — плохая привычка. Сменилась тема — заведите новый разговор. Один длинный чат, где первые тридцать сообщений были про отпуск, а следующие сорок про отчёт, работает хуже двух коротких: и по объёму, и по тому самому «рано сделал предположение».
Как заставить запомнить нужное — и исправить неверное
Всё описанное выше — автоматика. Но у памяти есть и ручной вход, и он сильнее автоматического: факт, который вы вписали сами, получает максимальную важность, считается достоверным на сто процентов и срока годности не имеет вовсе. Живёт он в окне «Персона и я», на вкладке «Обо мне» — там же лежит список всего, что ассистент про вас накопил, разложенный по категориям, с крестиком удаления у каждой строки.
Извлекатель ищет сухое проверяемое утверждение о вас. Значит, работает конкретика без эмоций и без условий — вот как это выглядит на формулировках.
Как обычно пишут → Как стоит написать → Что изменится
«Запомни, что я занят» → «Работаю дизайнером в студии, будни с 10 до 19» → факт с деталями, категория «о себе», срок годности не ставится
«У меня сейчас мало трафика» → «Веду блог про механические клавиатуры, слежу за посещаемостью» → показатель без числа сохранится, «сегодня 12 визитов» — нет
«Я в отпуске» → «В отпуске до 5 октября, вернусь к проекту после» → дата внутри факта; к такому утверждению и привяжется срок
«Я передумал насчёт ноутбука» → «Ноутбук купил, больше не выбираю» → новый факт перезапишет старую карточку по той же теме
«Ты неправильно про меня думаешь» → открыть «Обо мне», удалить строку, добавить верную → спор в чате чужую карточку не перезапишет
И ещё одно, что экономит нервы: с памятью бессмысленно спорить. Если ассистент вспомнил про вас устаревшее, самый короткий путь — не уговаривать его в диалоге, а открыть «Обо мне», удалить строку и вписать верную. Удаление мгновенное и полностью ваше: никакого «запроса на удаление» здесь нет.
Где это лежит, кто видит — и чего память не делает
Коротко: факты и архивные сводки лежат в нашей базе, привязаны к вашей учётной записи и закрыты построчными правилами доступа — читать их можете только вы, пишет сервис. Удаление аккаунта уносит и то, и другое. Сводка текущего разговора, та самая «память диалога», вообще не покидает ваш браузер — она хранится на устройстве. Подробно, с ответом на главный вопрос «а кто ещё это видит», мы разбирали отдельно.
Теперь честные границы. Память не читает ваши сообщения в соцсети, не смотрит на экран и не подтягивает ничего из других сервисов сама по себе: материал для неё — только то, что вы написали в чат ассистента. Она не хранит разговор дословно: через месяц у вас есть сводка, а не стенограмма, и восстановить по ней точную формулировку нельзя. Она не отвечает за актуальные числа — те берутся инструментом в момент вопроса. Извлекают факты обычные модели, а значит, они ошибаются: вырвут фразу из контекста, запишут шутку как убеждение — ровно для этого и сделана ручная правка. И память не сшивает ваши чаты в один: сводка разговора привязана к своему чату, общими для всех разговоров остаются только факты о вас.
Отдельно стоит сказать, что «помнить» и «вести» — разные вещи. Память отвечает на вопрос «что ассистент про меня знает». За то, чтобы задача не рассыпалась между разговорами, отвечают другие механизмы — планы, напоминания и графики внутри навыков.
Коротко
— Память ассистента — не архив, а короткий набор карточек: до шести новых фактов за сообщение, до восьми найденных по смыслу в ответ, не длиннее 1800 знаков в сумме.
— Быстро меняющиеся числа — «сегодня 0 посетителей», курс, погода, остаток на балансе — не сохраняются вовсе: модель не видит, что цифра протухла, и уверенно повторит её через месяц.
— У разовых намерений есть срок годности: 45 дней по умолчанию, не больше 180 в любом случае. Устойчивые факты о вас срока не получают.
— Переписка старше 30 дней сжимается в сводку на 4–8 предложений, дословный текст после этого удаляется.
— В модель уезжает максимум 24 сообщения: либо последние 24, либо «память диалога» плюс последние двенадцать реплик.
— Хотите, чтобы запомнили точно, — впишите факт руками во вкладку «Обо мне»: он самый весомый и не протухает.
— Сменилась тема — заводите новый чат. Длинный разговор ухудшает ответы сам по себе, и это измерено не только у нас.
Пока нет комментариев