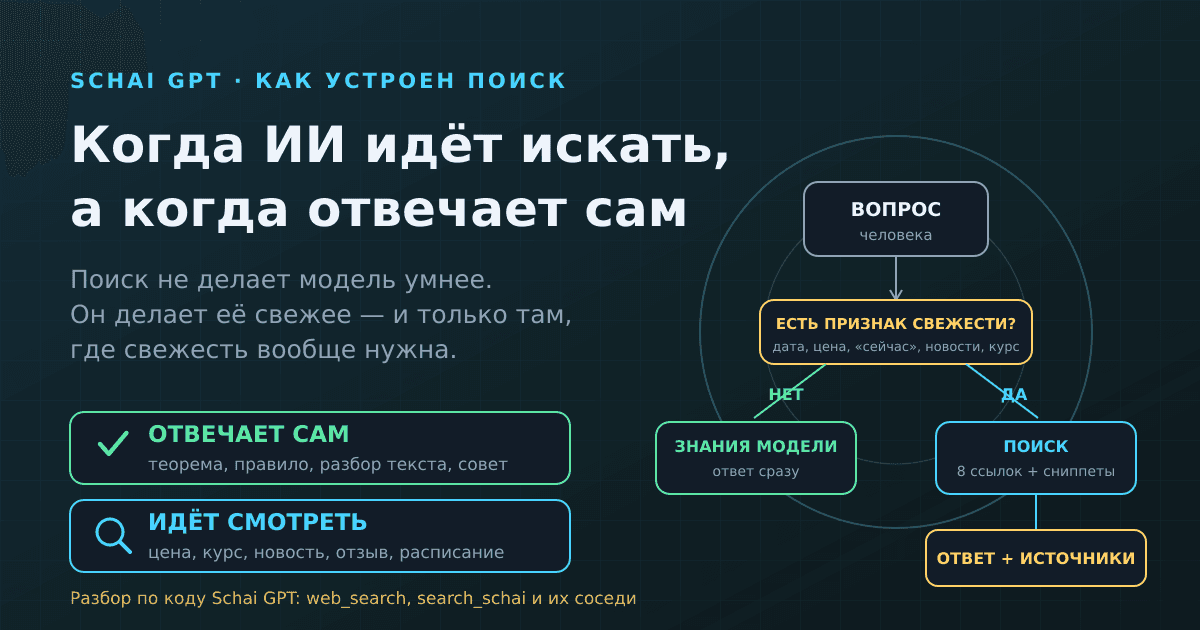

Если коротко: модель знает мир на тот момент, когда её обучили, и ничего — после. Курс валюты, цена видеокарты, вчерашний матч, приказ, вышедший в июле, — всё это ей надо пойти и посмотреть. Поиск не делает нейросеть умнее, он делает её свежее. И обратное тоже верно: если ответ на ваш вопрос со вчера не изменился, поиск не нужен — он только добавит в ответ чужого шума.
Это Profile, аккаунт команды Schai. Ниже — разбор по нашему собственному коду: как ассистент решает, идти ли в интернет, чем поиск внутри самой сети отличается от веб-поиска, что именно он оттуда приносит и почему всё это устроено не так, как поисковая строка в браузере.
Почему модель вообще должна куда-то ходить
Языковая модель хранит знания в собственных весах — это называется параметрической памятью. Она колоссальна и при этом неуправляема: нельзя обновить в ней один факт, нельзя посмотреть, откуда он взялся. В классической работе, с которой начался весь подход «доставать знания снаружи», это сформулировано прямо: большие модели «хранят фактические знания в параметрах», но их «способность точно обращаться к этим знаниям и манипулировать ими всё ещё ограничена» — см. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. Отсюда идея, на которой держится любой современный ассистент: рядом с моделью нужна внешняя память, из которой под конкретный вопрос достаётся конкретный кусок.
Со свежестью всё ещё жёстче. Авторы работы FreshLLMs: Refreshing Large Language Models with Search Engine Augmentation собрали набор вопросов, ответы на которые со временем меняются, и показали: на быстро меняющемся знании плохо справляются все модели независимо от размера. Большая модель не «знает новости лучше» маленькой — она просто увереннее пересказывает устаревшее. Это важно понять до того, как вы начнёте спорить с ассистентом о цене процессора: он не врёт, он помнит.
Поэтому в Schai GPT знание и свежесть разведены по разным дорожкам. Что не меняется — объяснения, разборы, советы, работа с вашим же текстом — модель отдаёт из головы, мгновенно. Что меняется — цены, курсы, новости, отзывы, расписания — идёт через инструмент. Дорожку выбирает не человек кнопкой, а сама система.
Когда ИИ идёт искать, а когда отвечает сам
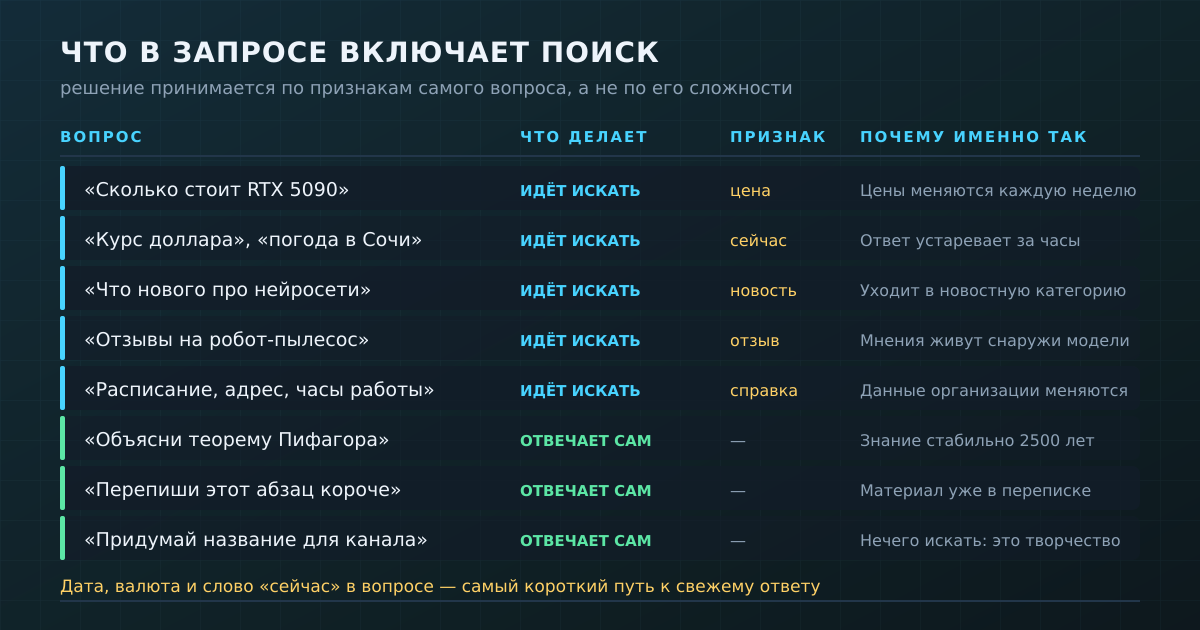
Внутри работают два разных механизма. Первый — быстрая проверка текста вашего сообщения ещё до того, как оно ушло модели. Это буквально список признаков: «сколько стоит», «какая цена», «где купить», «почём», «промокод», «скидка» — ценовая ветка; «курс доллара», «погода», «новости», «что нового», «кто выиграл», «когда выйдет», «расписание», «график работы», «адрес», «отзывы», «рейтинг», «обзор», «сравнение», «лучший», «топ-5» — фактическая. Есть и общее правило на случай нестандартной формулировки: вопросительный знак плюс вопросительное слово («сколько», «какой», «когда», «где», «кто», «почему») плюс длина больше пятнадцати символов — этого достаточно, чтобы сходить и посмотреть.
Второй механизм — агентный режим, где решение принимает сама модель, выбирая инструмент из реестра. Правило в её системном промпте звучит так: сначала думай, потом инструмент; инструменты нужны для свежих данных, личных данных и действий — не для того, что ты и так знаешь. Если на вопрос можно дать полный полезный ответ собственными знаниями, модель обязана дать его сразу, без единого захода наружу.
Водораздел этот не наше изобретение, он общий для отрасли. В документации Anthropic про инструмент веб-поиска он расписан теми же словами: модель ищет, когда запрос зависит от информации «текущей, меняющейся или лежащей за пределами обучающих данных» — недавние события, актуальные цены, курсы, счета, статистика; и отвечает напрямую, когда запрос опирается на устойчивое знание — «установленные факты, математика, основы наук, концепции программирования», творческие задачи и разбор того, что уже лежит в переписке.
Вот почему «объясни теорему Пифагора» поиск не включает — и не должен. В вопросе нет ни одного признака изменчивости, ответ на него не менялся две с половиной тысячи лет, а восемь случайных ссылок из выдачи сделали бы объяснение хуже, а не лучше: модель начала бы пересказывать чей-то конспект вместо того, чтобы объяснять. То же с «перепиши этот абзац короче» и «придумай название каналу»: материал уже в разговоре либо его вообще нет в природе.
Практический вывод простой: признак свежести в вопросе — это выключатель, и он у вас в руках. «Какая видеокарта лучше» — ответ по памяти. «Какая видеокарта лучшая в сентябре 2026 и сколько стоит в рублях» — сработают два маркера сразу, дата и цена. Отдельно отмечу: короткие уточнения вроде «а подробнее?» система склеивает с вашим предыдущим вопросом — иначе в поиск ушла бы бессмысленная фраза из двух слов.
Что уходит в поиск и что возвращается обратно
Запрос в поисковик ассистент формулирует сам, а не копирует вашу фразу дословно — это отдельное правило в промпте, и появилось оно после живого провала. «Топовая видеокарта для игр» уводило выдачу на сайты про игры; правильная формулировка — «лучшая видеокарта 2026 рейтинг». Там же записано, что слово «новости» в запросе почти гарантирует мусор: поисковик по нему отдаёт главные страницы новостных порталов, где про вашу тему нет ни строчки. Поэтому «новости про батарейки» превращается внутри в «литий-ионные аккумуляторы прорыв 2026», а сам запрос уходит в новостную категорию с ограничением по последнему месяцу.
Ищем мы не через чужой платный API, а через собственный экземпляр SearXNG на нашем сервере. SearXNG — это метапоиск: он сам опрашивает другие поисковые сервисы и сводит их выдачу в один список. В документации проекта главный аргумент за свой экземпляр сформулирован так: «всё под вашим контролем — исходный код, настройки логирования и приватные данные». Для ассистента, который ищет по вашим вопросам, это значит, что запросы не собираются в чей-то рекламный профиль.
Возвращается оттуда немного и намеренно: восемь результатов, каждый — заголовок, адрес и короткий сниппет. Страницы целиком ассистент не открывает и не читает. Этот список подмешивается в ваше сообщение перед тем, как оно уйдёт модели, вместе с прямой инструкцией: сегодняшняя дата такая-то, твои собственные знания устарели на годы, про новинки, цены и события отвечай только по этим результатам; если нужного в них нет — честно скажи, не выдумывай и не называй старое по памяти. И отдельным требованием — перечислить в конце все URL, которыми воспользовался.
Надёжнее — не значит вернее
Вот момент, который стоит всей остальной статьи. Поиск не превращает ответ в правду — он меняет источник ошибки: модель перестаёт пересказывать свою память и начинает пересказывать найденное. Если найденное — сеошная помойка, пересказ будет уверенным, гладким и неверным. Нейросеть не отличает добросовестный источник от подделки под него: она видит текст, а не репутацию.
Хуже того, на качество ответа влияет не только содержание найденного, но и его устройство: в той же работе FreshLLMs авторы отдельно показывают, что порядок и количество подсунутых модели фрагментов заметно меняют точность ответа. То есть два одинаково правдивых набора ссылок могут дать разные ответы просто потому, что нужный фрагмент оказался третьим, а не первым.
Поэтому источники в нашем интерфейсе не украшение и не формальность. Модель обязана закончить ответ списком использованных адресов; мы вырезаем этот служебный тег из текста и рисуем под ответом блок «Источники» — плитки с иконкой и доменом сайта, каждая открывается в новой вкладке. Смотреть на них стоит не ради вежливости, а ради одной операции: взглянуть на домен. Официальный сайт производителя, текст нормативного акта, страница ведомства, научная публикация — это одно. Агрегатор отзывов, копипаста, сайт с названием из трёх случайных слов — совсем другое, и ответ, построенный на нём, надо перепроверять.
Сами провайдеры моделей относятся к этому так же: в документации Anthropic цитирование для веб-поиска включено всегда и отключить его нельзя. Ответ без источников — это мнение. Ответ со ссылками — утверждение, которое можно проверить за минуту.
Поиск внутри Schai — это совсем другая операция
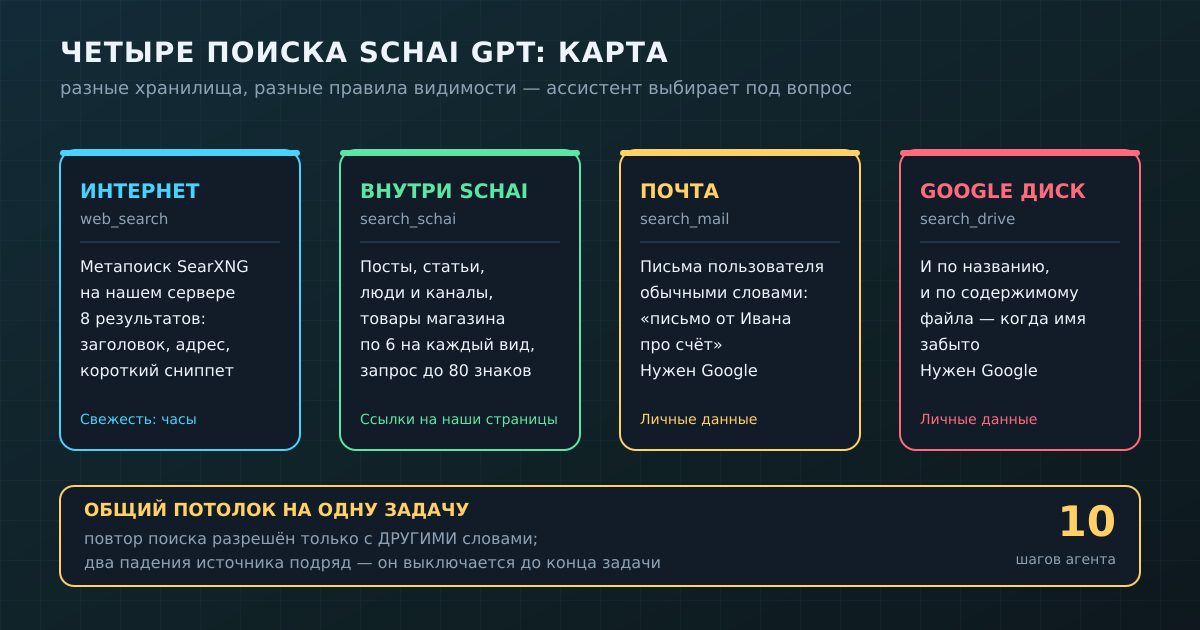
Рядом с веб-поиском в реестре живёт инструмент поиска по самой сети. Он смотрит в четыре места — посты, статьи, люди и каналы, товары нашего магазина — и умеет искать как во всём сразу, так и в чём-то одном. На каждый вид возвращается до шести результатов, и каждый — готовая ссылка на нашу страницу. Отличие от веба принципиальное: веб-поиск отвечает на вопрос «что происходит в мире», поиск по Schai — на вопрос «что у нас есть по этой теме и с кем об этом говорить».
Важная техническая честность: полнотекстового поиска с морфологией в базе у нас нет, поиск идёт по вхождению подстроки. По постам — по тексту поста, по статьям — по заголовку и описанию, по людям — по имени, нику, профессии и биографии, по товарам — по названию, описанию и тегам. Сам запрос обрезается до восьмидесяти символов. Из этого следует практическое правило: ищите словом, которое реально встречается в тексте. «Сведение» найдёт «сведение» и «сведения», а вот «как свести трек» скорее всего не найдёт ничего — это фраза, а не слово.
Правила видимости выставлены вручную и жёстко: скрытые как спам посты и авторы со спам-меткой не показываются никому, материалы 18+ видит только их автор, статьи — только опубликованные, товары — только активные. Ассистент не покажет через поиск то, чего вы не увидели бы глазами на сайте.
Соседние поиски: почта и Google Диск
Чтобы карта была полной: есть ещё два инструмента, которые ищут не в интернете и не в Schai, а в ваших личных данных, и оба требуют подключённого Google. Поиск по почте находит письма обычными словами — «найди письмо от Ивана про счёт», «что там от банка». Поиск по Диску устроен интереснее: он ищет файл и по названию, и по содержимому — на случай, когда вы помните, о чём там было, но не помните, как оно называется. Это его главное отличие от простого поиска документов, который смотрит только в имена файлов.
Ограничения: почему ИИ не прочитает весь интернет
Цифры здесь конечные, и это сознательный выбор. В агентном режиме на одну задачу отведено максимум десять шагов — модели на каждом шаге прямо сообщают, какой он по счёту. Поисковые инструменты — единственные, кому разрешено вызываться внутри задачи по нескольку раз: собрать комплект из шести предметов иначе невозможно. Остальным второй заход запрещён, это считается топтанием на месте.
Но и поискам разрешено не всё. Повторить тот же запрос теми же словами нельзя — только с другими. Повторный поиск по Schai на ту же тему просто отклоняется: результаты уже показаны выше, открывайте нужную ссылку. Если инструмент упал два раза подряд, он выключается до конца задачи — третья попытка будет стоить человеку ещё десять секунд ожидания и упадёт так же. А каждый заход в веб ограничен двадцатью пятью секундами: не ответил — идём дальше без него.
И главное ограничение, которое надо держать в голове: восемь заголовков со сниппетами — это не «прочитать интернет». Ассистент видит витрину, а не содержимое магазинов. Он не открывает страницы целиком, не листает PDF, не заходит за формы авторизации. Если ответ на ваш вопрос лежит на пятой странице отраслевого отчёта, поиск его не достанет.
Что делать, если нашлось не то. Не начинайте новый диалог — скажите прямо в этом же: «не то, это про другое, ищи по такому-то слову». Указание, набранное по ходу работы, система считает важнее исходной формулировки задачи и подчиняется ему сразу. Если источники кончились, у ассистента есть предписанный порядок отступления: повторить запрос проще, взять другой инструмент с тем же смыслом, и только потом — ответить собственными знаниями, явно пометив ответ как ориентировочный. Отвечать «попробуйте позже» ему запрещено, но и выдавать ориентир за факт — тоже.
Честные границы
Чего поиск не решает в принципе. Материалы за пейволлом остаются за пейволлом — ассистент увидит анонс и не увидит цифр. Закрытые данные (внутренние документы, непубличная статистика) не появятся в выдаче, сколько ни переформулируй. Противоречия поиск не разрешает, а только показывает: если два уважаемых сайта называют разные цифры, честный ответ — «данные расходятся, вот оба», и ждать стоит именно его, а не красивой определённости. И отдельная ловушка — региональность: найденная в вебе цена или срок доставки вполне могут относиться к другому городу.
Как спрашивать: плохо → лучше
Пять пар из практики. Разница между колонками — не в вежливости формулировки, а в том, включает ли она механизмы, которые мы разобрали выше.
❌ «Какая сейчас лучшая видеокарта?» → ✅ «Какая топовая игровая видеокарта в сентябре 2026 и сколько она стоит в рублях». Дата и валюта — два прямых маркера свежести; вдобавок вопрос про цену запускает цепочку из двух шагов: сначала узнать модель, потом её цену.
❌ «Что нового про нейросети?» → ✅ «Какие модели ИИ вышли с августа 2026, коротко про каждую». Слово «новости» тянет в выдачу главные страницы новостных порталов; конкретная тема плюс период дают конкретные материалы.
❌ «Расскажи про новый закон о маркировке» → ✅ «Что изменилось в правилах маркировки рекламы с 1 сентября 2026, со ссылкой на документ». Просьба о ссылке на документ заставляет ассистента показать источник, а вас — проверить его за минуту.
❌ «А подробнее?» → ✅ «Подробнее про второй вариант — про гарантию». Склейка с предыдущим вопросом работает, но на двух словах она угадывает тему, а на уточнённой фразе — знает её.
❌ «Есть у вас что-нибудь про музыку?» → ✅ «Найди в Schai статьи про сведение». Указан и вид материала, и слово, которое реально встречается в заголовках; поиск по подстроке другого и не умеет.
Общий принцип за всеми пятью парами: вы не «просите ИИ постараться» — вы даёте ему признаки, по которым он выбирает дорожку. Дата, валюта, период, тип материала, просьба показать источник: каждый стоит одного слова и экономит целый круг переспрашивания.
Коротко
• Модель знает мир на момент обучения. Поиск не добавляет ей ума, он добавляет свежести — и только там, где свежесть нужна.
• Решение «искать или нет» принимается по признакам вопроса: цена, дата, «сейчас», курс, новости, отзывы, расписание. На стабильном знании поиск не включается и правильно делает.
• Ищем через собственный SearXNG; возвращается восемь результатов — заголовок, адрес, сниппет. Страницы целиком не читаются.
• Ответ с поиском надёжнее, но не автоматически вернее: модель пересказывает найденное. Смотрите на блок «Источники» под ответом — домен говорит больше, чем уверенный тон.
• Поиск по Schai — про нашу сеть: посты, статьи, люди и каналы, товары, по шесть на вид, по вхождению слова. Спрашивайте словом, которое есть в тексте.
• Потолок на задачу — десять шагов; повторять поиск можно только с другими словами; дважды упавший источник выключается.
• Нашлось не то — скажите об этом в том же диалоге: указание по ходу работы важнее исходной формулировки.
Пока нет комментариев