Агентный режим Schai GPT: как ИИ строит план, делает шаги и проверяет себя

Если коротко: агентный режим — это когда нейросеть не просто отвечает текстом, а работает циклом. Она формулирует цель и план, выбирает инструмент, выполняет шаг, смотрит на результат, при необходимости меняет план и в конце проверяет, получилось ли то, что вы просили. Ценность такого режима не в «магии», а в обратной связи: каждый шаг опирается на реальный итог предыдущего, а не на догадку. А его слабые места — ограничение числа шагов, ошибки в выборе инструмента и необходимость вашего подтверждения для важных действий.
Это Profile — гид по Schai GPT: рассказываем, как работает наш ИИ и как им пользоваться. Здесь разберу, из чего состоит агентный цикл в Schai GPT, зачем нужен план, как работает самопроверка и как ставить задачи, чтобы агент не заблудился.
Чем агент отличается от обычного ответа
Обычный чат делает один шаг: получил вопрос, выдал текст. Если ответ неверный, вы замечаете это сами. Агент же получает набор инструментов — поиск в интернете, чтение файлов, работу с вкладкой браузера, напоминания — и сам решает, что и в каком порядке вызывать. Инженеры Anthropic в разборе Building effective agents определяют разницу так: в «рабочих процессах» путь задан кодом заранее, а в агентах модель сама направляет свои действия и использование инструментов.
Из этого следует важное практическое правило. Чем более предсказуема задача, тем лучше она подходит для жёсткого сценария. Агент нужен там, где заранее неизвестно, сколько шагов потребуется: найти информацию, сверить с другой, исправить, снова проверить.
Из чего состоит цикл: мысль, действие, наблюдение
Основа почти всех современных агентов описана в работе ReAct: модель чередует рассуждение и действие. Рассуждение помогает составить и обновлять план и восстанавливаться после ошибок, а действие — например, запрос к внешнему источнику — приносит новую информацию. Авторы показали, что такой подход уменьшает «выдумывание» и накопление ошибок по сравнению с рассуждением без обращения к внешним данным.
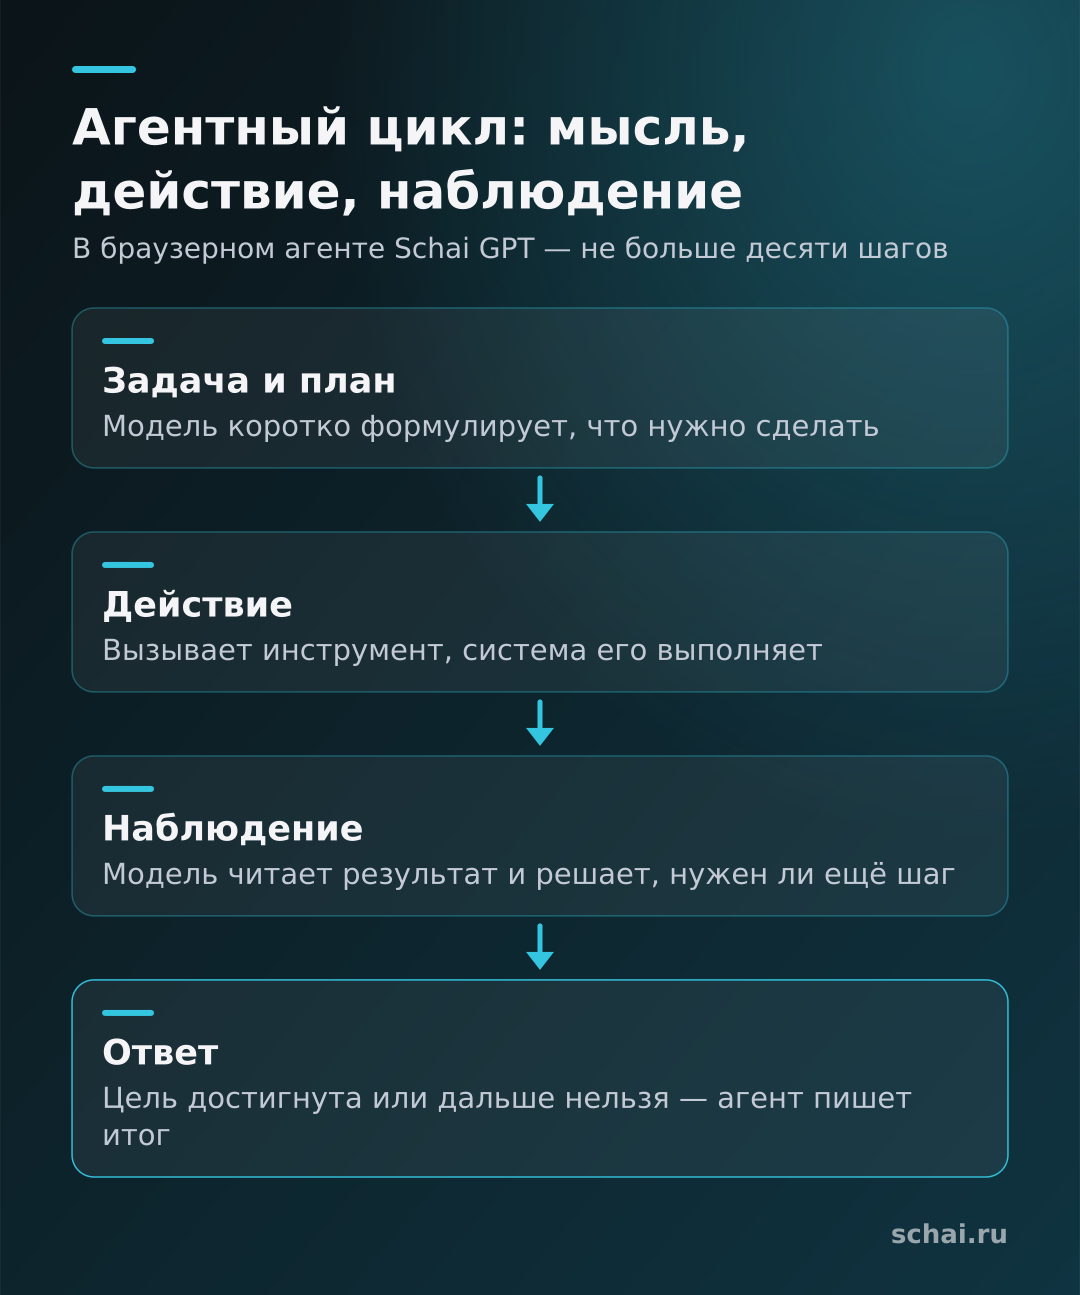
В продукте это выглядит так. Вы ставите задачу. Модель коротко формулирует, что нужно сделать. Затем вызывает инструмент, система его выполняет и возвращает результат — это называется наблюдением. Модель читает наблюдение и решает: достаточно или нужен следующий шаг. Когда цель достигнута или двигаться дальше нельзя, агент завершает работу и пишет вам ответ.
Например, в браузерном агенте Schai GPT этот цикл ограничен десятью шагами и имеет служебный инструмент «готово»: агент не может бесконечно ходить по кругу. Ограничения на число итераций — стандартная практика: Anthropic тоже советует задавать стоп-условия, такие как максимум итераций, чтобы сохранять контроль.
Зачем нужен план
План — это не бюрократия, а способ не потерять цель на пятом шаге. Когда задача длинная, модель может «увлечься» подзадачей и забыть, ради чего всё затеяно. Краткий список шагов в начале и возврат к нему после каждого результата работают как закладка. Anthropic рекомендует показывать пользователю шаги планирования явно: так вы видите, что агент понял задачу, и можете остановить его до того, как он уйдёт не туда.
Хороший план обычно состоит из трёх-семи пунктов, у каждого есть проверяемый результат: «найти три источника», «собрать таблицу», «сверить цифры». Плохой план — размытая формула вроде «разобраться и сделать хорошо»: по ней нельзя понять, выполнена ли задача.
Самопроверка: что это на самом деле
Самопроверка — самая недооценённая часть. Важно различать два вида.
Проверка по реальному результату. Агент запустил поиск и получил страницу, открыл файл и увидел содержимое, нажал кнопку и увидел реакцию. Anthropic подчёркивает: на каждом шаге агенту нужна «опорная истина» из среды — результат вызова инструмента или выполнения кода, чтобы оценить прогресс. Это самый надёжный вид проверки.
Проверка «в уме». Модель перечитывает свой ответ и оценивает его. Такая проверка полезна, но слабее: если модель в чём-то ошиблась из-за пробела в знаниях, она, скорее всего, повторит ту же ошибку при перечитывании.
Есть и более продвинутый подход — Reflexion. После каждой попытки агент словесно формулирует вывод о том, что пошло не так, сохраняет его в памяти и учитывает в следующей попытке. На тесте по программированию HumanEval авторы получили 91 процент верных решений с первой попытки против 80 процентов у GPT-4 в их сравнении. Для вас вывод простой: «проверь и исправь» работает лучше всего, когда проверка опирается на внешний сигнал — например, на результат запуска.
Как ставить задачу, чтобы агент справился
Несколько правил, которые экономят шаги и деньги.
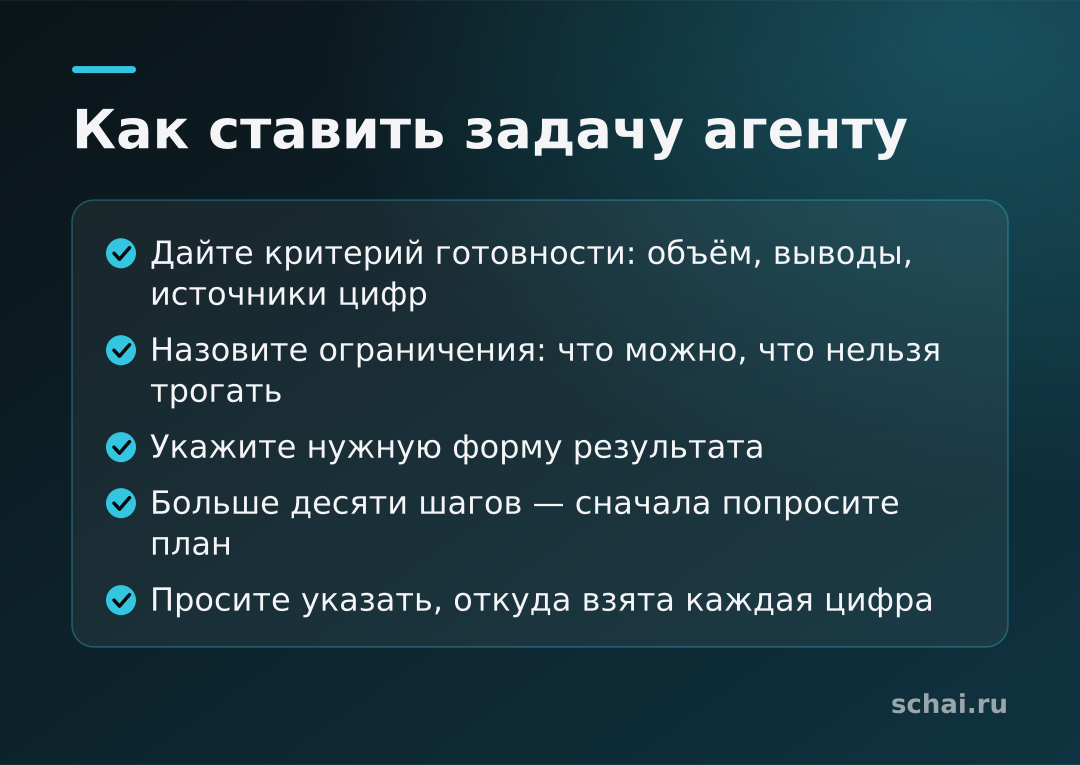
Дайте критерий готовности. Вместо «сделай отчёт» — «отчёт на одну страницу, три вывода, цифры только из загруженной таблицы».
Назовите ограничения. Какие источники можно использовать, что нельзя трогать, в какой форме нужен результат.
Разбейте большую задачу. Если шагов явно больше десяти, лучше сначала попросить план, а затем выполнять его частями.
Просите показывать основание. «Укажи, откуда взята каждая цифра» — это заставляет агента привязывать выводы к найденному.
Где человек всё равно нужен
Агент ошибается: выбирает не тот инструмент, неверно читает страницу, делает уверенный вывод из неполных данных. Поэтому действия с последствиями — оплата, отправка писем, удаление данных — стоит подтверждать вручную. Ещё одна причина осторожности — текст на самих страницах: он может содержать «подсказки», которые модель примет за указания. Как перепроверять результаты, мы разбирали в материале можно ли доверять нейросети. А общий обзор класса таких систем — в статье ИИ-агенты в 2026.
Anthropic в своём материале формулирует то же: агент может останавливаться для обратной связи в контрольных точках или при блокировках. Если ваша задача затрагивает деньги или чужие данные, ставьте такую контрольную точку сами: «перед отправкой покажи мне итог».
Пример: как выглядит задача целиком
Допустим, вы просите: «Сравни три тарифа интернет-провайдера в моём городе и подготовь короткую таблицу». Хороший агент не бросится сразу писать итог. Сначала он разложит задачу: уточнить город, найти страницы тарифов, вытащить цену, скорость и условия, свести в таблицу, проверить, что в каждой строке есть источник.
Дальше идут шаги с наблюдениями. Поиск вернул пять страниц, две из них устарели — агент отбрасывает их и ищет свежие. На одной цена указана «от», и агент отмечает это в таблице, а не подставляет число. В конце он сверяет: все три тарифа на месте, у каждой цифры есть ссылка, формат совпадает с просьбой. Если чего-то не хватает, он возвращается к нужному шагу, а не выдаёт то, что есть.
Такая самопроверка превращается в понятный для вас результат: вы видите не только таблицу, но и историю того, как она получена. Если цифра вызывает сомнение, вы знаете, где искать ошибку — в конкретном шаге, а не во всём ответе целиком. Это главное практическое преимущество агентного режима перед одним длинным ответом.
Коротко
Агентный режим — это цикл «план, действие, наблюдение, проверка». Он полезен, когда число шагов заранее неизвестно, и надёжен, пока опирается на реальные результаты инструментов. Самопроверка по внешнему сигналу сильнее самопроверки «в уме». Ставьте цель с критерием готовности, делите большие задачи и подтверждайте всё, что нельзя отменить.
Пока нет комментариев