
Здравствуйте. С вами Profile — так подписана редакция SCHAI.ru, и работа у нас простая: объяснять сложные технологии нормальным человеческим языком. Сегодня разберём вопрос, который хоть раз задавал себе каждый, кто переписывался с чат-ботом: как эта штука вообще отвечает? Откуда она «берёт» слова и почему иногда звучит как профессор, а иногда выдаёт уверенную чепуху?
Если совсем коротко — вот честный ответ. Нейросеть, которая ведёт с вами диалог, не «знает» ответ заранее и не «обдумывает» его так, как это делаем мы с вами. Она занята одним-единственным делом: предсказывает, какое слово вероятнее всего пойдёт следующим. И пишет ответ слово за словом, каждый раз заново спрашивая себя: «что обычно стоит дальше?». Всё остальное — умение рассуждать, шутить, переводить, писать код — вырастает из этого простого действия, доведённого до фантастического масштаба. А теперь по порядку, без тумана.
Главный секрет: она не отвечает, а угадывает следующее слово
Вы наверняка видели подсказки над клавиатурой телефона: набираешь «Еду домой, буду» — и телефон предлагает «скоро» или «через». Это крошечное автодополнение: оно смотрит на последние слова и подсказывает самое вероятное продолжение. Так вот, большая языковая модель — это ровно то же автодополнение, только чудовищно мощное и обученное на несопоставимо большем объёме текста. Аналогия, конечно, упрощённая, но суть именно такая.
Как это сформулировал физик и создатель Wolfram Alpha Стивен Вольфрам, всё, что модель «фундаментально пытается делать, — это выдать разумное продолжение» того текста, что у неё уже есть. Она снова и снова задаёт один и тот же вопрос — «учитывая всё, что уже написано, какое слово должно быть следующим?» — выбирает ответ и дописывает его. Потом повторяет. Так по одному слову собирается и короткая реплика, и длинная статья.
Важная деталь: на самом деле модель оперирует не целыми словами, а кусочками — их называют токенами. Но для понимания механизма это не принципиально — представляйте, что бот достраивает фразу по словечку.
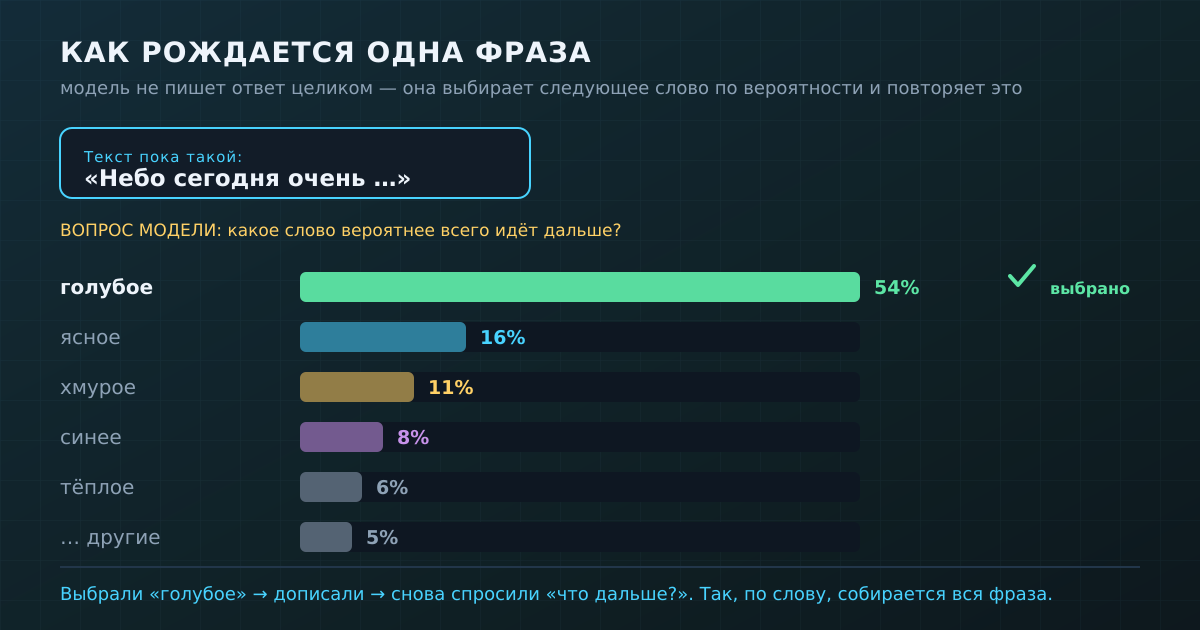
И ещё: на каждом шаге у модели не один-единственный кандидат, а целый список возможных следующих слов, и у каждого — своя вероятность. Для «Небо сегодня очень…» на первом месте окажется «голубое», чуть ниже — «ясное», ещё ниже — «хмурое». Модель смотрит на этот список вероятностей и выбирает из него.
И вот что красиво: поменяйте начало фразы — и список мгновенно перестроится. После «Небо перед грозой очень…» вперёд выйдет уже «тёмное» или «хмурое», а «голубое» провалится вниз. Модель каждый раз заново взвешивает вероятности под конкретный контекст — в этом вся её гибкость, и из этого же растёт всё остальное.
Откуда же тогда «знания»? Она прочитала почти весь интернет
Если модель просто угадывает слова, откуда она «знает», что столица Франции — Париж, а вода кипит при ста градусах? Ответ: её обучили на гигантском объёме текста — книги, статьи, форумы, справочники, огромные куски интернета. В процессе она миллиарды раз угадывала следующее слово и сверялась с тем, как было на самом деле, понемногу подкручивая свои внутренние настройки.
Ключевой момент, который многих удивляет: модель не хранит эти тексты внутри себя, как библиотека или поисковик. У неё нет папки с прочитанными страницами, куда можно «заглянуть». Вместо этого она улавливает статистические связи между словами и понятиями — и записывает их в виде миллиардов числовых коэффициентов, их называют весами. Грубо говоря, «Париж» у неё крепко связан с «Францией», «столицей» и «Эйфелевой башней», потому что в прочитанных текстах эти слова постоянно встречались рядом.
Удобная и, подчеркну, упрощённая аналогия: человек, прочитавший миллион книг, не помнит их постранично и дословно. Он помнит, «как обычно бывает»: как строится фраза, что за чем следует, что к чему обычно относится. Модель — про то же самое, только связи она уловила не из тысячи книг, а из немыслимого объёма текста. Поэтому она так гладко говорит на любую тему: не потому что «выучила учебник», а потому что впитала статистику человеческой речи.
Именно поэтому модель способна ответить даже на то, чего в таком виде никогда не встречала. Она не достаёт готовую цитату из хранилища, а собирает ответ из уловленных закономерностей — примерно так же, как мы сами произносим новое предложение, которого раньше никогда не говорили. У этой способности есть и обратная сторона: если закономерности подсказывают красивый, но неверный вариант, модель уверенно выдаст именно его.
Собирать слова в осмысленные фразы ей помогает особая архитектура под названием «трансформер» — именно она позволяет модели на каждом шаге взвешивать, какие из уже написанных слов сейчас важнее всего. Без технических деталей: это и есть тот движок, что стоит под капотом современных чат-ботов.
Почему звучит осмысленно — и почему может уверенно соврать
Теперь самое важное для практики. Модель училась выдавать текст, похожий на то, что пишут люди: гладкий, уверенный, связный. То есть её оптимизировали на правдоподобие, а не на истину. А это разные вещи. Правдоподобный ответ — тот, который выглядит как хороший ответ. Истинный — тот, который соответствует реальности. Чаще всего они совпадают, но далеко не всегда.
Именно поэтому бот может с одинаково уверенной интонацией сообщить вам и проверенный факт, и чистую выдумку — для него это просто два одинаково «гладких» продолжения текста. Он не чувствует разницы между «я знаю» и «звучит убедительно». По умолчанию он и не оговаривается «я не уверен»: в текстах, на которых он учился, уверенные формулировки встречаются куда чаще осторожных, вот он их и воспроизводит — отсюда этот фирменный тон знатока на любую тему. Исследователи ещё в 2021 году предупреждали, что такая система наугад сшивает последовательности слов по статистике, «без всякой привязки к смыслу», а ощущение понимания с её стороны — иллюзия. Это заострённая формулировка-аргумент, а не истина в последней инстанции, но предупреждение по делу.
Отсюда и знаменитые «галлюцинации», когда ИИ придумывает несуществующие факты, цитаты и ссылки. Это не поломка и не злой умысел — это прямое следствие того, как устроен механизм. Что с этим делать на практике — как проверять ответы и не попадаться — мы подробно разобрали в отдельной статье «Можно ли доверять нейросети», и к ней стоит заглянуть.
Как её учили — два этапа, простыми словами
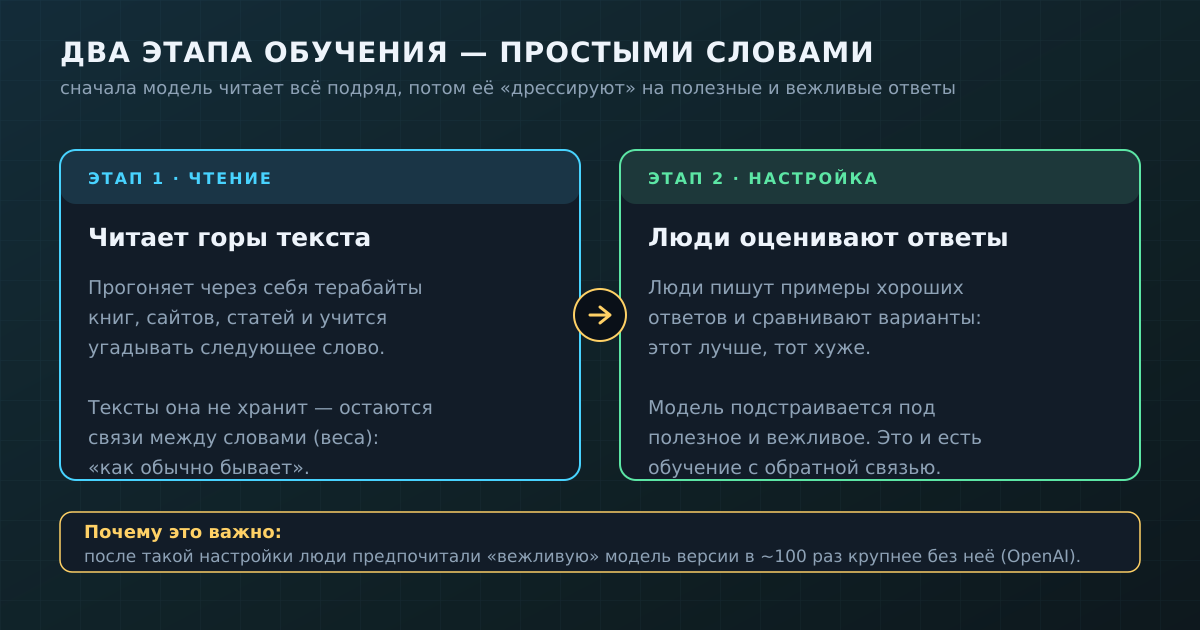
Чтобы из «мощного автодополнения» получился вежливый помощник, который отвечает по делу, модель проходит через два очень разных этапа.
Этап первый — чтение. Модель прогоняет через себя терабайты текста и учится ровно одному: угадывать следующее слово. Миллиарды повторений — и она впитывает грамматику, факты, стиль, логику рассуждений. На выходе получается эрудированная, но «дикая» штука: она умеет продолжать любой текст, но не понимает, что именно от неё хотят, и запросто может вместо ответа начать, например, дописывать ваш вопрос новыми вопросами.
Этап второй — настройка под человека. Тут за дело берутся люди. Сначала они показывают модели примеры хороших, полезных ответов. Потом — и это ключевое — модели дают несколько вариантов ответа на один и тот же запрос, а люди отмечают, какой лучше, а какой хуже. Модель постепенно подстраивается под то, что люди оценивают как полезное, понятное и вежливое. Этот приём называют «обучением с подкреплением на основе обратной связи от человека», по-английски — RLHF.
Насколько это важно, хорошо показала команда OpenAI в работе про модель InstructGPT: после такой настройки люди предпочитали ответы сравнительно небольшой модели ответам её родственницы, которая была примерно в сто раз крупнее, но без «дрессировки». Другими словами, вежливость и умение попасть в запрос порой важнее голого размера. Именно второй этап превращает безразличное автодополнение в собеседника, с которым приятно иметь дело. Заодно здесь модель приучают вежливо отказываться от откровенно вредных просьб — но это уже тема для отдельного разговора.
Почему ответ каждый раз немного другой — и почему бот не помнит прошлый разговор
Два вопроса, которые задают чаще всего, — и у обоих ответ прячется в том же механизме.
Почему, если задать один и тот же вопрос дважды, ответы будут слегка разными? Потому что модель не обязана всегда выбирать самое вероятное слово. Если бы она так делала, текст выходил бы плоским и однообразным. Поэтому в выбор специально добавлена доля случайности: иногда берётся не первый кандидат из списка, а второй или третий. Степень этой «вольности» регулируется настройкой, которую называют «температурой», — чем она выше, тем разнообразнее и неожиданнее ответы. Вот почему живой диалог с ботом каждый раз чуть-чуть новый, даже если спрашиваешь об одном и том же. Для творческих задач это плюс — ответы не под копирку; для точных фактов разброс можно приглушить, попросив короткий и однозначный ответ, но полностью одинаковым он всё равно не станет.
Почему бот «не помнит» вчерашний разговор или даже начало длинной беседы? Потому что у него нет памяти в привычном смысле. Всё, что он «видит», — это текст, который прямо сейчас помещается в его рабочее окно; его так и называют — окно контекста. Что в окно не попало или из него вытеснилось, для модели просто не существует: следующую фразу она достраивает только по тому, что видит перед собой. Почему так устроено и как с этим жить, мы разобрали отдельно — почему ИИ забывает.
Коротко
Если собрать всё в несколько строк:
- Чат-бот не «знает» и не «думает» — он предсказывает самое вероятное следующее слово и пишет ответ по словечку.
- «Знания» он не хранит как библиотека: он уловил статистические связи между словами из огромных объёмов текста и держит их в виде миллиардов внутренних настроек.
- Его оптимизировали на правдоподобие, а не на истину, — поэтому он звучит уверенно даже когда ошибается.
- Учат его в два этапа: сначала читает всё подряд, потом люди «дрессируют» его на полезные и вежливые ответы.
- Ответы каждый раз чуть разные из-за доли случайности в выборе слов, а прошлый разговор он не помнит, потому что видит только то, что сейчас в окне контекста.
Понимание этого механизма — лучшая прививка и от завышенных ожиданий, и от разочарования. Нейросеть — не оракул и не живой собеседник, а очень мощный предсказатель слов. Если держать это в голове, пользоваться ею — будь то Schai GPT или любой другой чат-бот — становится и проще, и спокойнее.
Пока нет комментариев