Нейросеть для Excel и Google Таблиц: почему ИИ должен считать кодом, а не в уме

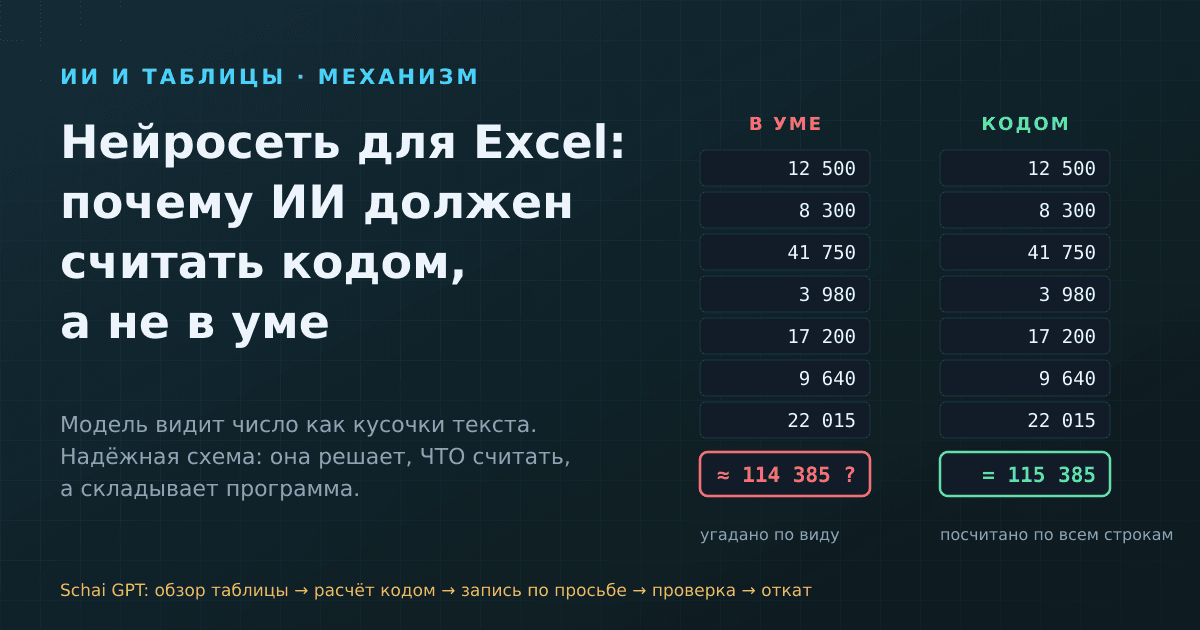
Если коротко: языковая модель не складывает числа, а угадывает, как выглядит правильный ответ. На двух-трёх ячейках это сходит с рук, на столбце из сотни строк — нет. Поэтому хорошая нейросеть для Excel и Google Таблиц устроена иначе: модель решает, что посчитать, а считает обычный код. После записи она перечитывает, что на самом деле получилось в ячейках, а правит сам файл — так формулы и оформление остаются на месте.
На связи Profile — на SCHAI.ru я объясняю, как устроены ИИ и сам Schai, без магии и без снисхождения. Сегодня тема, на которой обжёгся почти каждый, кто просил чат-бота «просто посчитать выручку по таблице»: ответ звучал уверенно, цифра выглядела правдоподобно — и не сходилась с тем, что показывал сам Excel. Разберёмся, почему так и что с этим делать.
Миф: «раз это компьютер, он посчитает точно»
Калькулятор и языковая модель — это два разных устройства, хотя оба живут в компьютере. Калькулятор складывает по правилам: разряд к разряду, с переносом. Модель правил сложения не хранит. Она читает текст кусочками-токенами и на каждом шаге выбирает, какой кусочек вероятнее всего идёт дальше. Подробно эту механику мы разбирали в статье про ошибки ИИ в простой математике — здесь важно другое: таблица делает эту слабость в разы заметнее.
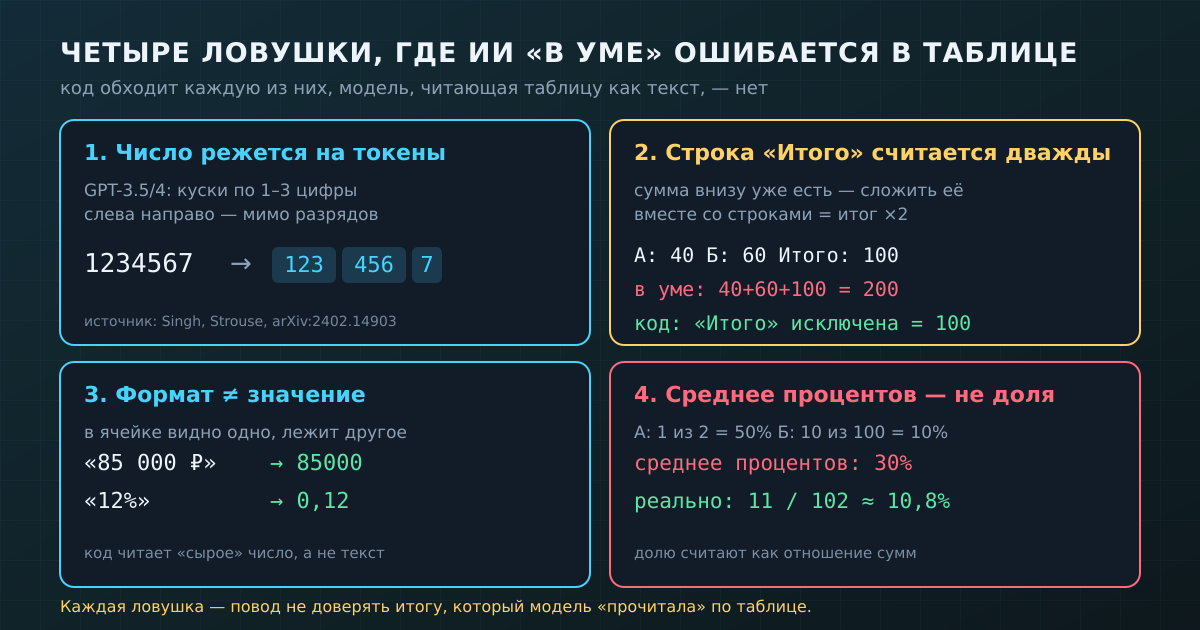
Первая причина — в том, как модель видит число. Исследователи из University College London и Google DeepMind в работе «Tokenization counts» показали: у GPT-3.5 и GPT-4 есть отдельные токены для чисел из одной, двух и трёх цифр, и длинное число режется на куски слева направо. Число 1234567 модель видит как «123 | 456 | 7» — куски не совпадают с разрядами. Если те же цифры разделить запятыми справа налево («1,234,567»), точность арифметики заметно растёт. Ошибки при обычной нарезке при этом не случайные, а повторяются по одним и тем же шаблонам.
Вот первое «ага»: модель плохо считает не потому, что «глупая», а потому, что видит число совсем не так, как мы. Мы видим тысячи, сотни и единицы, она — набор кусочков текста, нарезанных без оглядки на разряды. А в реальной таблице число ещё и обвешано форматом: «1 234,50 ₽», «12%», «03.10.2026». Каждое из них для модели — просто строка символов.
Почему в таблице ошибок больше, чем в одном примере
Один пример — это одно действие. Итог по столбцу — это сотни действий подряд, и каждое — шанс промахнуться. Модель не держит в голове промежуточную сумму, как калькулятор: каждый следующий шаг она снова угадывает по тексту. Ошибка в середине никуда не девается, и итог уходит в сторону — а звучит при этом так же уверенно, как правильный. Это родственник галлюцинаций: модель не врёт, она просто не умеет сказать «здесь я не уверена».
Но арифметика — только половина беды. В таблицах есть ловушки, о которые спотыкается даже аккуратный человек, а модель «в уме» — почти всегда.
Строка «Итого»
Внизу таблицы часто уже стоит сумма. Модель, которая читает столбец как текст, легко сложит её вместе с остальными строками — и итог выйдет ровно вдвое больше. Код это видит сразу: строку с «Итого» или «Всего» можно просто исключить из расчёта.
Формат и значение — не одно и то же
То, что вы видите в ячейке, и то, что в ней лежит, — разные вещи. В справке Google Sheets API это прямо разведено по режимам чтения значений: одна и та же ячейка может вернуться как «$1.23» (с форматом), как число 1.23 (без формата) или как формула «=A1». Если модель видит только отформатированный текст, ей ещё нужно догадаться, что «85 000 ₽» — это число 85000, а «12%» — 0,12.
Среднее процентов — это не процент
Самая коварная ловушка. Допустим, у менеджера А из 2 звонков 1 продажа — конверсия 50%. У менеджера Б из 100 звонков 10 продаж — 10%. «Средняя конверсия» по столбцу процентов — 30%. А на самом деле отдел сделал 11 продаж на 102 звонка, то есть около 10,8%. Разница почти втрое. Правильно считать долю как отношение сумм — продажи к звонкам, — а не усреднять готовые проценты. Модель «в уме» делает второе, потому что столбец с процентами прямо перед глазами.
Правильная схема: модель решает, что посчитать, а считает код
Решение нашли давно, и оно на удивление простое: разделить роли. Модель хорошо понимает вопрос на человеческом языке — «сколько продал каждый менеджер в октябре». Код хорошо считает. Значит, пусть модель переведёт вопрос в точное задание (отфильтровать по дате, сгруппировать по менеджеру, сложить столбец «Выручка»), а выполнит его программа.
Именно эту идею проверяли в работе PAL: Program-aided Language Models: модель пишет программу, а решает её интерпретатор Python. Авторы прямо формулируют проблему: модели неплохо раскладывают задачу на шаги, но ошибаются в логике и арифметике на этапе решения. Когда расчёт отдают интерпретатору, результат точнее, чем у моделей намного крупнее. Похожий подход Program of Thoughts отделяет рассуждение от вычислений и в среднем примерно на 12% обходит обычное пошаговое рассуждение — в том числе на наборах задач по таблицам и финансовым отчётам.
Второе «ага»: от модели не требуется научиться складывать. Достаточно, чтобы она правильно поняла, какие строки и какой столбец нужны. Это задача на понимание языка — то, в чём модели как раз сильны. А сложение двадцати тысяч чисел для кода — доли секунды и ноль ошибок.
Почему после записи надо перечитать таблицу
С чтением разобрались, но ИИ для таблиц Excel обычно просят не только посчитать, а ещё и поправить: «добавь столбец с маржой», «впиши итог внизу». Здесь появляется новая ловушка: модель уверена, что записала правильно, но знает это только таблица.
Формула может сослаться не на ту строку, разделить на пустую ячейку или сломаться при переносе — и в ячейке вместо числа окажется #REF! или #DIV/0!. В русскоязычной таблице аргументы формулы разделяются точкой с запятой, а не запятой, как в английской: формула «=SUM(A1,B1)» может просто не распознаться. Поэтому шаг «записал» — это ещё не конец. Нужно перечитать ячейки после записи и посмотреть, что в них на самом деле: значение, ошибка или вообще не то, что ожидали. Человек делает так машинально — глянул на ячейку и увидел #DIV/0!. ИИ должен делать то же явно.
Почему правка xlsx должна сохранять формулы и стили
Есть простой способ «поправить» Excel-файл через ИИ: прочитать его как текст, внести изменения и собрать новый файл. Выглядит похоже, но это уже другая таблица. Формулы превратились в готовые числа, заливки, шрифты и форматы исчезли, ширина столбцов сбилась.
Почему это хуже, чем кажется? В справке Microsoft о формулах есть важная мысль: если в формуле стоят константы, а не ссылки на ячейки, результат изменится, только когда изменят саму формулу. Ссылки на ячейки — это то, что делает таблицу «живой»: поменяли цену — пересчиталась маржа. Если же формулу заменить готовым числом, таблица продолжит его показывать, даже когда исходные данные давно поменялись. Ошибку при этом никто не заметит.
Отсюда правило: хорошая нейросеть для Excel открывает сам файл и меняет только те ячейки, о которых просили. Чужие формулы не трогает без разрешения, новым ячейкам даёт оформление соседних, итоги пишет формулой («=SUM(G4:G23)»), а не числом — чтобы таблица жила дальше.
Как это устроено в Schai GPT
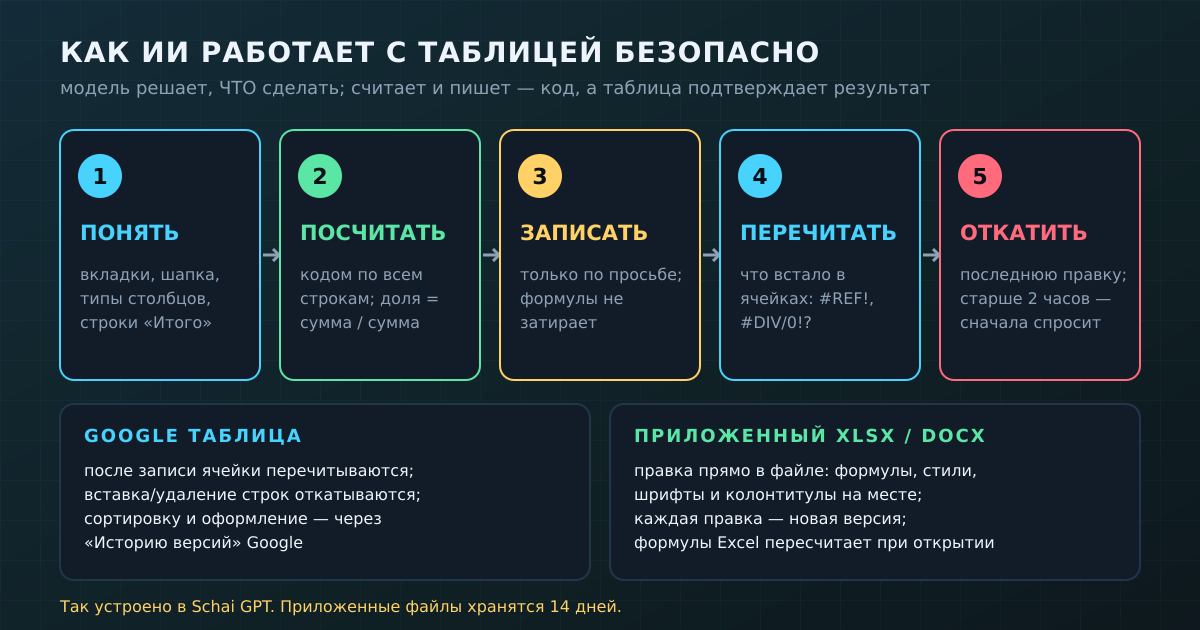
В Schai GPT ИИ для анализа таблиц Excel и Google работает по этой схеме. Можно дать ссылку на Google Таблицу или её название на Диске (для этого Google подключается в Личном помощнике), а можно просто приложить в чат файл xlsx или csv — для чтения и расчётов по нему Google не нужен. Вот что происходит внутри.
Сначала — понять таблицу
Первым шагом ИИ получает обзор: какие есть вкладки, в какой строке шапка, какие столбцы и какого они типа — число, деньги, процент, дата или текст, — сколько в них заполнено, минимум, максимум, среднее, примеры значений и где стоят строки «Итого». Модель не гадает по названию столбца, что в нём лежит, — она видит профиль. Нужна конкретная строка («где Петрова», «заказ 1045») — есть поиск по всем вкладкам сразу, причём число ищется по значению: 85000 найдёт и «85 000 ₽».
Считает код, а не модель
Любые итоги — суммы, средние, количество, медиану, минимум и максимум, топ-N, группировку «по менеджерам» и фильтры «за период» — считает программа по всем строкам вкладки. Числа берутся «сырыми», без формата, а текстовые «1 234,5 ₽» и «12%» приводятся к числам. Строки «Итого» в расчёт не входят. Для конверсий и долей есть отдельный расчёт как отношение сумм — ровно та ловушка с 30% вместо 10,8%. Модели прямо сказано: в уме не складывать и готовые числа не пересчитывать.
Записывает — только если вы попросили
Если в сообщении нет просьбы изменить («впиши», «добавь», «исправь», «оформи», «удали» и т. п.) или короткого «да» в ответ на предложение записать, ИИ таблицу не трогает и так и отвечает: менять не стал, вы просили только посмотреть. Перед записью он смотрит место, а ячейки с формулами не затирает — без явного разрешения запись в них просто не пройдёт. Формулы модель пишет как в английском Excel, а под русскую таблицу их переводит сервер. Формулу на весь столбец ИИ пишет один раз, а вниз её протягивает сервер, сдвигая адреса, как при протягивании в Excel.
После записи в Google Таблицу ячейки перечитываются, и модель видит, что получилось, включая ошибки вроде #REF! и #DIV/0!. Если вставить строку перед «Итого», а формула итога её не захватывает, ИИ получит предупреждение. Вкладку ИИ удаляет только по прямой просьбе «удали», а в Google Таблице ту, на которую ссылаются формулы других вкладок, не удалит вовсе — иначе там появились бы #REF!.
Структура и оформление
В Google Таблицах ИИ умеет вставлять и удалять строки и столбцы, сортировать диапазон, объединять ячейки, менять ширину столбцов, закреплять строки и столбцы, включать фильтр. Оформление — жирный и курсив, цвет заливки и текста, формат чисел (проценты, деньги, даты), автоширина — доступно и для Google Таблиц, и для приложенного xlsx.
Откат — с оглядкой на время
«Верни как было» откатывает последнюю правку, повторная просьба — предыдущую. В Google Таблице так отменяются запись и дописанные строки, вставка и удаление строк и столбцов (удалённое возвращается вместе с формулами), добавление и переименование вкладки. Если последняя правка старше двух часов, ИИ сначала спросит, её ли откатывать: просьба «отмени» почти всегда про только что сделанное. Сортировку, оформление и удаление вкладки так не отменить — для них остаётся «История версий» Google.
Правка самого файла Excel и Word
Приложенный xlsx ИИ правит прямо в файле: формулы и оформление остальных ячеек остаются на месте, новая ячейка берёт оформление соседа, а пересчёт формул Excel сделает сам при открытии. Каждая правка — новая версия: обновлённый файл приходит в чат ссылкой, а прежнюю можно вернуть. С Word так же: ИИ заменяет слова и цифры (оформление куска сохраняется), вставляет или удаляет абзац, добавляет строку в таблицу — шрифты, стили, колонтитулы и картинки не трогаются. Приложенные файлы хранятся 14 дней.
Честное ограничение: в приложенном Excel сервер формулы не вычисляет, поэтому результат новой формулы видно только после открытия файла. Если правка серьёзная — откройте и проверьте глазами. А вот сортировать, объединять ячейки и закреплять строки пока умеет только Google-версия. Если же нужен новый документ с нуля, это другая задача — о ней мы писали отдельно.
Как проверить любую нейросеть для таблиц
Из механизма проверка следует сама. Спросите сумму по столбцу, где внизу уже есть «Итого», — не удвоилась ли она. Попросите среднюю конверсию по менеджерам с очень разным числом звонков — посчитано отношение сумм или среднее процентов. Попросите дописать итог — встала формула или голое число. Попросите «просто посмотреть» — не поменялось ли что-нибудь в таблице. И сверьте одну цифру с тем, что показывает сам Excel: если ИИ считает кодом, совпадение будет до копейки.
Коротко
— Языковая модель видит число как набор кусочков текста, нарезанных без учёта разрядов, поэтому длинную арифметику она угадывает, а не считает.
— В таблице ошибок больше: сотни шагов подряд, строка «Итого», формат вместо значения, среднее процентов вместо доли.
— Правильная схема: модель понимает вопрос и решает, что посчитать, а считает код — это подтверждают исследования PAL и Program of Thoughts.
— После записи таблицу нужно перечитать: только она знает, встало число или #DIV/0!.
— Править надо сам файл, а не пересобирать его: формулы делают таблицу живой, готовое число — нет.
— В Schai GPT так и устроено: обзор, поиск, расчёт кодом, запись только по просьбе, защита формул, откат и правка самих xlsx и docx.
Пока нет комментариев