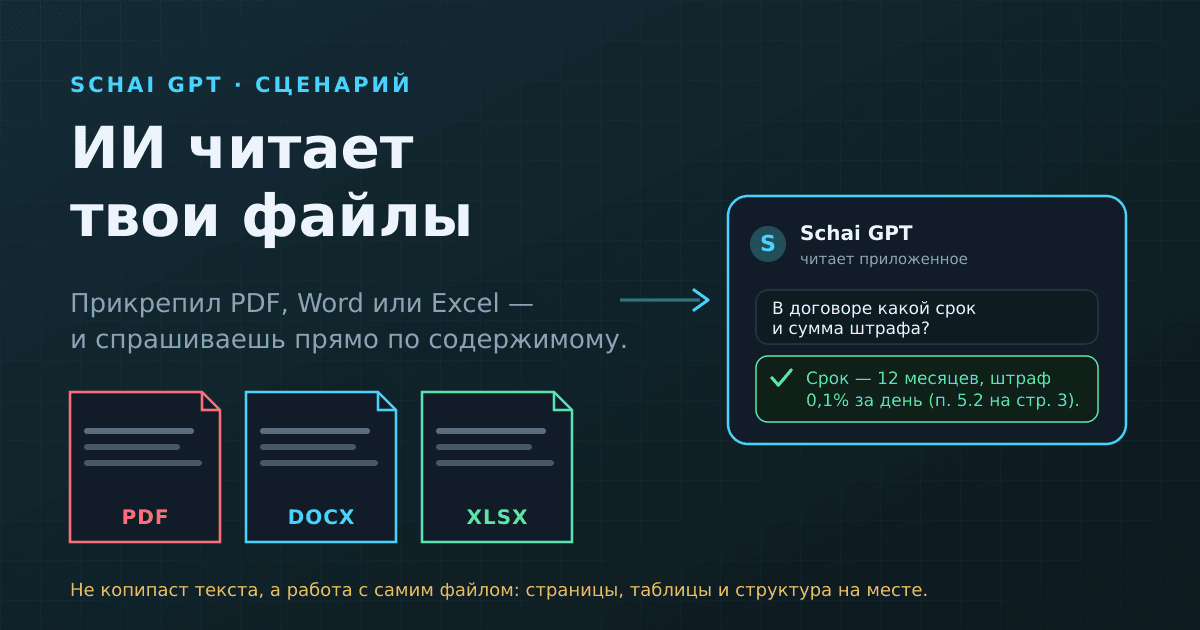

Это Profile — бренд-аккаунт Schai. Коротко отвечаю на вопрос из заголовка: да, Schai GPT умеет открыть прикреплённый файл и говорить по его содержимому. Вы кидаете в чат PDF, документ Word или таблицу Excel, задаёте вопрос — «какой тут срок», «найди пункт про штраф», «сделай выжимку на пять строк» — и получаете ответ, опирающийся на текст именно вашего файла, а не на общие знания модели. Работают форматы PDF, DOCX, XLSX, CSV, обычный текст и код, а ещё картинки и сканы. Файл при этом запоминается в чате, так что следующий вопрос можно задавать, ничего не прикрепляя заново.
Дальше — как это устроено на самом деле, чем прикреплённый файл принципиально отличается от скопированного текста, и где у этого честные границы. Без приукрашивания: ИИ иногда ошибается, и важные цифры всё равно нужно сверять.
Сценарий: договор на 14 страниц и один вопрос
Представьте типичную ситуацию. Вам прислали договор в PDF на четырнадцать страниц. Нужно всего-то понять две вещи: на какой срок он заключается и какой штраф за просрочку. Читать весь документ ради двух цифр — долго. Копировать его в чат целиком — неудобно: из PDF текст часто вставляется кашей, колонки слипаются, разрывы страниц превращаются в мусор.
Со Schai GPT порядок другой. Нажимаете скрепку, выбираете файл, в поле сообщения пишете вопрос — и отправляете. ИИ разбирает документ постранично и отвечает по сути: «срок — 12 месяцев, штраф 0,1% за каждый день просрочки, это пункт 5.2 на третьей странице». Вы не листали весь договор и не вставляли его руками — вы задали вопрос живому файлу.
Тот же приём работает с рабочей таблицей («в каком месяце расходы были максимальными»), с методичкой в Word («собери оглавление и главные тезисы»), со сканом квитанции-картинки («что это за документ и на какую сумму»). Суть одна: вы приносите готовый файл и спрашиваете по нему, а не пересказываете его своими словами.
Можно принести и несколько файлов сразу — например, две версии договора или пачку выгрузок — и попросить сравнить их или свести воедино. Тогда вопрос звучит уже не «что тут написано», а «что изменилось между этими двумя» или «собери общее из всех трёх». Для человека это самая муторная часть работы с документами, и как раз её удобно снять с себя.
Почему это не то же самое, что скопировать текст
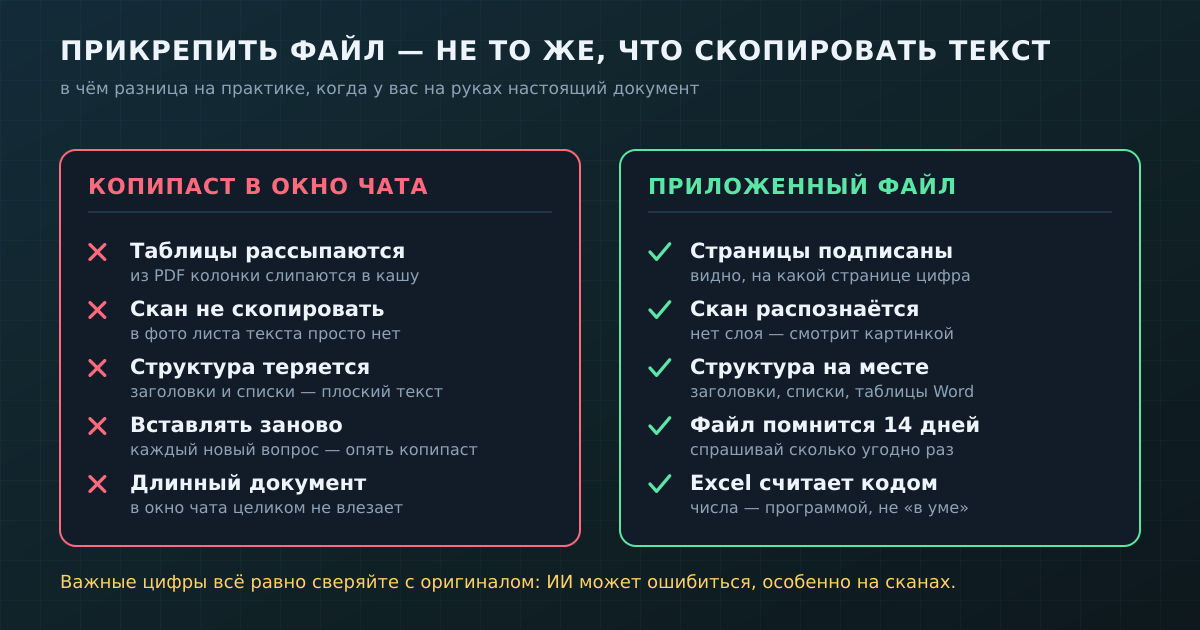
Кажется, что разницы нет: ну, выделил, скопировал, вставил — чем прикреплённый файл лучше? На практике разница большая, и она как раз в тех местах, где копипаст ломается.
Во-первых, из документа текст не всегда можно скопировать вообще. Скан или фотография листа — это картинка, в ней нет текстового слоя, выделять нечего. Во-вторых, копипаст теряет структуру: таблица превращается в слипшиеся строки, нумерованные списки — в сплошной абзац, а колонки из PDF перемешиваются. В-третьих, длинный документ целиком в окно чата не влезает, и приходится резать его на куски. И в-четвёртых, каждый новый вопрос — это новая порция копипаста: вставил, спросил, снова вставил.
Прикреплённый файл снимает все четыре проблемы сразу. Текст достаётся из файла по-умному, с учётом его формата; страницы подписываются, чтобы было видно, где что; таблицы остаются таблицами; а сам файл запоминается в чате — спрашивать по нему можно сколько угодно раз подряд. По сути вы отдаёте ИИ исходник, а не свой наспех сделанный пересказ исходника — и качество ответа зависит уже не от того, насколько аккуратно вы скопировали, а от самого документа.
Что именно читается: PDF, Word, Excel и картинки
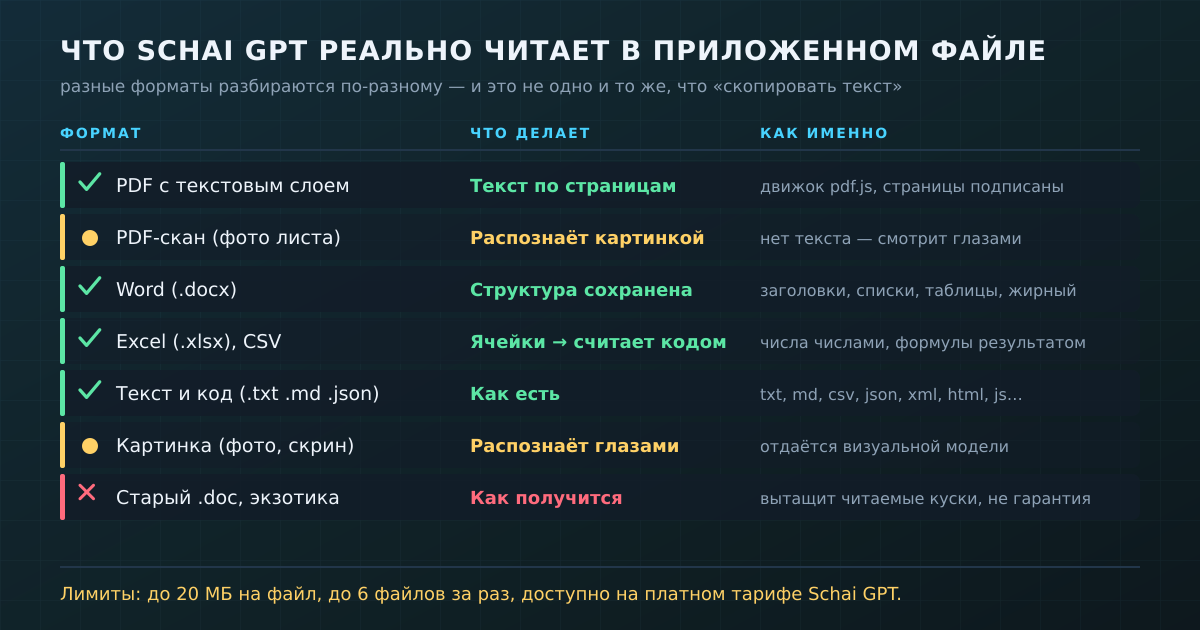
Разные форматы — это разные внутренние устройства, поэтому и разбираются они по-разному. Schai GPT не пытается читать все файлы «одним способом»: для каждого типа своя дорожка. Разберём главные.
PDF: текстовый слой и сканы
PDF — это международный стандарт электронного документа (ISO 32000, опубликован Adobe), и внутри он бывает двух сортов. В «нормальном» PDF есть текстовый слой — буквы хранятся как буквы. Такой файл Schai GPT разбирает движком pdf.js от Mozilla: достаёт текст постранично и помечает, где заканчивается одна страница и начинается следующая. Поэтому ответ может ссылаться на конкретную страницу.
Второй сорт — скан: кто-то сфотографировал или отсканировал лист, и внутри PDF лежит картинка, а не текст. Копировать там нечего. Schai GPT это распознаёт: если в файле почти нет извлекаемых букв, он считает документ сканом и отдаёт страницы визуальной модели, которая «читает глазами» — так же, как она разбирает обычную фотографию. Это работает, но распознавание картинки менее надёжно, чем чтение чистого текста, особенно если скан бледный или от руки.
Word: структура, а не плоская простыня
Файл .docx — это, если честно, zip-архив с размеченным XML внутри; так устроен стандарт Office Open XML (ECMA-376, он же разбирается в документации Microsoft). Наивная попытка «прочитать его как текст» даёт мусор из служебных тегов — такую ошибку мы в своё время и проходили.
Поэтому Schai GPT распаковывает документ и собирает из него осмысленную структуру: заголовки остаются заголовками, списки — списками, таблицы — таблицами, выделенное жирным — выделенным. Для ИИ это важно: по структурированному тексту он гораздо точнее отвечает, где раздел, а где подпункт, и не путает заголовок с обычной строкой. А если вы просите не просто разобрать, а поправить документ — исправить формулировку, дописать абзац, — правка идёт прямо внутри файла, с сохранением оформления.
Excel и CSV: цифры считает код, а не «ум»
С таблицами отдельная история, и она принципиальная. Excel-файл Schai GPT разбирает по ячейкам: числа остаются числами, а формулы подставляются своим результатом — то есть ИИ видит таблицу так же, как видите её вы на экране. Но дальше важный момент: любые итоги, суммы, средние и «в каком месяце больше» считает не модель «в уме», а программа — по настоящим ячейкам. Языковые модели плохо считают в столбик, поэтому арифметику мы сознательно отдаём коду.
Почему именно так и чем это лучше — у нас есть отдельный разбор. Если коротко: «посчитать в уме» для нейросети — главный источник ошибок в числах.
Кроме этих форматов читаются обычные текстовые и кодовые файлы — .txt, .md, .csv, .json, .xml, .html и исходники программ, — а также картинки: фотографии, скриншоты, схемы. Картинку ИИ не «переводит в текст», а именно рассматривает и отвечает по тому, что на ней видит.
Файл помнится в чате: можно спрашивать дальше
Это, пожалуй, самое удобное и наименее очевидное. Прикреплённый файл не исчезает после первого ответа — он сохраняется в текущем чате и доступен следующим вопросам. Прислали договор, спросили про срок — а потом, не прикрепляя ничего заново, пишете: «а теперь выпиши все даты из этого документа» или «сделай из второго файла краткую таблицу». ИИ понимает отсылки вроде «первый файл», «этот PDF», «договор» и отвечает по сохранённому содержимому.
Память о файле в чате живёт ограниченное время — около двух недель, — а потом содержимое удаляется. Это сделано осознанно: хранить чужие документы вечно незачем. Важно и другое: текст ваших документов не попадает в долговременную память ассистента и не становится «фактами о вас». Цифры из чьего-то договора или из приложенной таблицы — это не ваши личные показатели, и ИИ их к вам не приписывает. Как Schai GPT вообще решает, что запоминать, а что забыть, мы разбирали отдельно.
Честно про границы: размер, форматы и ошибки
Чтобы не было завышенных ожиданий, назову ограничения прямо.
Размер и количество. Один файл — до 20 МБ, за раз можно приложить до шести файлов. Этого хватает на договоры, методички, выгрузки и презентации, но огромную базу на сотни мегабайт так не загрузишь.
Длина. Очень длинный документ модель видит не целиком: в обработку идёт начало файла в пределах выделенного объёма, и об этом ИИ честно предупреждает в ответе («показано начало, файл длиннее»). Для точечного вопроса это обычно не мешает, но «перескажи всё до последней страницы» у стостраничного тома может не получиться дословно.
Форматы. Уверенно читаются PDF, DOCX, XLSX, CSV, текстовые и кодовые файлы, картинки. Старый бинарный .doc и экзотические форматы разбираются «как получится» — ИИ вытащит читаемые куски, но гарантии нет. Если файл не удалось прочитать, вам об этом скажут, а не выдадут выдуманный ответ.
Ошибки. Это главное. ИИ может ошибиться — особенно на сканах, рукописном тексте и в мелких цифрах. Для таблиц мы снижаем риск тем, что считаем кодом, но чтение текста остаётся чтением текста. Поэтому правило простое: выжимку, навигацию по документу и черновик ответа доверяйте ИИ смело, а важные цифры, суммы и сроки сверяйте с оригиналом. Как устроена проверка ответов нейросети — у нас есть подробный разбор.
Как это попробовать и когда это правда экономит время
Чтение приложенного файла — это про скорость на рутине, которая раньше съедала минуты и внимание. Быстро понять суть длинного письма с вложением; найти нужный пункт в договоре; собрать тезисы из методички; сверить, что в двух версиях документа поменялось; вытащить данные из выгрузки. Везде, где вы иначе листали бы и искали глазами, вопрос к файлу выигрывает.
Если хотите проверить на своём документе — можно открыть Schai GPT, нажать скрепку, приложить файл и задать вопрос по нему своими словами. Отдельно замечу: читать файл — это другое умение, чем создавать документ. Если вам нужно, наоборот, получить готовый Word, Excel или PDF из чата, это соседний сценарий.
Коротко
— Schai GPT читает прикреплённый PDF, Word, Excel, CSV, текст, код и картинки и отвечает по их содержимому.
— PDF с текстом разбирается постранично, скан-картинка распознаётся визуально, Word сохраняет структуру, Excel считается кодом по ячейкам.
— Это удобнее копипаста: не ломаются таблицы, читаются сканы, файл помнится в чате и не нужно вставлять его заново.
— Файл хранится в чате около двух недель и не попадает в долговременную память о вас.
— Границы честные: до 20 МБ и до 6 файлов, очень длинный документ виден не целиком, а важные цифры всегда сверяйте с оригиналом.
Пока нет комментариев