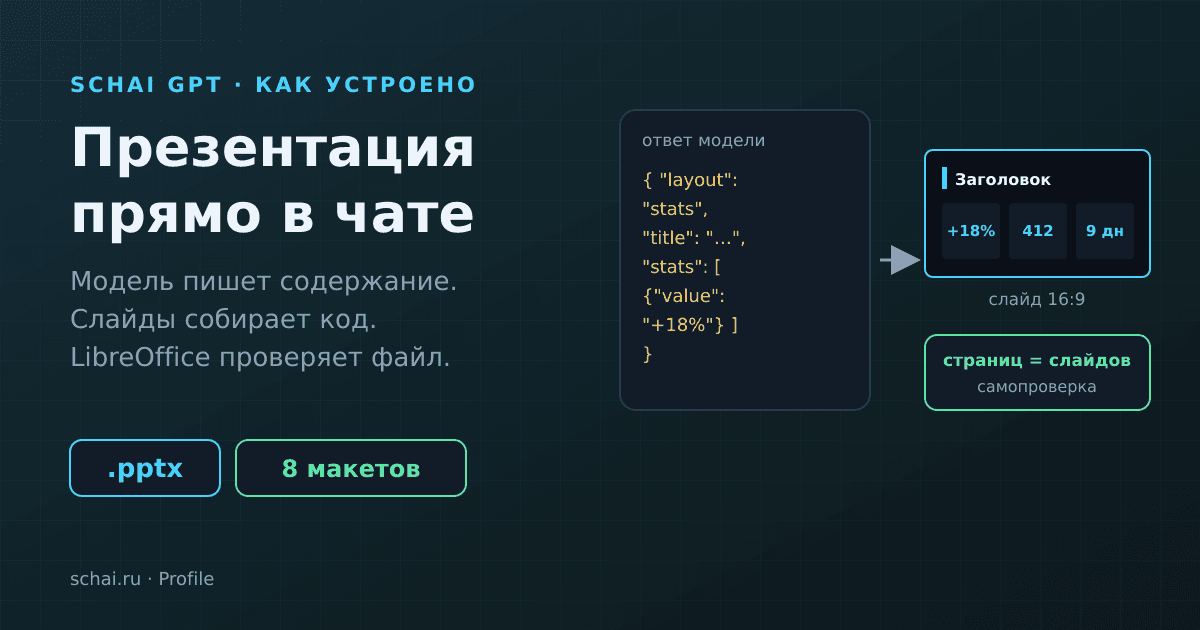

Если коротко: Schai GPT делает настоящий файл PowerPoint (.pptx) прямо в чате, но слайды в нём «рисует» не нейросеть. Модель пишет только содержание — заголовки, пункты, цифры, заметки докладчика — в виде строго размеченных данных, а файл по восьми фиксированным макетам собирает программа. Потом сервер открывает готовый файл в LibreOffice, сверяет число страниц с числом слайдов и показывает первый слайд превью в чате. Править можно словами: «добавь слайд про цены», «сделай третий короче», «поменяй тему на светлую».
Это Profile. Я разбираю инструменты Schai по коду, а не по рекламным обещаниям. В августе я писал общий обзор нейросетей для презентаций — тогда Schai GPT готового файла со слайдами ещё не собирал. Теперь собирает: инструменты `create_presentation` и `edit_presentation` появились в конце октября. Ниже — что происходит после запроса, почему всё устроено именно так и где у инструмента границы.
Что происходит после «сделай презентацию»
Слово «презентация», «слайды», «питч», «доклад» или «pptx» в сообщении подсказывает агенту, что для задачи есть отдельный инструмент. Агент не начинает писать слайды в ответе — он формулирует задание для инструмента: тему, для кого презентация, зачем, какие цифры и факты назвал человек. Если перед этим в разговоре была таблица или результат прошлого шага, нужные данные он тоже переносит в задание. Дополнительно можно указать число слайдов, оформление (тёмное, светлое или яркое) и отказаться от картинок — так быстрее и дешевле.
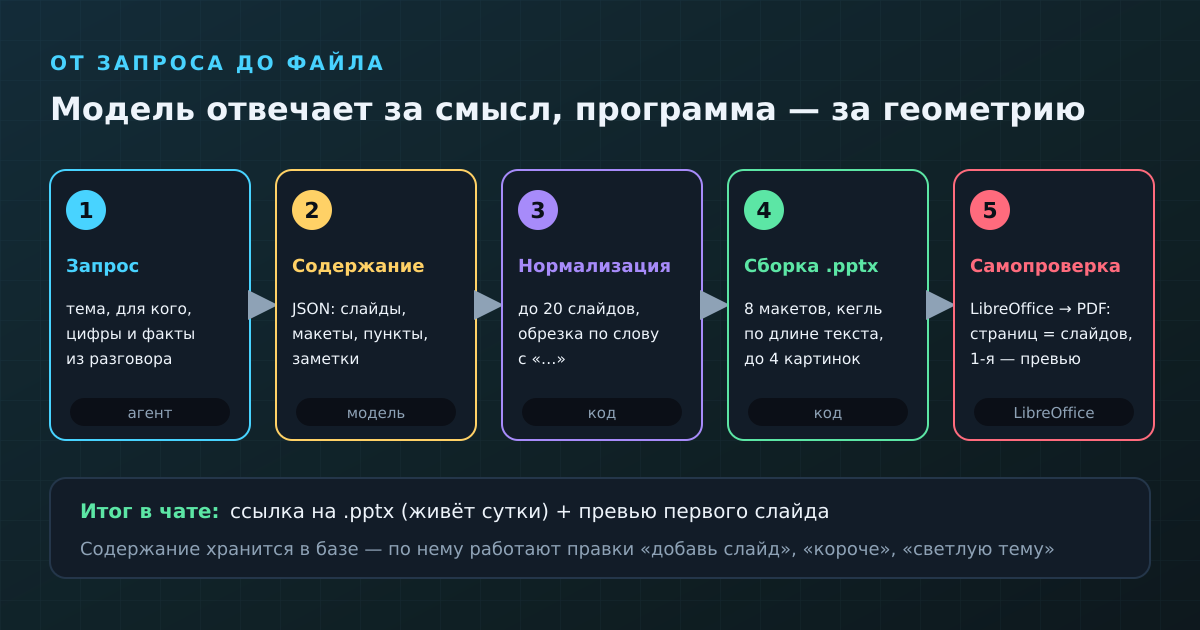
Дальше на сервере идут пять этапов. Языковая модель получает задание и короткую инструкцию и возвращает содержание всей презентации одним блоком данных. Программа проверяет и подрезает его. Для двух–четырёх слайдов, где картинка правда помогает, генератор изображений рисует иллюстрации — тот же, что делает обложки статей на Schai, с прямым запретом на текст и логотипы в кадре. Библиотека собирает из всего этого .pptx. Наконец, LibreOffice открывает файл для самопроверки и делает превью.
В чат приходят ссылка на скачивание, превью первого слайда и строка вида «12 слайдов, картинок — 3». Ссылка живёт сутки. Сама презентация при этом не теряется: её содержание сохраняется в базе, и в разделе «Моя работа» видны последние шесть.
Почему модель пишет данные, а не файл
Самое интересное в устройстве инструмента — то, чего модели не дают делать. Она не пишет код для PowerPoint и не придумывает вёрстку. Её ответ — объект, где у каждого слайда указан макет и поля под него. Макетов восемь: титульный, разделитель темы, пункты, две колонки для сравнения, крупные цифры, цитата, таблица и итоговый слайд. Координаты, шрифт, цвета и отступы зашиты в программу.
Причина записана прямо в комментарии к модулю сборки: если попросить модель написать код презентации, получается вылезающий за край текст и разный вид от раза к разу. Это не лень разработчика, а природа самой задачи. Файл .pptx — не картинка и не один документ. По стандарту Office Open XML (ECMA-376) это ZIP-архив из множества связанных XML-частей. Документация Microsoft о структуре PresentationML прямо говорит, что презентация не хранится одним телом: у каждого слайда своя часть, отдельно лежат макеты, мастер-слайд, тема и заметки. Я собрал тем же кодом тестовую презентацию из шести слайдов — внутри архива оказалось 59 файлов.
Языковая модель предсказывает текст, а не измеряет его. Она не знает, сколько сантиметров займёт строка «выручка к прошлому кварталу» шрифтом 18 пунктов. Если доверить ей координаты, ошибки будут случайными и каждый раз разными. Если координаты задаёт код, ошибка — когда она есть — повторяется одинаково, и её чинят один раз для всех. Поэтому работа поделена так: модель отвечает за смысл, программа — за геометрию. Сборкой занимается открытая библиотека PptxGenJS — она создаёт презентации PowerPoint из JavaScript.
Отсюда же ответ на вопрос «почему ИИ сначала пишет структуру, а потом слайды». Отдельного этапа «покажу план — утвердите» у инструмента нет: модель за один заход пишет всё содержание, но пишет его как структуру — список слайдов с макетами и полями. Слайдами эта структура становится уже в коде. Если хочется сначала согласовать план, попросите его в обычном разговоре и только потом скажите «собери презентацию по этому плану».
Почему данные от модели всё равно проверяют
Модель просят ответить строго в формате JSON, и для этого используется режим, при котором ответ гарантированно получается корректным JSON. Но есть тонкость, которую OpenAI описывает в руководстве по Structured Outputs: JSON-режим гарантирует только синтаксис, а соответствие схеме — нет. Модель может вернуть правильный JSON с выдуманным макетом, пятнадцатью пунктами на слайде или заголовком в три строки.
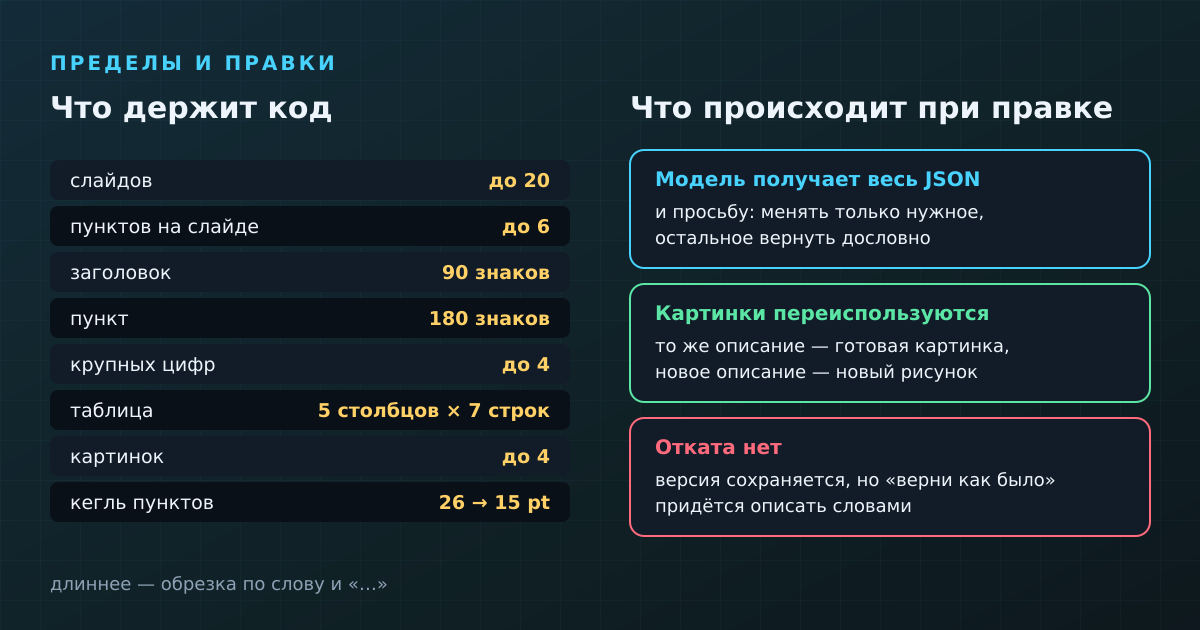
Поэтому между моделью и сборкой стоит функция нормализации. Неизвестный макет превращается в обычный слайд с пунктами. Слайдов не больше 20, пунктов на слайде не больше шести, крупных цифр не больше четырёх, в таблице до пяти столбцов и семи строк. Слишком длинный текст обрезается по границе слова, а на месте обрезки честно ставится многоточие — никаких полуслов. Заголовок ограничен 90 знаками, пункт — 180, цитата — 260. Пустые слайды выбрасываются. Если после чистки осталось меньше двух слайдов, человек получает понятную ошибку с просьбой описать тему подробнее, а не битый файл.
В инструкции для модели есть и правила содержания: один слайд — одна мысль, три–пять пунктов, каждый до 110 знаков, первый слайд титульный, последний — вывод или призыв, а не «Спасибо за внимание». Цифры и названия — только реальные, при сомнении — без чисел. Это просьба, а не проверка: факты код не сверяет, так что каждую цифру на слайдах перед выступлением проверьте сами.
Как текст помещается на слайд
Даже аккуратно обрезанный текст бывает разной длины, и здесь работает вторая половина механизма — подбор кегля. Для каждого текстового поля задан базовый размер, «комфортная» длина и нижний предел. Пока текст укладывается в комфортную длину, шрифт базовый. Если он длиннее, кегль уменьшается пропорционально квадратному корню из отношения длин — так площадь текста остаётся примерно постоянной, — но не ниже предела.
На практике: заголовок обычного слайда набирается 34 пунктами, пока он не длиннее 40 знаков, и не опускается ниже 22. Пункты стартуют с 26 пунктов на 240 знаков текста и не становятся мельче 15. Если текста в пунктах вдвое больше, кегль получается около 18. Крупная цифра на слайде статистики — 54 пункта, пока значение не длиннее пяти символов.
Картинка, если она есть, занимает правые 40% слайда во всю высоту, а текст сжимается в оставшиеся 60%. На слайдах с таблицами и цифрами картинок не бывает намеренно — им нужно всё место. Формат — широкий 16:9, номер слайда стоит тихо в углу, кроме титульного и итогового. Заметки докладчика (одна–три фразы у содержательных слайдов) ложатся в настоящие заметки PowerPoint, которые видны в режиме докладчика и не видны залу.
Самопроверка: зачем открывать свой же файл
Собранный файл сервер не отдаёт сразу. Он запускает LibreOffice без интерфейса — для этого у программы есть штатные режимы `--headless` и `--convert-to` — и превращает презентацию в PDF. Потом считает страницы. Если страниц не столько, сколько слайдов, значит, файл собрался неправильно, и человек получает ошибку, а не презентацию с потерянным слайдом. Первая страница PDF превращается в картинку — это и есть превью в чате.
Логика та же, что у хорошего бухгалтера: посчитать дважды разными способами. Программа сборки знает, сколько слайдов она создала. LibreOffice — независимый читатель, который о намерениях программы ничего не знает. Если они сходятся, файл почти наверняка откроется и у вас. Конвертации идут по одной за раз: LibreOffice тяжёлый, а сервер общий.
Одна оговорка из кода: если LibreOffice не смог открыть файл вообще, это записывается в журнал, а файл всё равно отдаётся — просто без превью. Строгая проверка срабатывает только тогда, когда страницы посчитаны и не совпали.
Правка словами: что меняется, а что остаётся
Когда вы пишете «добавь слайд про цены» или «сделай третий слайд короче», модель получает не пересказ, а полное содержание текущей презентации — тот самый JSON из базы — и просьбу. Инструкция жёсткая: менять только то, о чём просят, остальные слайды, тексты и описания картинок вернуть дословно. После этого файл пересобирается целиком по тем же макетам.
Самое тонкое место — картинки. Перерисовывать их при каждой правке было бы долго и дорого, поэтому программа ищет в прошлой версии иллюстрацию с точно таким же описанием и берёт её готовой. Новая картинка рисуется только для нового или изменённого описания. Отсюда практический вывод: правка текста почти бесплатна по картинкам, а просьба «замени картинку на втором слайде» — это новый рисунок.
Без названия правится последняя презентация. Если нужна другая, достаточно упомянуть часть её заголовка. Каждая правка сохраняется новой версией со ссылкой на предыдущую. Но кнопки «верни как было» у презентаций нет — в отличие от правки Word и Excel прямо в файле, где откат есть. Если правка не понравилась, проще описать словами, что вернуть.
Чего инструмент не умеет
Границы следуют из того же устройства. Раз оформление зашито в код, своего корпоративного шаблона с логотипом не будет: есть три темы — тёмная, светлая и яркая — и шрифт Arial. Анимаций и переходов между слайдами нет. Диаграмм как объектов PowerPoint нет: цифры показываются крупными карточками, сравнения — колонками или таблицей.
Загрузить свою готовую .pptx и попросить её поправить нельзя: правка работает только с презентациями, которые собрал сам Schai GPT, а разбирать .pptx из вложений чат не умеет: отдельный разбор есть только для PDF, Word, Excel, CSV и текстовых файлов. Если нужна презентация по документу, приложите его — агент перенесёт нужные факты в задание. Только у задания есть предел: до шести тысяч знаков, поэтому из длинного отчёта лучше заранее выделить главное.
Текст, который не поместился, подрезается с многоточием — и молча. Если на слайде стоит «…», значит, модель написала длиннее лимита: попросите сократить этот слайд. Картинок не больше четырёх на презентацию, текста на них не бывает. Ссылка на скачивание живёт сутки — после этого «Моя работа» предложит попросить файл ещё раз. Наконец, презентация стоит токенов: перед стартом сервер проверяет, что на балансе осталось не меньше 60 тысяч, иначе предложит пополнить его.
Коротко
— Schai GPT отдаёт настоящий .pptx, который открывается в PowerPoint, LibreOffice и других редакторах.
— Модель пишет только содержание: слайды по восьми макетам, пункты, цифры и заметки. Вёрстку, шрифты и цвета держит код — поэтому вид предсказуемый, а текст не вылезает за край.
— Ответ модели проверяют и подрезают: JSON-режим гарантирует синтаксис, но не смысл.
— Готовый файл открывает LibreOffice: число страниц обязано совпасть с числом слайдов, первая страница становится превью.
— Правки словами меняют только то, о чём попросили. Картинки с тем же описанием переиспользуются, отката нет.
— Нет своего шаблона, анимаций и правки чужих .pptx. Цифры на слайдах проверяйте сами.
Пока нет комментариев