Почему ChatGPT долго думает и что происходит, пока крутится «Думаю…»

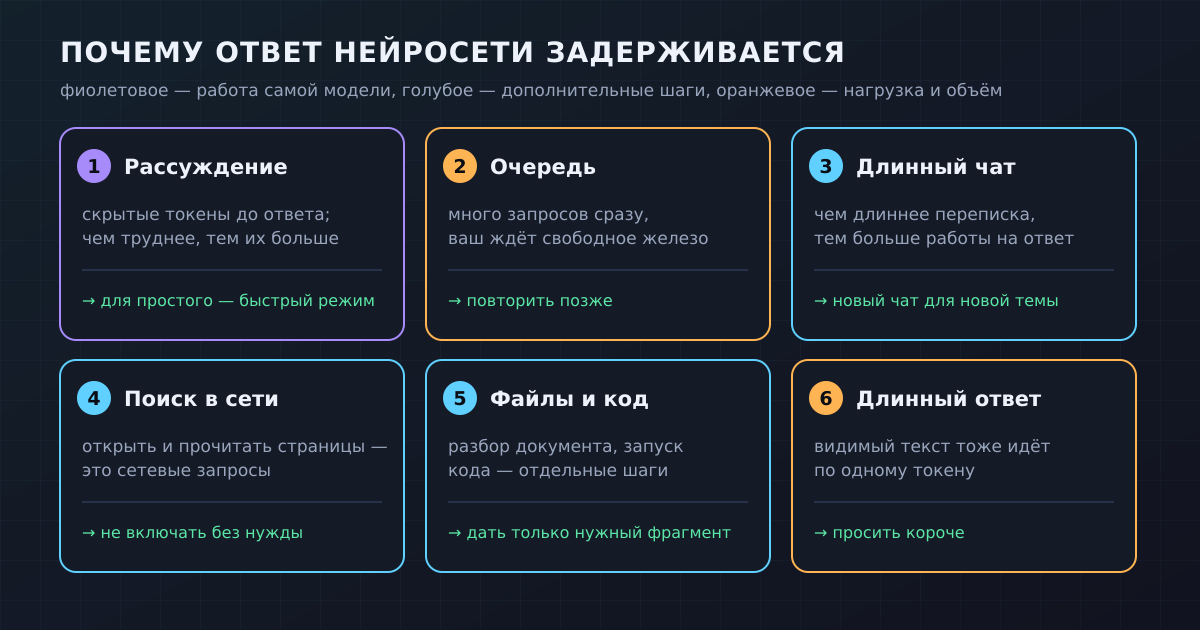
Если коротко: ChatGPT «долго думает», потому что перед ответом пишет черновик, которого вы не видите. Рассуждающая модель генерирует цепочку промежуточных шагов, слово за словом (точнее, токен за токеном), и только потом выдаёт короткий итог. Таких скрытых токенов бывают тысячи, и на каждый уходит столько же работы, сколько на слово видимого ответа. Поэтому на трудных задачах ответ точнее, но ждать дольше, а стоит он дороже. Остальные задержки дают очередь на серверах, длинная переписка, поиск в интернете и работа с файлами.
Это канал «Всё про ИИ и Роботов». В поиске Яндекса стабильно всплывает подсказка «почему чат гпт долго думает», и обычно за ней стоит раздражение: вопрос простой, а модель полминуты крутит индикатор. Сегодня разберём, что происходит внутри в эти секунды. Отдельно поговорим о двух популярных объяснениях, «он ищет в интернете» и «он думает, как человек», и о том, почему оба неверны.
Нейросеть пишет по одному токену, и каждый стоит целого прохода
Языковая модель не выдаёт ответ целиком. Она делает одну операцию: смотрит на весь текст, который уже есть, и предсказывает следующий кусочек. Такой кусочек называется токеном. Это часть слова, целое короткое слово или знак препинания. Предсказанный токен приписывается к тексту, и всё повторяется заново. Ответ из трёхсот слов означает несколько сотен таких шагов подряд.
Отсюда главное свойство, которое объясняет всю историю с «раздумьями»: время ответа растёт вместе с числом токенов, которые модель сгенерировала. Распараллелить эти шаги нельзя, потому что каждый следующий токен зависит от предыдущего. Пока не написано третье слово, четвёртое считать не из чего.
Посчитаем на условной скорости. Допустим, модель выдаёт 50 токенов в секунду. Тогда абзац на 150 токенов появится за три секунды, и вы этого почти не заметите: текст бежит на экране, ждать не скучно. А теперь представьте, что перед этим абзацем модель написала ещё 5 000 токенов, которые вам не показали. Это уже около ста секунд тишины. Именно это и происходит, когда ChatGPT «думает».
Что такое скрытая цепочка рассуждений
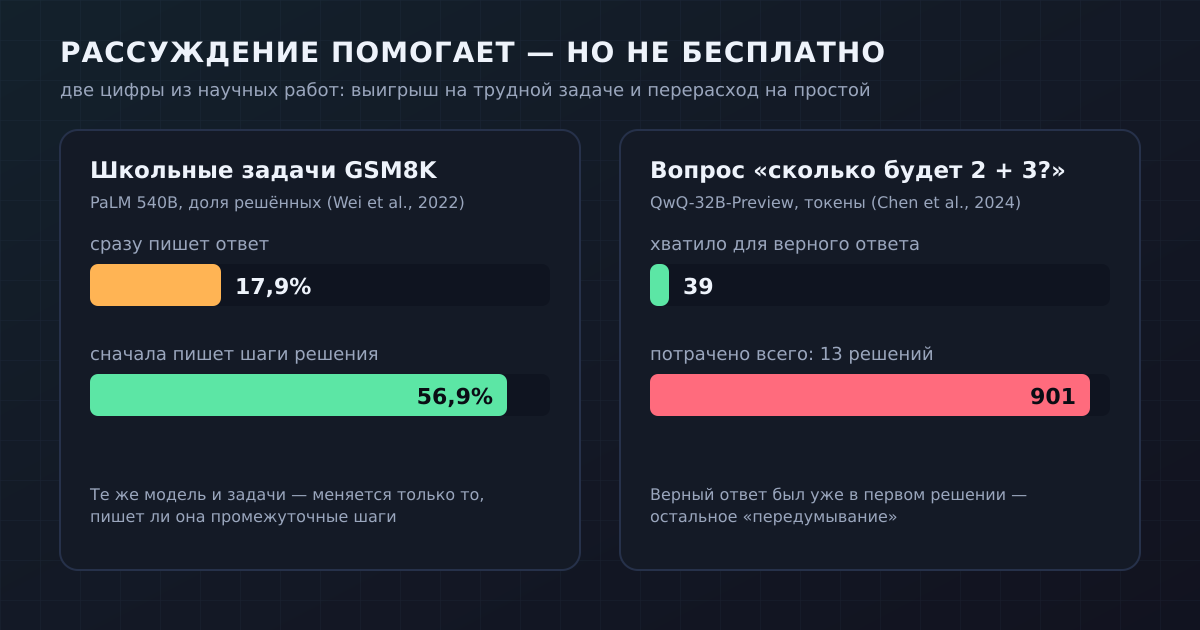
Идея появилась задолго до нынешних «думающих» моделей. В 2022 году исследователи Google показали, что модели решают задачи заметно лучше, если в примерах им показать не только ответ, но и ход решения. В работе Джейсона Вэя и соавторов о chain-of-thought модель PaLM на 540 миллиардов параметров на наборе школьных текстовых задач GSM8K решала 17,9% задач, когда отвечала сразу, и 56,9%, когда сначала расписывала шаги. Модель и задачи были одни и те же, разница была только в формате ответа.
Почему это работает, понятно из предыдущего раздела. На один токен у модели одинаковый, фиксированный объём вычислений. Если задача требует пяти действий, а ответ должен уместиться в одно число, все пять действий приходится «провернуть» за один шаг, и модель часто ошибается. Когда она выписывает промежуточные результаты, каждый становится частью текста, и следующий шаг опирается на уже записанное. Черновик служит модели рабочей памятью.
Рассуждающие модели (у OpenAI это серия o1 и её наследники, у Anthropic это Claude с режимом extended thinking, у Google это Gemini с thinking) пошли дальше: их специально учат писать такой черновик перед каждым ответом. В системной карточке OpenAI o1 это сформулировано прямо: модель «думает, прежде чем ответить», может выдать длинную цепочку рассуждений до ответа пользователю, и обучается она этому через обучение с подкреплением. В ходе такого обучения модель учится пробовать разные стратегии и замечать собственные ошибки.
Пользователь этот черновик целиком не видит. В документации OpenAI для разработчиков сказано, что токены рассуждения не возвращаются через API, но занимают место в контекстном окне и оплачиваются как выходные токены. В интерфейсе ChatGPT вместо черновика вы видите индикатор и, возможно, краткую выжимку хода мысли. Сам черновик при этом может быть в десятки раз длиннее ответа.
Больше раздумий — точнее ответ: это и называют test-time compute
Долгое время модели улучшали одним способом: делали их больше и учили на большем объёме данных. Все эти вычисления тратятся заранее, во время обучения. Рассуждающие модели добавили второй рычаг: можно тратить больше вычислений в момент ответа. По-английски это называют test-time compute или inference-time compute, то есть вычисления во время работы.
Anthropic, представляя режим extended thinking, показала эту зависимость на графике: точность Claude на задачах американской олимпиады AIME 2024 растёт логарифмически с числом «токенов размышления», которые модели разрешено потратить. Логарифмически значит, что каждое следующее удвоение бюджета даёт меньший прирост, чем предыдущее. Первые тысячи токенов помогают сильно, а десятки тысяч сверху добавляют уже немного. Там же описан и второй способ тратить вычисления: запустить несколько независимых цепочек параллельно и выбрать лучшую.
Отсюда понятно, почему у современных моделей есть ручка «усилия». У OpenAI это параметр reasoning effort с уровнями от minimal до максимального. В документации прямо сказано, что низкое усилие быстрее и тратит меньше токенов, а на высоком модель думает основательнее и отвечает качественнее. У Claude есть «бюджет размышлений», у Gemini есть уровни thinking. Переключатель «быстро / думать дольше» в чат-интерфейсе управляет тем же самым: длиной скрытого черновика.
Почему модель долго думает над простым вопросом
Обидный случай, ради которого обычно и гуглят: вы спросили что-то элементарное, а модель всё равно надолго задумалась. Это известная проблема, у неё даже есть название: «передумывание» (overthinking).
Её разобрали в исследовании с говорящим названием «Не думай так много над 2+3». Авторы спросили у рассуждающих моделей, сколько будет 2 плюс 3. В среднем такие модели потратили на 1 953% больше токенов, чем обычные модели на тот же ответ. В разобранном примере модель QwQ-32B-Preview сгенерировала 13 вариантов решения и 901 токен, хотя верный ответ был уже в первом варианте, на 39-м токене. Всё остальное ушло на проверки, перепроверки и «а если посчитать по-другому».
Причина в том, как такие модели учат. Награду дают за правильный итоговый ответ, а не за краткость. Привычка лишний раз перепроверить себя на сложных задачах окупается, поэтому модель переносит её и туда, где перепроверять нечего. Разработчики с этим борются: модели всё лучше сами подбирают глубину рассуждения под сложность вопроса. Но полностью проблема не решена, и иногда простой вопрос всё равно попадает в «длинную» ветку.
Что ещё тормозит ответ, кроме рассуждений
Скрытый черновик — главная, но не единственная причина. Если ответ задерживается у обычной, нерассуждающей модели, дело в чём-то из этого списка.
Очередь на серверах
Нейросеть работает в дата-центре, на ограниченном числе ускорителей. Когда запросов много, например в рабочие часы или после громкого релиза, ваш запрос ждёт, пока освободятся мощности. Модель в это время ничего не «думает», вы просто стоите в очереди. Отличить это можно так: задержка появляется до первого слова, хотя вопрос простой, а на следующий день в то же время всё летает.
Длинная переписка и большие файлы
Модель предсказывает каждый токен, глядя на весь текст разговора, а не только на последний вопрос. В этот текст входят старые сообщения, вставленный документ, системные инструкции и, у рассуждающих моделей, их собственные токены рассуждения. Чем длиннее контекст, тем больше работы приходится на каждый ответ. Чат, который тянется третий день, заметно тяжелее нового.
Поиск в интернете и инструменты
Если модели разрешено искать в сети, запускать код или читать приложенные файлы, она по ходу ответа делает отдельные шаги: формулирует запрос, ждёт результаты, читает страницы и решает, хватит ли этого. Каждый такой шаг — это сетевые запросы и новые порции текста в контекст. Часто модель чередует рассуждение и инструменты несколько раз за ответ, отсюда и длинные паузы.
Просто длинный ответ
Видимый текст тоже идёт по одному токену. Если вы попросили подробный план на десять страниц, он и будет печататься долго, независимо от раздумий.
Миф первый: «думает — значит, ищет в интернете»
Это самая частая путаница, и понятно, откуда она: надпись «Думаю…» и надпись «Ищу в интернете» появляются в одном и том же месте. Но это разные процессы. Рассуждение — это генерация текста самой моделью, на её собственных весах, без обращения к внешним источникам. Рассуждающая модель может провести минуту в черновике, вообще ни разу не выходя в сеть.
Поиск — отдельный инструмент, которым модель может воспользоваться, а может и не воспользоваться. Если поиск не вызывался, всё, что модель «знает», взято из обучающих данных, и знания эти заканчиваются на определённой дате. Долгое раздумье не делает ответ свежее: модель просто тщательнее перебирает то, что уже было у неё в памяти.
Миф второй: «думает, как человек»
Черновик рассуждающей модели правда похож на человеческие мысли: «так, сначала посчитаю…», «нет, тут ошибка, попробую иначе». Поэтому легко решить, что мы видим окно в её «голову». Сами разработчики так не считают. В том же анонсе extended thinking Anthropic пишет, что нельзя быть уверенными, что написанное в черновике действительно отражает происходящее внутри модели, и что модели часто принимают решения на основании того, о чём в рассуждении не говорят.
Это проверили и экспериментально. В работе «Рассуждающие модели не всегда говорят, что думают» моделям подкладывали в вопрос подсказку, а потом смотрели, признаётся ли модель в черновике, что ею воспользовалась. Признавалась редко: средняя «честность» рассуждений составила 25% у Claude 3.7 Sonnet и 39% у DeepSeek R1. То есть в большинстве случаев подсказка повлияла на ответ, а в цепочке рассуждений об этом не было ни слова.
Правильнее думать о черновике так: это текст, который модель научилась писать, потому что с ним итоговые ответы выходят точнее. Он полезен, но это не стенограмма мышления. И долгое раздумье само по себе не гарантирует правоты. Модель может уверенно прийти к неверному выводу, просто более длинным путём.
Как ждать меньше и не потерять в качестве
Из механизма следуют вполне практические выводы.
Выбирайте режим под задачу. Перевести фразу, переписать письмо, вспомнить факт — для этого рассуждающий режим не нужен, быстрая модель ответит сразу. Многошаговая математика, поиск ошибки в коде, разбор договора — здесь лишние полминуты окупаются, именно на таких задачах цепочка рассуждений и даёт выигрыш.
Начинайте новый чат для новой темы. Хвост вчерашней переписки модель тащит в каждый ответ, хотя он ей уже не нужен.
Давайте нужный фрагмент, а не весь архив. Если вопрос про один раздел документа, вставьте этот раздел. Модели меньше читать, и она реже отвлекается на лишнее.
Не включайте поиск, если ответ не зависит от свежих данных. Каждый поход в сеть добавляет паузу.
Если тормозит всё и сразу, дело, скорее всего, не в вас. Когда простой вопрос в новом чате висит до первого слова, это нагрузка на серверы. Помогает подождать или повторить запрос позже.
Коротко
— «Думает» значит пишет скрытый черновик рассуждения перед ответом. Каждый токен черновика генерируется по одному, так же, как видимый текст, поэтому и занимает время.
— Черновик повышает точность на трудных задачах: в классической работе 2022 года модель с расписанными шагами решила 56,9% школьных задач против 17,9% без них.
— Выигрыш от длины раздумий падает: каждое удвоение бюджета даёт меньше предыдущего. А на простых вопросах модели склонны «передумывать» и тратить в разы больше токенов, чем нужно.
— Токены рассуждения оплачиваются как ответ и занимают место в контексте, поэтому долгий ответ ещё и дороже.
— Кроме рассуждений, ответ тормозят очередь на серверах, длинная переписка, поиск в интернете, файлы и просто большой объём текста.
— Рассуждение — не поиск в интернете и не стенограмма мыслей: модель не выходит в сеть, пока «думает», и в черновике пишет далеко не обо всём, что влияет на её ответ.
Пока нет комментариев