Как работает капча «Я не робот»: почему робот не может просто поставить галочку

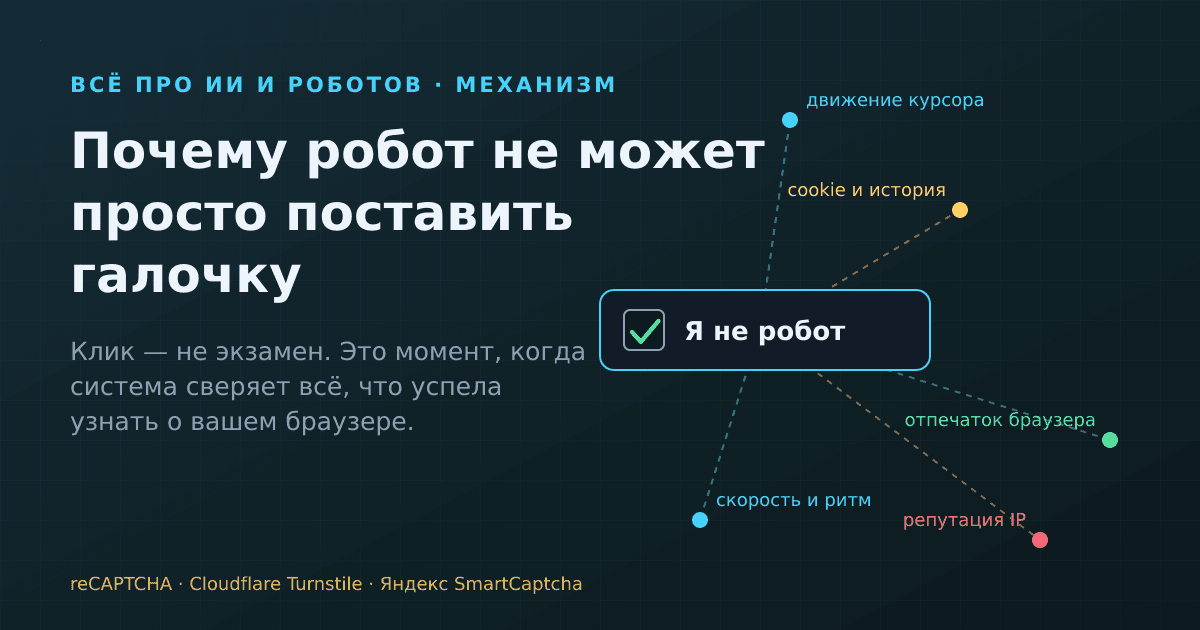
Если коротко: галочка «Я не робот» — вовсе не тест на ловкость пальца. Поставить её программа может за долю секунды, и это никого не волнует. Клик — лишь момент, когда система подводит итог: как вёл себя курсор или палец до нажатия, какие cookie и история есть у браузера, похож ли он на настоящий, откуда пришёл запрос и что известно про этот IP. Из всего этого складывается оценка риска. Если она хорошая — вы проходите сразу, если сомнительная — получаете картинки со светофорами. Робот «не может нажать» не потому, что не попадает по квадратику, а потому, что за кликом нет правдоподобной истории человека.
Это канал «Всё про ИИ и Роботов». Мы уже разбирали, как ИИ «видит» картинку, — и логичный следующий вопрос: если нейросети так хорошо распознают изображения, почему интернет до сих пор просит нас искать на фото пешеходные переходы? Ответ интереснее, чем кажется, и он полностью переворачивает представление о том, что такое капча.
Миф: «капча проверяет, умеете ли вы кликать»
Распространённое объяснение звучит так: роботу трудно попасть в квадратик, потому что у него нет руки и мышки. Это неправда. Программа, управляющая браузером, кликает по любой точке страницы быстрее и точнее человека. Кнопку она «нажмёт» без проблем — вопрос в том, что произойдёт дальше.
Слово CAPTCHA расшифровывается как Completely Automated Public Turing test to tell Computers and Humans Apart — «полностью автоматический публичный тест Тьюринга, чтобы отличить компьютер от человека». Первые капчи действительно были экзаменом: вот кривые буквы, распознай. Расчёт был на то, что компьютерное зрение с таким не справится. Расчёт продержался недолго.
В 2014 году Google, запуская ту самую галочку, прямо написал в своём блоге безопасности, что их собственные исследования показали: современный ИИ решает даже самый сложный вариант искажённого текста с точностью 99,8%. Поэтому искажённый текст «сам по себе больше не надёжный тест». Вместо него компания годом раньше построила систему продвинутого анализа риска, которая учитывает «всё взаимодействие пользователя с капчей — до, во время и после». Галочка появилась как интерфейс к этому анализу, а не как замена экзамена другим экзаменом.
Что на самом деле происходит, когда вы ставите галочку
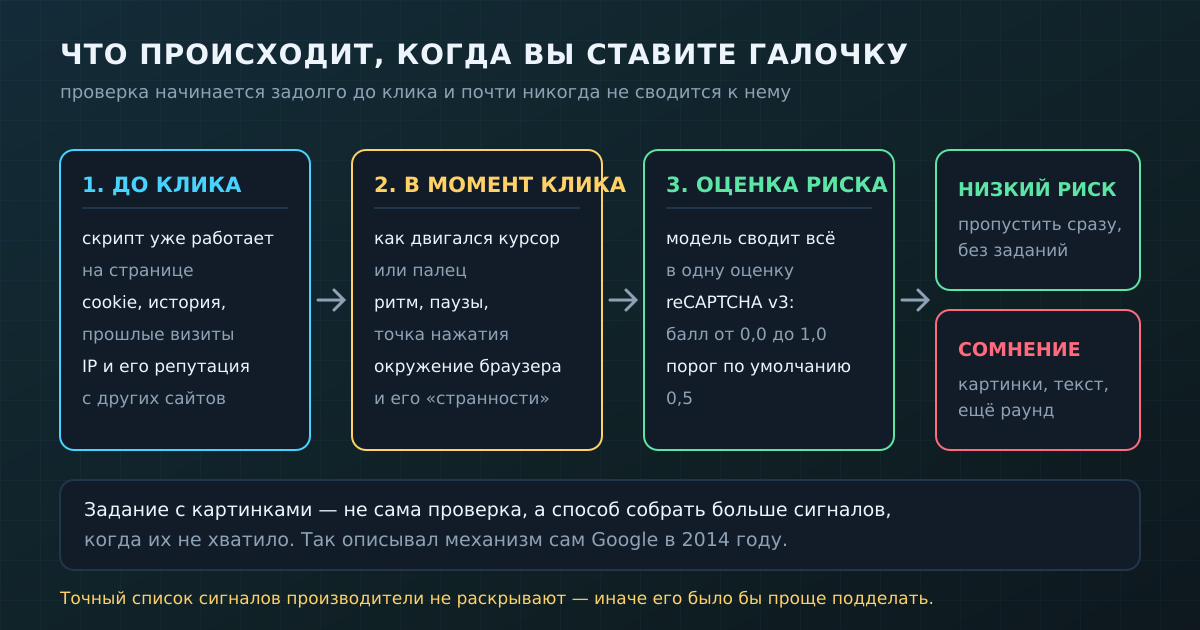
Скрипт капчи загружается вместе со страницей и начинает работать задолго до вашего клика. К моменту нажатия у него уже есть картина, из которой и делается вывод. Производители не публикуют точный список признаков — по понятной причине: опубликованный список проще подделать. Но из документации и независимых исследований общая схема видна хорошо.
Поведение
Как двигался курсор к квадратику, были ли микродрожания, паузы, промахи, как прокручивалась страница, сколько прошло времени от загрузки до клика. Человеческая рука не ведёт мышь по идеальной прямой с постоянной скоростью. На телефоне вместо курсора — касания, их длительность и площадь. Cloudflare в описании своей системы Turnstile прямо упоминает проверки, которые ищут признаки человеческого поведения.
История и cookie
Пожалуй, самый недооценённый сигнал. Браузер, в котором вы годами пользуетесь почтой, видео и поиском, несёт «биографию»: cookie, давно залогиненный аккаунт, обычные визиты на обычные сайты. Свежий браузер без единой cookie выглядит как новорождённый — а новорождённых браузеров в нормальном интернете мало. Исследователи из ETH Zurich в работе «Breaking reCAPTCHAv2» нашли свидетельства, что reCAPTCHA v2 при решении «человек или нет» опирается в первую очередь именно на cookie и историю браузера.
Окружение браузера
Какие функции поддерживает браузер, как он рисует графику, какие у него шрифты, размеры экрана, часовой пояс, язык, совпадает ли всё это между собой. Автоматизированные браузеры часто выдают себя мелкими несостыковками: заявлен телефон, а характеристики как у сервера в дата-центре. Это и называют «отпечатком браузера».
Сеть
Репутация IP-адреса: не шли ли с него тысячи похожих запросов, не принадлежит ли он хостингу, где нет живых людей, а есть только серверы. Именно поэтому пользователи VPN и Tor видят капчи чаще и сложнее — авторы исследования USENIX Security 2023 специально проверяли сайты через Tor по этой причине.
Оценка риска: капча стала невидимой
Все эти признаки сводятся в одно число — оценку риска. В последней версии reCAPTCHA это видно буквально: по документации Google, reCAPTCHA v3 вообще не показывает пользователю ничего, а возвращает сайту балл от 0,0 до 1,0, где 1,0 — «скорее всего хорошее взаимодействие», а 0,0 — «скорее всего бот». Порог по умолчанию — 0,5, но владелец сайта сам решает, что делать с низким баллом: заблокировать, попросить подтвердить вход по SMS или отправить заказ на ручную проверку.
Галочка в reCAPTCHA v2 работает по той же логике, только с видимой развилкой. Если анализ уверен, что вы человек, клик — это всё, что от вас потребуется. Если нет, Google в той же статье 2014 года описывал следующий шаг так: система «предложит капчу, чтобы получить больше сигналов». То есть картинки — не сама проверка, а дополнительный сбор данных, когда первичных не хватило.
Ещё дальше пошла Cloudflare. В документации Turnstile сказано, что система подбирает проверку под конкретного посетителя и запускает в фоне вычислительные задачи (proof-of-work), задачи на объём памяти (proof-of-space), опрос возможностей браузера и проверки на его «странности» и человеческое поведение. Визуальных головоломок Turnstile старается не показывать вовсе. У виджета есть режимы, в которых пользователю не нужно ничего нажимать или он даже не видит, что его проверили.
У Яндекса похожая схема. Документация SmartCaptcha описывает двухэтапную проверку: основное задание — та же галочка «Я не робот» или ползунок, а дополнительное — распознать искажённый текст, отметить значки по порядку или собрать картинку-«калейдоскоп» — появляется, если основное задание показалось подозрительным или владелец сайта выставил максимальную сложность. Сам выбор, кому что показать, по словам Яндекса, делают ML-алгоритмы, которые анализируют запросы.
Почему именно светофоры, гидранты и пешеходные переходы
У капч с картинками есть вторая, «полезная» сторона, и началась она задолго до светофоров. Оригинальный reCAPTCHA придумали в Университете Карнеги — Меллона, и его идея, описанная в журнале Science в 2008 году (von Ahn и соавторы, «reCAPTCHA: Human-Based Character Recognition via Web Security Measures»), была такой: показывать людям не случайные кривые буквы, а слова из отсканированных старых книг и газет, которые не смогла прочесть программа распознавания текста. Одно слово было контрольным, ответ на него система знала. Второе — неизвестным, и ответы людей на него складывались в расшифровку. Авторы сообщали, что метод даёт точность выше 99% на уровне слов, работает более чем на 40 000 сайтах и уже расшифровал более 440 миллионов слов. В 2009 году reCAPTCHA купил Google.
Когда кривой текст перестал быть проблемой для машин, Google перешёл на фотографии: в анонсе 2014 года задание «выберите все картинки, подходящие под подсказку» прямо названо классической задачей компьютерного зрения — разметкой изображений. Логика та же, что с книгами: людям легко, машинам (тогда) трудно, а человеческие ответы — ценная разметка.
Популярная версия «вы бесплатно учите беспилотные автомобили Google» звучит убедительно, но первоисточником не подтверждена: компания не публиковала, куда именно идут ответы со светофорами. Честно сказать можно так: сюжеты с улицами — это объекты, которые человек узнаёт мгновенно, а для машины граница «где кончается светофор» в клетке 4×4 неоднозначна. Именно на неоднозначных клетках, кстати, люди и ошибаются чаще всего — и это не всегда приводит к провалу, потому что ответ сравнивается не только с «правильным», но и со всеми остальными сигналами.
Миф: «ИИ давно решает капчи, значит, они бесполезны»
Первая половина утверждения — правда. В 2023 году на конференции USENIX Security вышла работа «An Empirical Study & Evaluation of Modern CAPTCHAs»: исследователи из Калифорнийского университета в Ирвайне и Microsoft провели эксперимент с 1400 участниками, которые вместе решили 14 000 капч. Затем они сравнили результаты людей с тем, что раньше публиковали о ботах. Вывод: боты превосходят людей и по скорости, и по точности почти на всех типах капч. Люди распознают искажённый текст с точностью 50–84% за 9–15 секунд, а алгоритмы — с точностью до 99,8% меньше чем за секунду.
В 2024 году группа из ETH Zurich показала, что современная модель распознавания объектов решает 100% задач с картинками в reCAPTCHA v2 (предыдущие работы — 68–71%). И важная деталь: число раундов, которые приходится проходить человеку и боту, существенно не различалось.
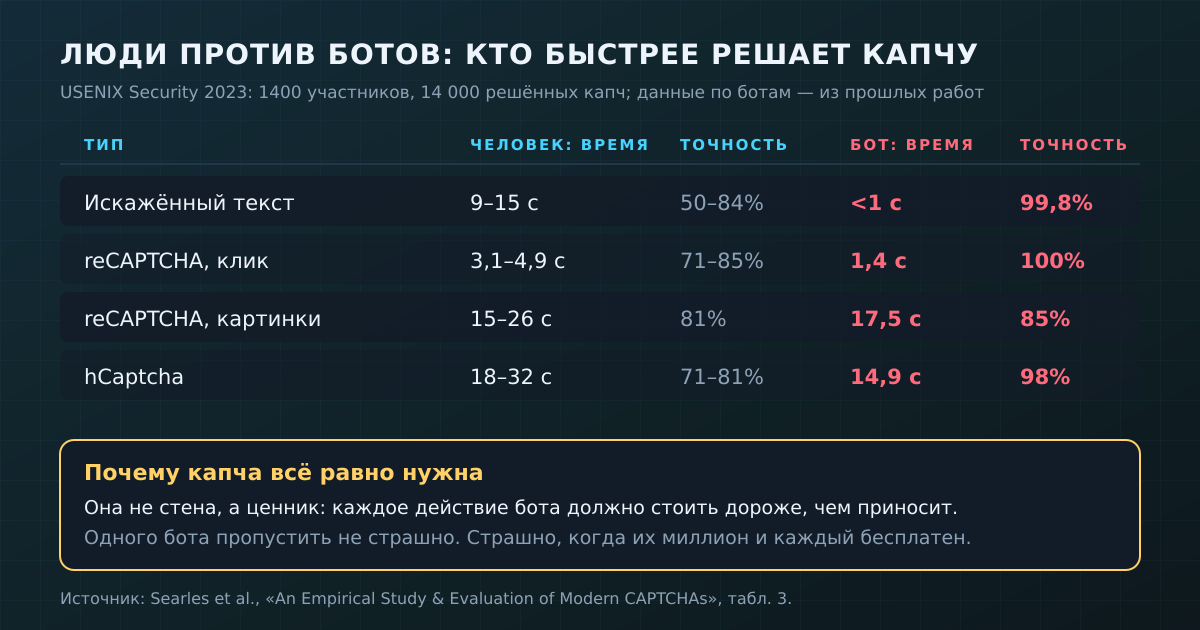
Так почему капчу не выбрасывают? Потому что она давно перестала быть стеной и стала ценником. Ещё в 2010 году исследователи из Калифорнийского университета в Сан-Диего в работе для той же USENIX Security писали, что капчи всё больше нужно оценивать «в чисто экономических терминах»: сравнивать стоимость прохождения с ценностью того, что защищено. Задача капчи — не сделать автоматизацию невозможной, а сделать её дороже, чем выгода.
Посмотрите на это глазами того, кто хочет зарегистрировать миллион фальшивых аккаунтов. Один бот, прошедший проверку, никому не страшен. Но если каждый из миллиона запросов должен прийти с «прожитым» браузером, правдоподобным поведением, чистым IP и при этом потратить процессорное время на вычислительную задачу — массовая атака превращается в дорогое производство. А модели риска обновляются: то, что вчера выглядело как человек, завтра может выглядеть как конвейер.
Есть и обратная сторона, которую фиксирует то же исследование 2023 года: капча раздражает людей и заставляет их бросать начатое. В отдельном эксперименте 30% участников ушли, не закончив задание. Отсюда и тренд — убирать головоломки из поля зрения человека и проверять всё в фоне.
Почему мне иногда показывают десять раундов картинок
Если капча мучает именно вас, дело почти никогда не в том, что вы плохо видите светофоры. Обычно это значит, что фоновая оценка риска получилась низкой, а причины вполне невинные: включён VPN или вы выходите в сеть через общий IP, с которого кто-то ещё шлёт много запросов; браузер в режиме инкогнито или вы только что очистили cookie; стоят расширения, блокирующие скрипты и трекеры; браузер редкий или сильно «усиленный» под приватность.
Всё это делает вас похожим на «браузер без биографии», и система просит больше сигналов. Выводы следуют из механизма сами: в обычном профиле браузера, без VPN и с сохранёнными cookie, капчи появляются реже. Это не баг и не наказание — это плата за приватность: чем меньше сайт знает о вас, тем сложнее ему отличить вас от программы.
Кстати, эта же логика объясняет, почему ИИ-агенты, которые сами ходят по сайтам, так часто «упираются» в капчи. Мы писали, как ИИ-агента собирают под конкретную задачу, — и вежливые агенты в такой ситуации не пытаются обмануть проверку, а передают управление человеку.
Коротко
• Галочка «Я не робот» — не экзамен. Кликнуть программа может легко; решение принимается по сигналам, собранным до и во время клика.
• Сигналы — поведение мыши или касаний, cookie и история браузера, его «отпечаток», репутация IP. Точный список производители не раскрывают.
• reCAPTCHA v3 возвращает балл риска от 0,0 до 1,0 без всякой галочки; Cloudflare Turnstile и Яндекс SmartCaptcha тоже стараются проверять в фоне.
• Картинки — запасной путь, когда сигналов мало. Исторически человеческие ответы приносили пользу: reCAPTCHA помог расшифровать сотни миллионов слов из книг.
• ИИ действительно решает капчи лучше людей, но капча работает как экономический фильтр: она делает массовую автоматизацию дорогой, а не невозможной.
Пока нет комментариев