Почему нейросеть не умеет писать слова на картинках — и что изменилось

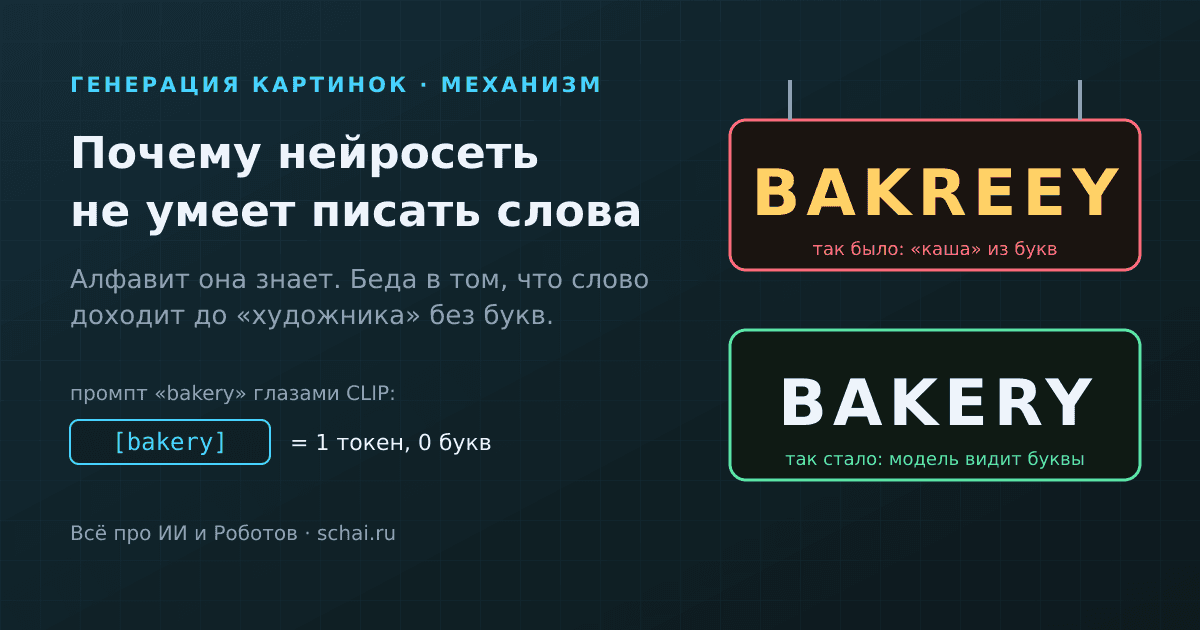
Если коротко: нейросеть для картинок путала буквы не потому, что «не знает алфавита». Слово из вашего запроса доходит до той части модели, которая рисует, уже без букв — в виде цельного кусочка-токена, у которого есть смысл, но нет написания. А рисующая часть учится на фотографиях с подписями и видит буквы как узор, вроде кирпичной кладки. Стало лучше, когда к генераторам подключили большие текстовые модели, научили их читать слово посимвольно и, наконец, встроили рисование прямо в языковую модель. С кириллицей до сих пор хуже — её просто меньше в обучающих данных.
Это канал «Всё про ИИ и Роботов». Мы уже разбирали, почему нейросеть рисует лишние пальцы, — там про то, как диффузионная модель «проявляет» картинку из шума. Сегодня соседний мем: вывеска «BAKREEY» вместо «BAKERY», плакат с буквами, похожими на эльфийские руны, и надпись на торте, которую не прочтёт ни один человек. Механизм тут другой и, честно говоря, интереснее.
Миф: «нейросеть просто не знает алфавита»
Самое частое объяснение звучит так: модель глупая, букв не знает, вот и рисует каракули. Проверить это легко. Спросите любой чат-бот, как пишется слово «strawberry» по буквам, — он ответит. Языковые модели прекрасно знают и алфавит, и орфографию. При этом в 2022 году генераторы картинок, которые читали тот же самый текст запроса, выдавали на вывесках абракадабру.
Значит, дело не в том, что знания нет в принципе. Дело в том, где она лежит и доходит ли до того места, где рождается картинка. Генератор изображений — это не одна нейросеть, а связка. Одна часть, текстовый энкодер, читает промпт и превращает его в набор чисел. Другая, обычно диффузионная, по этим числам рисует. Если первая не передала второй, из каких букв состоит слово, второй неоткуда это узнать — разве что подсмотреть в обучающих картинках.
Как слово доходит до «художника»: токены вместо букв
Языковые модели не читают текст по буквам. Они режут его на токены — частые слова и куски слов, каждому из которых соответствует номер в словаре. Подробно о том, что это такое, мы писали в статье про токены простыми словами. Для нашей истории важно одно: токен — это ярлык, а не набор букв. Модель знает, что токен №такой-то означает пекарню и встречается рядом со словами «хлеб» и «утро». Из каких букв он состоит, ей напрямую никто не говорил.
Мы взяли токенизатор CLIP — того самого текстового энкодера, на котором строились DALL·E 2 и ранние версии Stable Diffusion, — из открытого репозитория OpenAI и прогнали через него несколько слов. «bakery» — ровно один токен. «BAKERY» заглавными — тот же самый токен: прежде чем резать текст, токенизатор переводит его в нижний регистр, так что разницу между строчными и прописными модель не видит вообще. «strawberry» — тоже один токен. А «булочная» распалась на 11 обрывков байтов, «кофе» — на 5: русских слов в словаре CLIP почти нет.
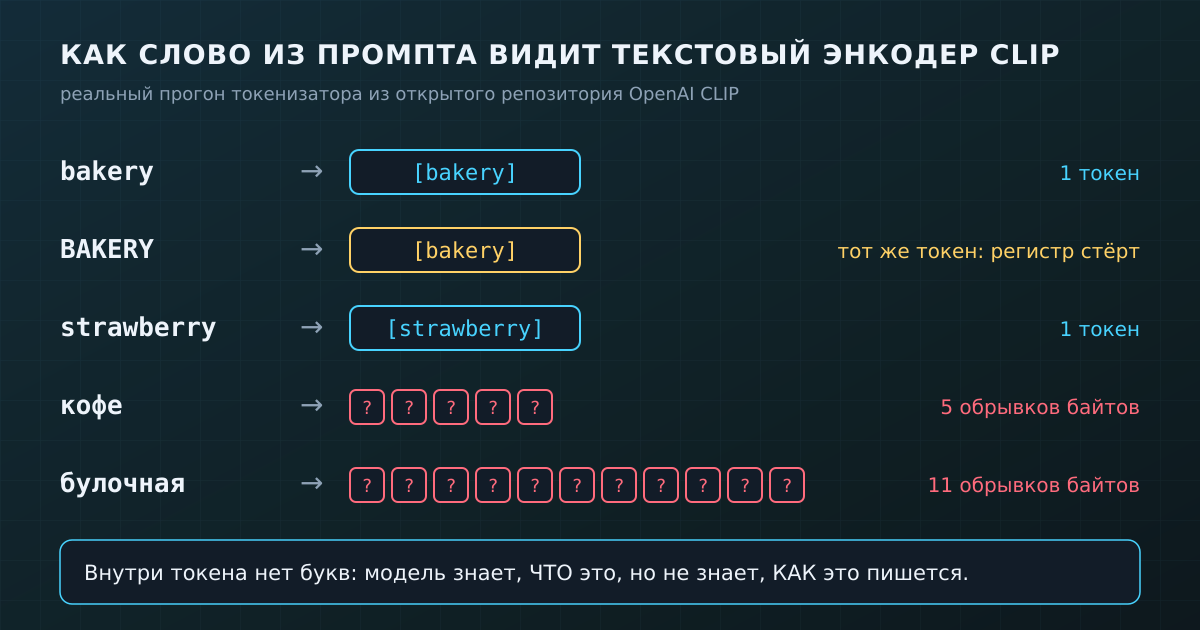
Разработчики DALL·E 2 сами называли это причиной. В разделе об ограничениях статьи OpenAI про DALL·E 2 сказано, что модель «плохо справляется с созданием связного текста», возможно, потому, что эмбеддинг CLIP неточно кодирует написание, а BPE-токенизация «скрывает от модели, как пишутся слова в подписи». Поэтому, заключают авторы, модель должна была отдельно увидеть каждый токен написанным на обучающих картинках, чтобы научиться его рисовать.
Для рисующей модели буквы — это текстура
Теперь посмотрим со стороны «художника». Диффузионную модель учат на сотнях миллионов пар «картинка + подпись». На многих картинках есть текст: вывески, обложки, этикетки, мемы. Авторы исследования Google, о котором речь ниже, вручную просмотрели 100 случайных картинок из открытого набора LAION-400M: текст был примерно на 71% из них, а примерно на 60% надпись на картинке совпадала с текстом подписи.
То есть материал для учёбы есть. Но модель видит его так же, как кору дерева или чешую рыбы: как типичный узор, который бывает на вывесках. Она хорошо запоминает, как выглядит надпись в целом: ровные строки, засечки, буквы примерно одной высоты, контраст с фоном. Поэтому на ранних генерациях текст почти всегда «похож на текст» — та же шрифтовая фактура, то же расположение. А вот точная последовательность символов — это уже не текстура, а информация, и её модель должна получить из промпта. Которого, как мы выяснили, она не получает.
Создатели модели Parti из Google в 2022 году отметили важную вещь: их генератор, как и Imagen, умел вписывать текст в картинку, хотя специальных данных для этого ему никто не готовил, — это умение возникло само, из случайных надписей на фотографиях. И тут же признали, что получается «через раз»: даже в простых запросах часто съезжает пара символов, а чем сложнее сцена, тем больше ошибок.
Парадокс: частые слова пишутся хуже
Самое красивое объяснение проблемы дала в 2022 году группа Google Research в работе «Character-Aware Models Improve Visual Text Rendering». Сначала исследователи проверили одни лишь текстовые модели: дали им слово и попросили продиктовать его по буквам. Тест назвали WikiSpell.
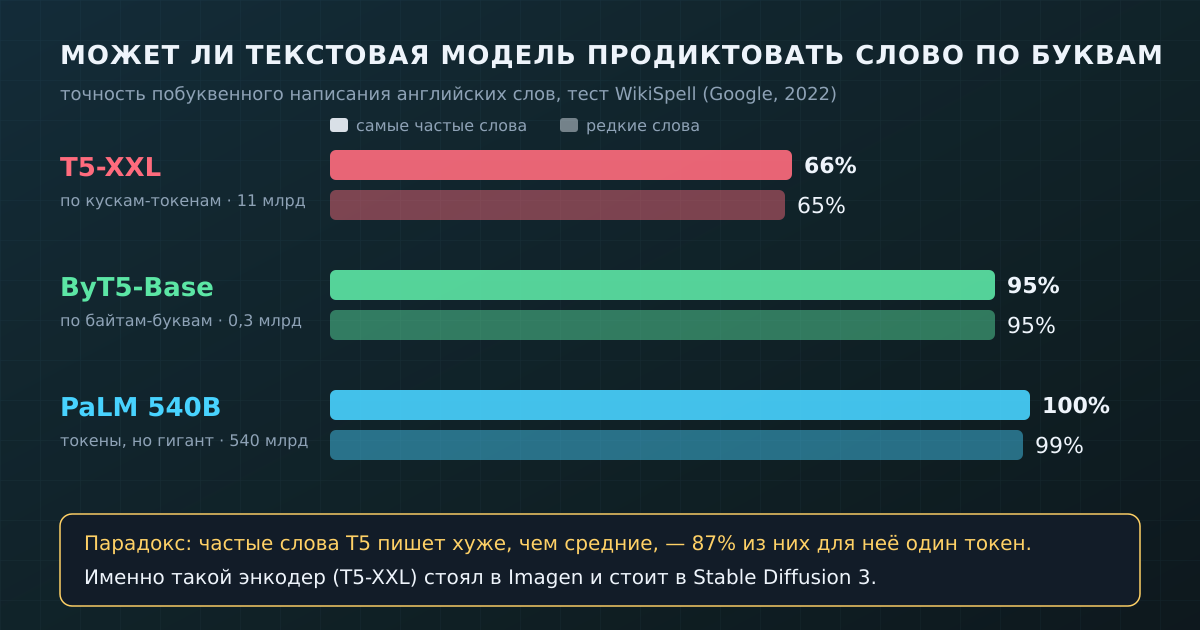
Модель T5-XXL на 11 миллиардов параметров — та самая, что стояла внутри Imagen, — правильно написала лишь 66% самых частых английских слов. Слова средней частоты давались ей лучше, до 73%. Казалось бы, наоборот: частое слово модель видела миллионы раз. Но именно поэтому оно в словаре целиком, одним токеном — так устроены 87% слов из топ-1% по частоте. Буквы внутри него спрятаны. А слово пореже режется на несколько кусков, и по кускам написание угадать легче.
Дальше два контрольных опыта. Модель ByT5, которая читает текст не токенами, а по байтам, то есть фактически по буквам, даже в самой маленькой версии на 300 миллионов параметров писала правильно 95% слов. А гигантская PaLM на 540 миллиардов параметров тоже научилась писать без ошибок больше чем в 99% случаев — хотя читает токенами. Авторы назвали это «чудом орфографии»: при достаточном размере модель выводит написание токена из одной только статистики того, где он встречается. Но энкодеры, которые реально ставили в генераторы картинок, до такого размера далеко не дотягивали.
Потом исследователи собрали генераторы картинок, которые отличались только энкодером, и обучили их одинаково. Модели с посимвольным энкодером рисовали слова заметно точнее: на редких словах — больше чем на 30 процентных пунктов лучше. Хватило даже «прицепа»: к обычной T5-XXL добавили маленькую ByT5, энкодер вырос всего на 4,8%, а модель стала видеть буквы.
Что изменилось: три шага к ровным вывескам
Шаг 1. Большой текстовый энкодер
Ещё до этого Google в работе об Imagen показала: увеличивать языковую модель, которая читает промпт, выгоднее, чем увеличивать саму рисующую модель, — растёт и качество, и соответствие картинки тексту. С тех пор крупные энкодеры вроде T5 стали стандартом. В статье о Stable Diffusion 3 Stability AI использует сразу три текстовых энкодера: два CLIP и T5-XXL на 4,7 млрд параметров. Авторы прямо проверили, что даёт T5: если его выключить, эстетика картинок не меняется, а вот в задачах с надписями модель без T5 выигрывает сравнение у полной версии лишь в 38% случаев. Именно T5 отвечает за длинный и точный текст.
Шаг 2. Модели, которые видят буквы
Исследования вроде упомянутой работы Google показали, что можно не ждать «чуда орфографии» от гигантского энкодера, а просто дать модели посимвольный вход. Это дёшево и сильно помогает именно с надписями.
Шаг 3. Рисует сама языковая модель
Самый заметный скачок случился, когда картинку стала генерировать не отдельная связка «энкодер + художник», а одна большая мультимодальная модель. 25 марта 2025 года OpenAI представила генерацию изображений прямо в GPT-4o и сделала аккуратный текст на вывесках, меню и приглашениях одной из главных демонстраций. По системной карте модели, это авторегрессионная генерация: картинка строится внутри той же нейросети, которая ведёт с вами диалог, а не передаётся отдельному диффузионному генератору. Такой модели не нужно получать слово через узкое горлышко энкодера: большая языковая модель и так хорошо знает, как пишутся слова, — вспомните PaLM из теста выше. О том, как модели вообще научились понимать текст, звук и изображения разом, — в нашем материале про мультимодальные нейросети.
Почему по-русски до сих пор хуже
Все три шага сильнее всего помогли английскому. Причина — данные. В открытом наборе LAION-5B, на котором учились многие открытые генераторы, 2,3 млрд пар «картинка + подпись» на английском и 2,2 млрд — на всех остальных сотне с лишним языков вместе. Русский среди них первый, но это 241 млн пар — почти вдесятеро меньше английского. А картинок, где кириллическая надпись совпадает с подписью, ещё меньше.
Добавьте токенизатор: для CLIP русское слово — горсть редких обрывков байтов, а не знакомые куски. И у новых моделей проблема не исчезла: в списке ограничений GPT-4o на запуске OpenAI сама написала, что модель иногда плохо справляется с нелатинскими языками и символы могут выходить неточными или выдуманными, особенно в сложных надписях. Так что если английская вывеска получилась идеально, а русская — с лишней буквой, это не случайность, а прямое следствие того, на чём модель училась.
Что из этого следует на практике
Советы вытекают из механизма сами. Короткая надпись в кавычках работает лучше длинной фразы: меньше символов — меньше мест для ошибки. Одна надпись на картинке лучше трёх. Простое частое слово для современной модели уже не проблема, а редкая фамилия или выдуманное название — по-прежнему риск, особенно на кириллице. Если надпись важна, укажите прямо, где она должна быть и каким шрифтом, и попробуйте несколько вариантов.
Если же нейросеть вообще не нужна в роли наборщика — попросите картинку без текста и наложите надпись сами в любом редакторе. Это не поражение, а нормальное разделение труда. Сгенерировать картинку и поэкспериментировать с надписями можно и в Schai GPT: там же видно, как модель справляется с короткими и длинными словами.
Коротко
Алфавит нейросеть знает. Проблема была в передаче: текстовый энкодер получал слово целым токеном, без букв, а CLIP ещё и стирал регистр.
Рисующая модель видит текст как текстуру. Она запоминает, как выглядит надпись, но точную последовательность букв может взять только из промпта.
Частые слова писались хуже. Они чаще всего один токен, и написание внутри спрятано, — это показал тест WikiSpell.
Помогли три вещи: крупные энкодеры вроде T5, посимвольные модели и генерация картинок внутри самой языковой модели.
С кириллицей хуже из-за данных: русских подписей в обучающих наборах на порядок меньше, и OpenAI сама отмечает слабость с нелатинским письмом.
Пока нет комментариев