Детектор ИИ-текста: что он на самом деле меряет и почему ошибается

Если коротко: детектор ИИ-текста не умеет «узнавать» нейросеть. Он не видит, кто печатал, и не сверяется с базой ответов ChatGPT. Он меряет одно свойство — насколько текст предсказуем от слова к слову и насколько ровно он написан. Нейросети пишут предсказуемо, но так же пишут и люди: в отчётах, инструкциях, школьных сочинениях по плану и на неродном языке. Поэтому процент «написано ИИ» — это оценка стиля, а не доказательство, и судить по нему человека нельзя.
Это канал «Всё про ИИ и Роботов». Сегодня разбираем инструмент, которым всё чаще проверяют курсовые, статьи и сопроводительные письма, — детектор ИИ-текста онлайн. Здесь не будет рейтинга сервисов. Будет механизм: что именно считает такая программа, почему её ошибки неизбежны и что делать, если ваш собственный текст вдруг объявили машинным.
Что на самом деле измеряет детектор ИИ-текста
Языковая модель пишет текст по одному кусочку слова за раз. На каждом шаге она оценивает вероятность всех возможных продолжений и выбирает одно из самых вероятных. Отсюда характерный след: машинный текст состоит из ходов, которые сама модель считает ожидаемыми. Детектор берёт похожую модель, «читает» ею ваш текст и на каждом слове спрашивает: насколько я его ожидала?
Если ответ почти всегда «очень ожидала», текст получает низкую перплексию — это мера удивления модели. Пример: во фразе «Сегодня утром я выпил чашку…» следующее слово «кофе» угадывается почти наверняка, а «ртути» — нет. Текст, в котором почти все слова похожи на «кофе», выглядит для детектора машинным.
Второй сигнал — неравномерность, в англоязычных обзорах её называют burstiness. Люди пишут рвано: короткая фраза, потом длинная, внезапное сравнение, повтор, сбивка ритма. Модель по умолчанию держит ровный темп и ровную «удивительность» от предложения к предложению. Мало перепадов — ещё один балл в сторону «ИИ».
Есть и более хитрые схемы. Например, метод DetectGPT, предложенный в Стэнфорде в 2023 году, слегка перефразирует текст много раз и смотрит, падает ли от этого вероятность исходного варианта. Машинный текст обычно сидит на «вершине» вероятности, и любая правка его ухудшает. Но и это — всё та же статистика предсказуемости, только измеренная тоньше.
Где здесь ошибка, заложенная в сам принцип
Вот главное, ради чего стоит дочитать: детектор не отличает «машину» от «человека». Он отличает предсказуемый текст от непредсказуемого — и потом предполагает, что предсказуемый написан машиной. Пока эти две вещи совпадают, всё работает. Но они совпадают далеко не всегда.
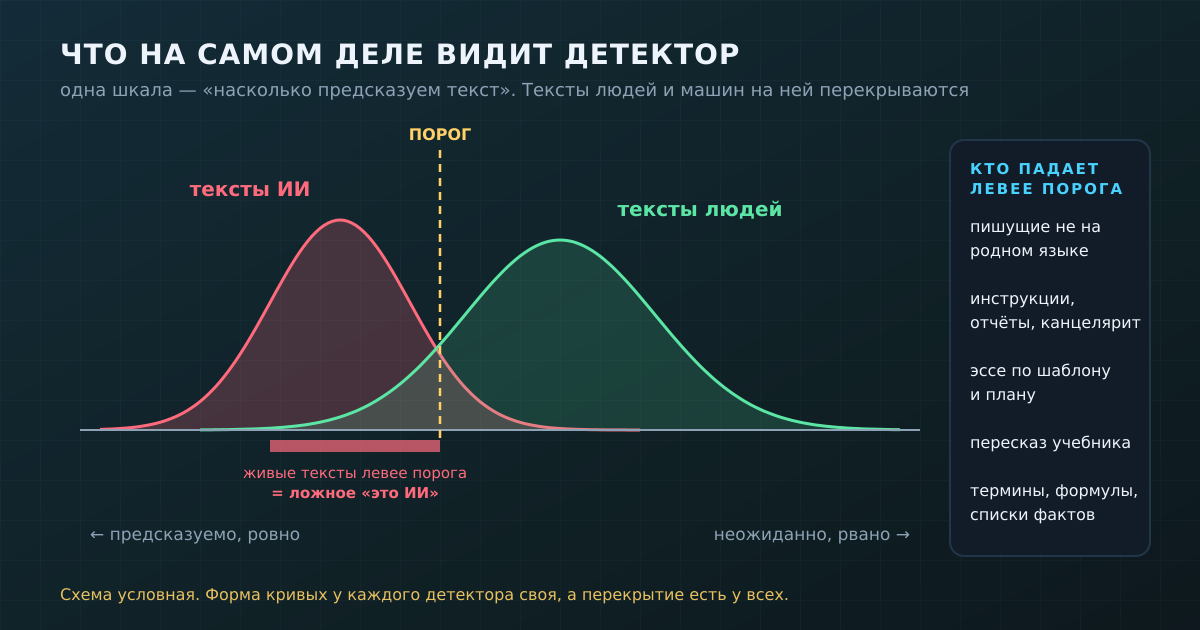
Представьте две колоколообразные кривые на одной шкале «насколько текст ожидаем». Тексты нейросетей кучкуются слева, тексты людей — правее. Хвосты кривых перекрываются, и где бы вы ни поставили порог, часть живых текстов окажется на «машинной» стороне. Порог можно подвинуть: тогда честных работ будет помечено меньше, зато больше машинных проскочит. Убрать перекрытие нельзя — это свойство языка, а не недоработка конкретной программы.
Кто попадает в этот хвост? Те, кто пишет правильно, но небогато: по шаблону, канцеляритом, короткими стандартными фразами, общеупотребительными словами. То есть ровно те ситуации, где люди и так стараются писать «как положено».
Исследование Стэнфорда: детекторы против неносителей языка
Эту механику проверили напрямую. В 2023 году группа Джеймса Зоу из Стэнфордского университета опубликовала работу «GPT detectors are biased against non-native English writers» — позже она вышла в журнале Patterns. Авторы взяли семь популярных детекторов и прогнали через них два набора текстов, написанных людьми: 91 эссе к экзамену TOEFL (английский как иностранный) с китайского учебного форума и 88 эссе американских восьмиклассников.
С эссе школьников детекторы справились почти идеально. А эссе неносителей языка они в среднем объявили машинными в 61,22% случаев. Все семь программ единогласно «поймали» 18 работ из 91, а хотя бы одна из семи пометила 89 работ — почти 98%. Те эссе, на которых сошлись все детекторы, имели заметно более низкую перплексию, чем остальные.
Проверка от обратного
Дальше исследователи сделали красивый ход. Эссе TOEFL попросили ChatGPT переписать «более богатой лексикой, как у носителя» — и доля ложных срабатываний упала с 61,22% до 11,77%. А эссе американских школьников, наоборот, упростили «как будто писал неноситель» — и доля ошибок выросла с 5,19% до 56,65%.
То есть детектор реагировал не на то, кто писал, а на бедность словаря. Тот же текст, обработанный нейросетью, становился «более человеческим», а живой текст, упрощённый той же нейросетью, — «машинным». В той же работе показано и обратное: если попросить ChatGPT переписать своё же эссе «литературным языком», доля распознанных машинных эссе обрушивалась: до правки лучшие детекторы ловили до 100% таких текстов, после — не больше 13%.
Исследование проводилось на английском, но механизм не привязан к языку: любой текст на ограниченном запасе слов и стандартных конструкциях выглядит для такой статистики предсказуемым. А на неанглийских текстах детекторы работают ещё хуже — это признавали и сами разработчики, о чём ниже.
Почему OpenAI закрыла собственный детектор
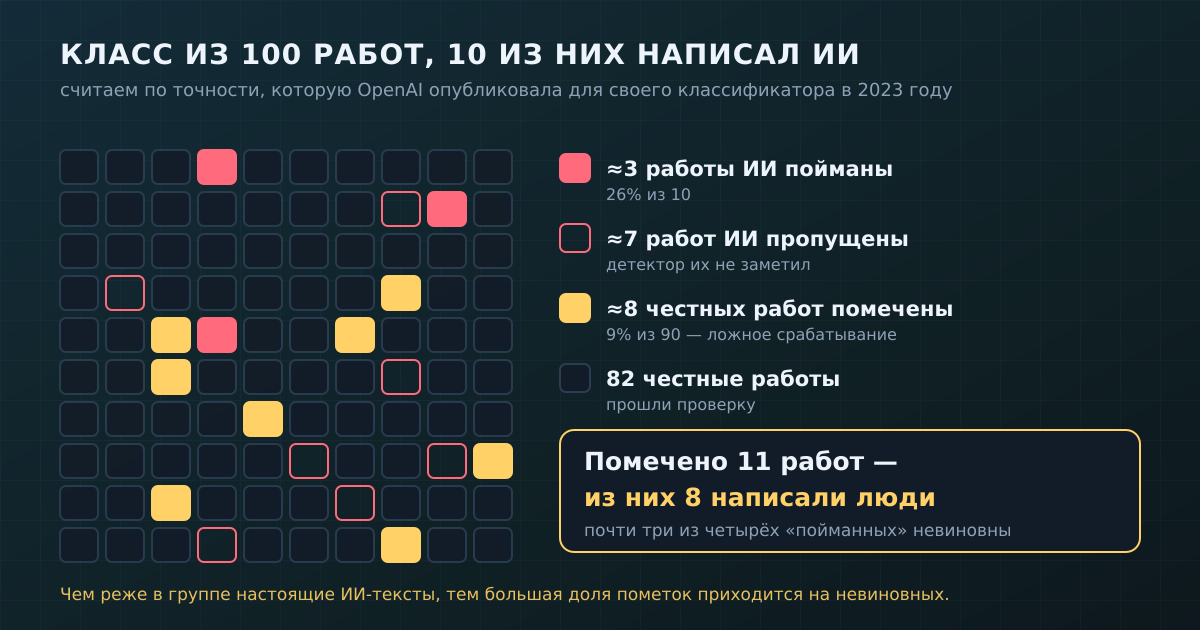
Самый честный аргумент в этой истории дала компания, которая сделала ChatGPT. В январе 2023 года OpenAI выпустила классификатор, отличающий тексты ИИ от человеческих, и сразу опубликовала его точность: на тестовом наборе английских текстов он правильно помечал как «вероятно, написано ИИ» только 26% машинных текстов и ошибочно помечал 9% человеческих.
В той же публикации перечислены ограничения: на текстах короче 1000 знаков классификатор «очень ненадёжен», пользоваться им рекомендовали только для английского, на других языках он работает значительно хуже, а очень предсказуемый текст определить невозможно в принципе. Пример оттуда же: список первой тысячи простых чисел одинаков, кто бы его ни писал. 20 июля 2023 года, меньше чем через полгода, страницу дополнили: классификатор больше недоступен «из-за низкой точности».
Что значат 9% ошибок на практике
Девять процентов звучат скромно, пока не посчитаешь на живой группе. Возьмём курс из 100 работ, 10 из которых действительно написала нейросеть. Детектор с точностью классификатора OpenAI поймает примерно 3 машинные работы из 10 и ложно пометит около 8 честных из 90. Итого в списке «подозрительных» 11 фамилий, и примерно 8 из них — люди, которые писали сами.
Это и есть ловушка базовой частоты. Чем реже в группе настоящие ИИ-тексты, тем большая доля пометок приходится на невиновных. Современные коммерческие детекторы заявляют точность выше, но перекрытие кривых никуда не девается — меняется только то, где стоит порог и кто за него платит.
Водяные знаки: другой принцип, другие ограничения
Если угадывать по стилю ненадёжно, можно пойти с другой стороны: пусть модель сама оставляет метку в тексте во время генерации. Так устроены текстовые водяные знаки. Самый известный работающий пример — SynthID Text от Google DeepMind. В статье в Nature в октябре 2024 года авторы описали схему, которая не трогает обучение модели и меняет только то, как выбирается следующий кусочек слова.
Идея такая. Когда модели одинаково подходят несколько слов, выбор между ними делается не случайно, а по секретному ключу: одни варианты при этом ключе получают небольшое преимущество. Человек разницы не заметит — все варианты и так были уместны. Но на длинном тексте накапливается статистический узор, и детектор, знающий ключ, его видит. По данным авторов, в живом эксперименте на почти 20 млн ответов Gemini качество текстов по отзывам пользователей не пострадало, а сам SynthID Text встроен в Gemini.
Принципиальная разница с обычным детектором: водяной знак проверяет не «похож ли текст на машинный», а «был ли он сгенерирован конкретной моделью с конкретным ключом». Живой текст метки не содержит, сколько бы шаблонных фраз в нём ни было, поэтому проблема неносителей языка здесь не возникает.
Чего водяной знак не решает
Ограничения названы прямо в документации Google к SynthID Text. Метка переживает обрезку и замену нескольких слов, но уверенность детектора сильно падает, если текст основательно переписать или перевести на другой язык. Хуже метка работает на фактических ответах: там у модели мало равноценных вариантов, и спрятать узор негде. И главное — она есть только в текстах тех моделей, чьи владельцы её внедрили. Открытая модель, запущенная на своём компьютере, ничего не помечает. Поэтому отсутствие водяного знака не доказывает, что текст написал человек.
Ваш текст пометили как ИИ: что делать
Из механизма следуют вполне практичные выводы. Если вы писали сами, ваша лучшая защита — не спор о проценте, а следы работы, которых у сгенерированного текста обычно нет.
История правок. Google Документы, Word с облачным хранением и многие редакторы хранят версии документа. Текст, который рос неделю кусками, с вычеркнутыми абзацами и правками, выглядит совсем иначе, чем текст, вставленный целиком за секунду.
Черновики и материалы. Заметки, план, выписки из источников, фотографии конспекта, переписка с научным руководителем — всё, что показывает путь к тексту.
Умение объяснить. Самая надёжная проверка авторства — разговор. Человек, написавший работу, может пересказать ход рассуждения, объяснить, почему выбрал этот пример, и ответить на вопрос, которого в тексте нет.
Аргументы о самом инструменте. Спокойно попросите уточнить, каким детектором проверяли и какую погрешность заявляет его разработчик. Сошлитесь на опубликованные ограничения: тот же OpenAI прямо писал, что классификатор не должен быть основным инструментом для принятия решений.
Чего делать не стоит — гонять свой текст через «очеловечиватели» и перефразировщики, пока процент не упадёт. Это та же нейросеть, только вписанная в вашу работу. Результат может стать хуже, а в спорной ситуации такая правка выглядит подозрительнее исходника.
Почему нельзя судить человека по одному проценту
Цифра на экране создаёт иллюзию точности: «87% ИИ» звучит как измерение, примерно как показания весов. На деле это вероятность, которую программа присвоила по стилю, с неизвестной для вашего случая погрешностью. Тот же текст может получить разные оценки в разных сервисах, а иногда и в одном сервисе после правки пары предложений.
Если вы преподаватель, редактор или работодатель, разумная практика выглядит так: процент — повод присмотреться, а не вывод. Дальше — разговор с автором, просьба показать черновики, сравнение с его прежними работами. И особая осторожность с теми, кто пишет на неродном языке или в жанре, где стандартные формулировки обязательны, — именно их детекторы помечают чаще всего, как показало исследование Стэнфорда.
Отдельная история — сами нейросети как судьи. Если вставить текст в чат-бот и спросить «это написал ИИ?», он охотно ответит. Но такой ответ ещё менее надёжен: модель не имеет доступа к истории текста и склонна соглашаться с тем, что в вопросе уже подразумевается.
Коротко
— Детектор ИИ-текста меряет предсказуемость и ровность текста, а не «почерк нейросети».
— Предсказуемо пишут и люди: неносители языка, авторы отчётов и инструкций, школьники по шаблону. В исследовании Стэнфорда семь детекторов в среднем пометили как машинные 61% эссе неносителей.
— OpenAI закрыла собственный классификатор в июле 2023 года из-за низкой точности: 26% пойманных машинных текстов при 9% ложных срабатываний.
— Водяные знаки вроде SynthID Text надёжнее, потому что проверяют метку, а не стиль, но работают только для моделей, которые их ставят, и слабеют после переписывания и перевода.
— Если ваш текст пометили, покажите историю правок, черновики и объясните ход мысли. Если проверяете вы — считайте процент поводом для разговора, а не приговором.
Пока нет комментариев