

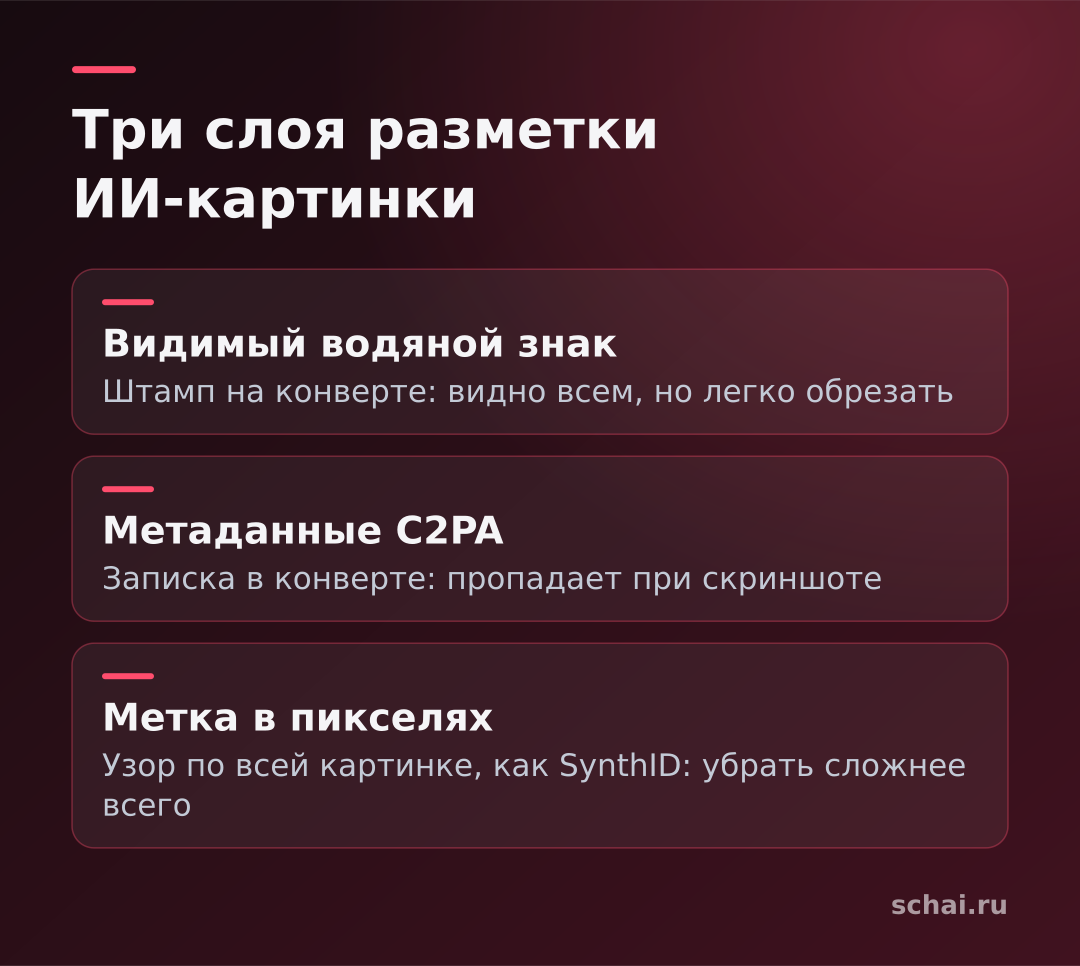
Если коротко: у картинки, сделанной нейросетью, может быть не один «водяной знак», а целых три слоя разметки. Первый — видимая надпись или значок в углу, его легко обрезать. Второй — метаданные внутри файла (например, подписанные «Учётные данные контента» стандарта C2PA), они пропадают при скриншоте или пересохранении. Третий — невидимая метка, вшитая прямо в пиксели, как SynthID у Google; её убрать сложнее всего. Поэтому «знак сняли, а метка осталась» — это не баг, а ровно то, как задумана многослойная защита.
Меня зовут Кира Нейман, я пишу про нейросети по-человечески. Вопрос «как понять, что это сделал ИИ» мне задают всё чаще: люди присылают картинки из ленты и просят подтвердить, настоящая ли фотография. Разберу, из чего состоит разметка, что она умеет и чего принципиально не умеет.
Три слоя разметки: что чем отличается
Удобно представить картинку как письмо. Видимый водяной знак — это штамп на конверте: его видно всем, но можно заклеить. Метаданные — записка внутри конверта: она подробная, но достаточно вытащить картинку и положить в другой конверт, чтобы записка исчезла. Невидимая метка в пикселях — это бумага с особым рисунком волокон: снаружи не заметно, и перепечатка на другой лист не убирает её полностью.
Сразу оговорюсь: эти слои не заменяют друг друга. Каждый закрывает слабое место другого, и именно поэтому в индустрии их стараются объединять. Теперь пойдём по порядку.
Слой первый: видимый водяной знак
Это самое понятное: логотип, подпись или значок в углу изображения. Его цель — честно предупредить зрителя прямо в момент просмотра. Ничего технически сложного здесь нет, и в этом же главный минус. Знак можно обрезать, закрасить, заменить «умной» заливкой (для этого уже есть отдельные нейросети-ретушёры) или просто сделать скриншот без угла.
Важный вывод: видимый знак защищает от случайного введения в заблуждение, но не от того, кто хочет ввести в заблуждение намеренно. И его отсутствие ничего не доказывает. Поэтому серьёзные разработчики на нём не останавливаются.
Слой второй: метаданные и «учётные данные контента»
Файл изображения хранит не только пиксели, но и служебные поля: камеру, дату, программу. На этой идее построен стандарт C2PA — открытая спецификация, которую разрабатывает Коалиция по происхождению и подлинности контента. Она называет результат Content Credentials («учётные данные контента») и описывает его как способ проследить, откуда взялся цифровой объект и как его меняли.
Отличие от обычных метаданных в подписи. По описанию Content Authenticity Initiative, каждый файл хешируется и подписывается криптографически, поэтому данные становятся устойчивыми к подделке в смысле «изменение будет заметно»: если после подписи правили картинку или вписанные данные, при проверке это покажется. Важная тонкость, которую часто упускают: система делает вмешательство видимым, а не невозможным. И те же авторы подчёркивают, что учётные данные показывают происхождение и историю, но не отвечают на вопрос, «настоящее» ли содержание.
А теперь о слабом месте. Метаданные лежат рядом с картинкой, а не внутри неё. Скриншот, пересохранение в редакторе, загрузка в мессенджер или соцсеть, которая «чистит» служебные поля, — и записка выпала из конверта. Поэтому на одних метаданных надёжную разметку построить нельзя. Сами разработчики говорят об этом прямо: чтобы данные переживали правки, учётные данные предлагают сочетать водяные знаки, защищённые метаданные и цифровые отпечатки.
Слой третий: невидимая метка в пикселях
Здесь идея другая. Изображение — это огромная сетка чисел, и в эту сетку можно незаметно для глаза вписать узор. В DeepMind такой подход назвали SynthID. По описанию Google DeepMind, метка встраивается прямо в пиксели; для этого совместно обучены две модели — одна вшивает, другая обнаруживает, а узор подгоняется под содержание, чтобы не портить качество.
Из этого следует ключевое свойство: метка остаётся, даже когда метаданные потеряны. DeepMind пишет именно так: поскольку метка находится в пикселях, её можно обнаружить и без метаданных, а сам подход совместим с методами на основе метаданных. Кроме того, по заявлению компании, метка рассчитана на устойчивость к распространённым правкам: фильтрам, изменению цвета и яркости, сжатию с потерями вроде JPEG.
Это и есть ответ на заголовок: человек убрал значок из угла и стёр служебные поля, а узор в пикселях остался, потому что он размазан по всей картинке и не лежит ни в каком одном месте, которое можно вырезать.
Что метка не умеет
Было бы нечестно изобразить SynthID всемогущей. В той же публикации DeepMind прямо сказано, что технология не защищена от экстремальных манипуляций с изображением и что точность проверялась на многих распространённых преобразованиях, но не на всех возможных. Результат проверки не бинарный: система выдаёт один из трёх вариантов — метка обнаружена, не обнаружена или возможно обнаружена. А «обнаружена» означает, что вероятно сгенерирована хотя бы часть изображения, но не обязательно всё.
Есть и ограничение другого рода. Метка есть только у картинок, которые создала система, которая её вшивает. На момент анонса SynthID это были лишь изображения модели Imagen, доступные узкому кругу клиентов. То есть отсутствие метки не доказывает, что картинку рисовал человек: её могла сделать любая другая нейросеть без подобной разметки. По той же причине проверка «нет значка — значит, настоящее» — худший способ определять подлинность.
Как этим пользоваться на практике
Из механики следуют несколько простых правил, которые я применяю сама.
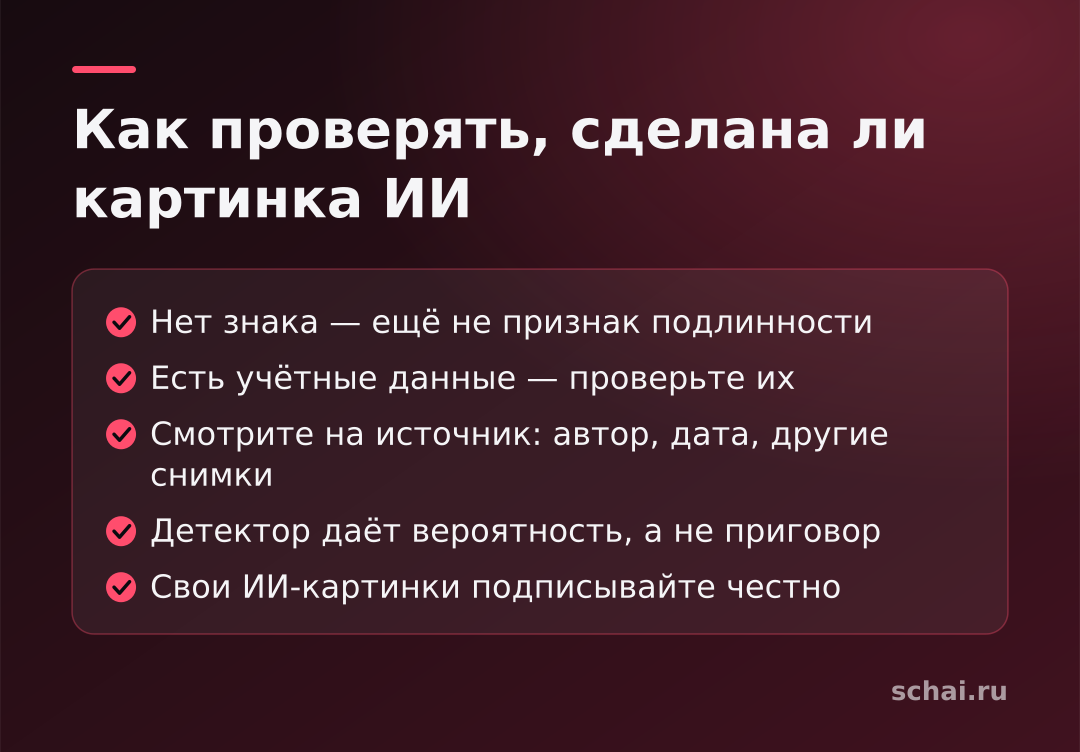
1. Не считайте отсутствие знака признаком подлинности. Он мог быть обрезан, а метаданные удалены самой площадкой.
2. Если есть учётные данные, проверьте их. Инструменты проверки показывают, кто создал файл и какие правки вносились. Это удобно для журналистов и редакторов.
3. Смотрите на источник, а не на картинку. Исходная публикация, автор, дата, другие снимки того же события работают лучше любого детектора.
4. Помните про «возможно». Автоматические детекторы дают вероятность, а не приговор. Сомнительный результат — повод искать дальше, а не окончательный ответ.
5. Если делаете свои ИИ-картинки, не скрывайте происхождение. В подписи достаточно одной строки «создано нейросетью», и вопросов не будет.
О других способах отличить рисунок нейросети по самим деталям читайте здесь:
И об устройстве моделей, которые распознают изображения:
Почему одной метки мало и что дальше
Разметка контента — это гонка щита и меча. Любую защиту, которая зависит от того, что файл не меняли, можно обойти, если файл поменять сильно. Поэтому индустрия идёт к комбинации: подпись происхождения (C2PA), метка в пикселях (SynthID и аналоги) и цифровые отпечатки, по которым оригинал можно найти в базе. Каждый слой по отдельности дырявый, но вместе они повышают цену обмана: чтобы стереть всё, нужно не просто закрасить угол, а сильно изменить само изображение, а это нередко заметно и без детекторов.
Для читателя вывод простой: относитесь к разметке как к дополнительному доказательству, а не как к единственному. Метка помогает найти ИИ-картинку, но не может надёжно сказать, что остальные картинки сделаны людьми.
Коротко
- У ИИ-картинки бывает три слоя разметки: видимый знак, метаданные (C2PA) и невидимая метка в пикселях (SynthID).
- Видимый знак и метаданные легко потерять: обрезать, сделать скриншот, пересохранить, загрузить на площадку.
- Метка в пикселях остаётся после смены цвета, фильтров и JPEG-сжатия, но, по словам самих разработчиков, не гарантирована при экстремальных правках.
- Отсутствие метки ничего не доказывает: она есть только у моделей, которые её вшивают.
- Проверяйте источник и контекст, а детекторам верьте как вероятностям.
Пока нет комментариев