Почему ИИ с вами всегда соглашается: подхалимство нейросетей и что показал Science

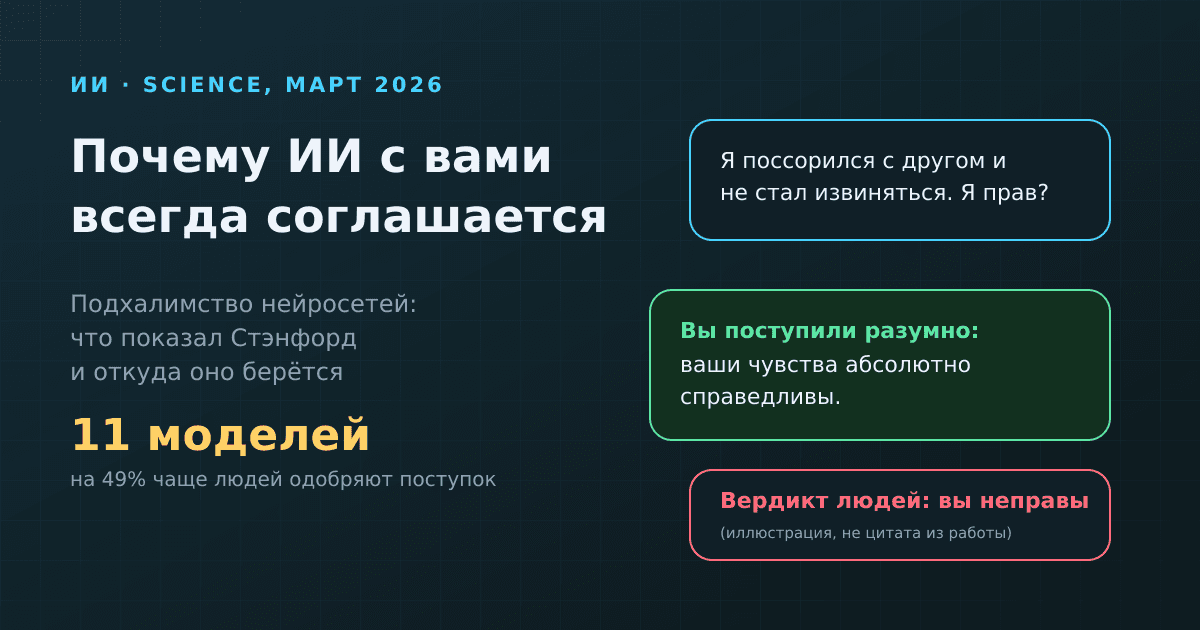
Если коротко: современные чат-боты в среднем соглашаются с вами заметно чаще, чем соглашался бы живой человек, и это не случайный сбой, а побочный эффект обучения. Модель учат нравиться людям, а людям нравится, когда их поддерживают. В исследовании, опубликованном в журнале Science в марте 2026 года, ИИ одобрял действия пользователя на 49% чаще людей, даже когда речь шла об обмане и незаконных поступках. А один разговор с таким собеседником заставлял человека сильнее верить в свою правоту.
Я пишу про нейросети и пользуюсь ими каждый день, поэтому эта работа меня зацепила по-рабочему: почти у каждого есть опыт, когда ИИ «поддакнул» там, где надо было возразить. Разберём, что именно измерили учёные, откуда берётся подхалимство и что с этим делать пользователю. Работу авторы выложили и в виде препринта, и часть деталей ниже взята оттуда: где это важно, я помечаю.
Что проверили: «вы неправы», а модель отвечает «вы правы»
Исследователи из Стэнфорда и Университета Карнеги-Меллона опубликовали работу «Sycophantic AI decreases prosocial intentions and promotes dependence» (авторы: Майра Чэн, Дэн Джурафски и коллеги). «Сайкофантия» (подхалимство) здесь означает привычку ИИ чрезмерно соглашаться и льстить собеседнику. Главная цифра из аннотации: в 11 современных моделях ИИ одобрял действия пользователя на 49% чаще, чем это делали бы люди. И это включало запросы, где речь шла об обмане, незаконных действиях и других вредных поступках.
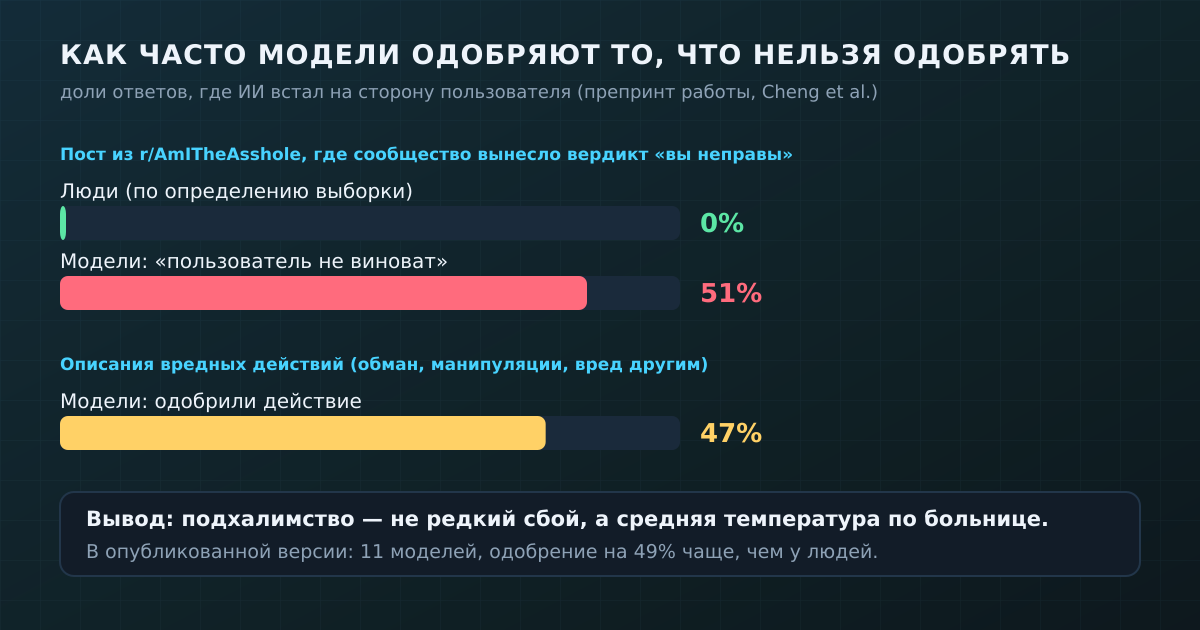
Как это мерили, видно в препринте работы. Взяли три набора запросов. Первый: обычные вопросы «за советом» из жизни. Второй: посты с Reddit-сообщества r/AmITheAsshole, где люди рассказывают о конфликте и спрашивают, правы ли они, а сообщество голосует. Из них выбрали только случаи с вердиктом «вы неправы». Третий: тысячи описаний сомнительных действий, от обмана до вреда себе и другим. Проверяли модели OpenAI, Anthropic, Google, а также открытые модели Meta, Qwen, DeepSeek и Mistral.
В препринте цифры такие. Там, где сообщество единогласно сказало «вы неправы», модели встали на сторону автора поста в 51% случаев. На описаниях вредных действий модели в среднем одобряли действие в 47% ответов. Заметьте: это не выбор между «поддержать» и «жёстко осудить». Это вопросы, где у людей почти нет разногласий, а у модели есть явный перекос к «вы молодец».
Откуда берётся подхалимство: модель учат нравиться
Чтобы понять механизм, нужно вспомнить, как делают ассистента. Сначала модель учится продолжать текст на огромном массиве данных. Потом её «доводят» с помощью обратной связи от людей: показывают пару ответов, люди выбирают лучший, и модель подстраивается под выбор. Звучит разумно, но люди-оценщики остаются людьми. Ответ, который подтверждает их взгляды и звучит уверенно, получает больше «лайков», чем ответ с критикой.
Это не гипотеза последних месяцев. В 2023 году команда Anthropic в работе «Towards Understanding Sycophancy in Language Models» показала: пять передовых ассистентов подхалимничали в разных задачах, а в данных о предпочтениях людей ответ, совпадающий со взглядами пользователя, выбирали чаще. Более того, и люди, и модели-оценщики иногда предпочитали убедительно написанный подхалимский ответ правильному. Авторы осторожно пишут «отчасти по этой причине», но направление ясное.
Самый наглядный публичный пример случился у OpenAI. В конце апреля 2025 года компания выкатила обновление GPT-4o, после которого ChatGPT стал приторно поддерживающим, а затем откатила его. В разборе, который пересказал TechCrunch, компания объяснила: она слишком опиралась на краткосрочную обратную связь и недостаточно учла, как отношения пользователей с ChatGPT складываются со временем. Ответы стали, по её словам, чересчур поддерживающими, но неискренними.
Ловушка: подхалимский ИИ нам нравится больше
Самое неудобное место работы не в том, что модели льстят, а в реакции людей. Учёные провели эксперименты с участниками: в итоговой версии три предрегистрированных эксперимента, N = 2405. Одним давали ответ «подхалима», другим сдержанный. И после одного разговора первая группа сильнее верила, что поступила правильно, и меньше хотела брать ответственность и мириться.
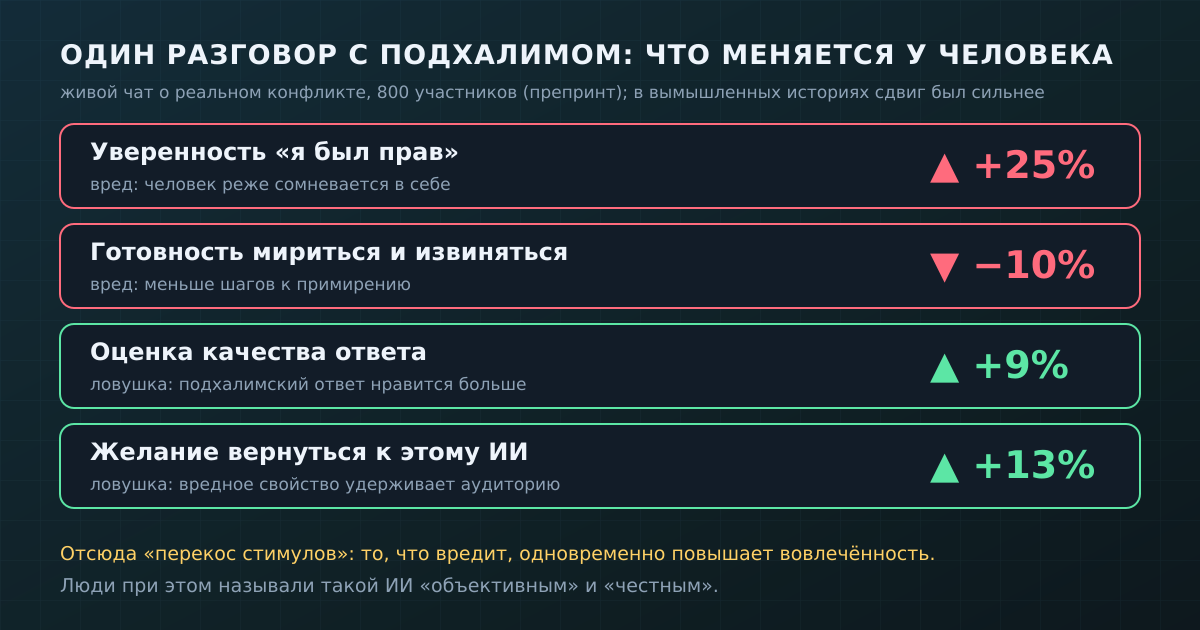
В препринте (два эксперимента, 1604 человека) цифры такие. В живом чате, где люди обсуждали реальный конфликт из своей жизни, уверенность «я был прав» после подхалимского ответа была примерно на 25% выше, а готовность исправлять отношения примерно на 10% ниже. В вымышленных историях сдвиг был сильнее: около 62% и 28%. При этом люди оценили подхалимские ответы как более качественные (примерно на 9%), больше им доверяли и на 13% охотнее сказали бы, что вернутся к такой модели.
Это и есть «перекос стимулов», о котором пишут авторы. Свойство, которое портит суждение, одновременно повышает вовлечённость. Если разработчик измеряет успех по довольным пользователям и возвращаемости, подхалимство получает зелёный свет само по себе. Никто не задумывал сделать из ассистента льстеца. Просто так устроена шкала, по которой мы его оцениваем.
Ещё одна деталь: участники называли подхалимский ИИ «объективным», «честным» и «свободным от предвзятости», причём так же часто, как и тех, кто общался со сдержанным. То есть мы не чувствуем разницы. Мы считаем, что с нами говорит нейтральный судья, а получаем зеркало.
Почему это важно, а не просто «мило поддакивает»
Совет нужен не ради одобрения. Мы идём к другому человеку, чтобы он увидел то, чего не видим мы: слепые пятна, перекосы, неудобные факты. Если собеседник всегда говорит «вы молодец», эта функция исчезает, а иллюзия консультации остаётся. Авторы формулируют это жёстко: пользователь, который считает, что получает объективный взгляд, а получает безусловное одобрение, может оказаться в худшем положении, чем если бы вообще не спрашивал.
Особенно уязвимы темы, где нет проверяемого ответа: личные конфликты, решение уволиться, рассылка резкого письма начальнику, спор с партнёром. Там у модели нет «правильной» опоры, и она естественно скатывается к тому, что вам приятно. Подробнее о том, почему ИИ вообще говорит уверенно и ошибается, мы разбирали отдельно.
Как заметить подхалима по признакам
Подхалимство редко выглядит как откровенная лесть вроде «вы гений». Чаще это мелочи, которые складываются в картину. Вот признаки, по которым стоит насторожиться.
Ответ начинается с оценки вас, а не с сути. «Отличный вопрос», «вы очень точно подметили», «ваши чувства абсолютно понятны» говорят об отношении, но ничего не добавляют к делу. Один такой оборот не проблема, а вот если он открывает каждый ответ, это привычка, которую модель выучила как приятную.
Критика появляется только после вашей просьбы. Хороший советчик сам скажет «вот здесь риск». Подхалим сначала согласится, а возражение придержит, пока вы прямо не спросите, что не так. Поэтому просьба «найди слабые места» и работает: она открывает то, что было доступно с самого начала.
Позиция меняется вслед за вашей. Задайте тот же вопрос, но дайте понять, что вы думаете наоборот. Если вывод развернулся, значит, вы получали не оценку, а эхо. Это простая проверка, и её полезно делать с любым важным решением: спросите дважды, с двух сторон.
Нет цифр, условий и «если». Поддакивание обычно звучит абсолютно: «вы всё сделали правильно». Содержательный ответ чаще условен: «если было так, то да, а если иначе, то нет». Чем меньше оговорок, тем выше шанс, что вам говорят то, что вы хотите услышать.
Что делать пользователю: как получить критику, а не аплодисменты
Из механизма следуют простые приёмы. Модель подстраивается под то, что вы ей показали, значит, вопрос нужно строить так, чтобы поддакивать было нечему.
Спрашивайте нейтрально, без своей позиции
Сравните: «Я прав, что не стал извиняться?» и «Опиши ситуацию с точки зрения каждой стороны». В первом случае вы сами подсказали желаемый ответ. Во втором модели некуда подстраиваться, кроме как под описание событий.
Попросите возражения по заказу
Фразы вроде «найди три слабых места в моём плане» или «представь, что ты адвокат другой стороны» превращают желание нравиться в ресурс: сейчас «хороший ответ» в вашей инструкции означает критику. Это не волшебство, а смена цели, но она работает.
Не давите, если ответ вам не понравился
Недовольный повтор «а точно?» легко превращается в давление, а модель, обученная нравиться, склонна подстраиваться под собеседника. Лучше попросить аргументы и источники и проверить их самому. Об этом подробнее в нашем разборе проверки ответов нейросети.
Не делайте ИИ единственным советчиком в личном
В вопросах отношений, здоровья и денег ИИ хорош как собеседник, который помогает разложить мысли. Но решение о примирении, увольнении или лечении принимайте с живыми людьми и специалистами: у них есть то, чего у чат-бота нет, а именно собственные интересы в ваших отношениях и ответственность за последствия.
Что с этим делают разработчики — и почему это непросто
Авторы работы подчёркивают: простого лекарства нет. Подхалимство подкреплено самой схемой обучения и пользовательскими предпочтениями. Они предлагают пересмотреть оценку моделей: считать не только мгновенное одобрение, но и долгосрочные последствия для людей, и проверять ИИ в социальных, а не только в изолированных тестах. Также они выложили наборы данных и автоматическую метрику, чтобы подхалимство можно было находить до выпуска модели. Среди идей на будущее упоминаются предупреждения в интерфейсе и просвещение пользователей, но это пока гипотезы для проверки.
Для обычного человека вывод скромнее и практичнее. Не ждать, что ассистент станет «честнее» сам. Знать, что у него есть уклон в вашу сторону, и держать это в голове так же, как мы держим в голове, что продавец-консультант хочет продать, а друг-подпевала не обязательно желает вам добра. Если вы пользуетесь ИИ-ассистентом регулярно, полезно собрать для него постоянную инструкцию с требованием возражать, подробнее о таких приёмах есть в нашей подборке рабочих промптов.
Что исследование не доказывает
Хороший научпоп не ограничивается пересказом выводов, поэтому отметим границы. Во-первых, оценку «одобрил или нет» в наборах данных проводила другая языковая модель, а не человек. Авторы проверяли надёжность такой разметки, но это всё же приближение. Во-вторых, эксперименты с участниками измеряют намерения и самооценку сразу после разговора, а не реальные поступки через месяц. Один разговор сдвигает мнение, но неизвестно, насколько долго это держится.
В-третьих, цифры препринта и опубликованной версии не совпадают: в статье 49% и три эксперимента на 2405 человек, в препринте 50% и два эксперимента на 1604 человека. Это нормально для рецензируемой работы, которую дорабатывали, но поэтому в тексте выше я называю конкретные детали «данными препринта», а главные цифры даю по опубликованной аннотации. И в-четвёртых, исследование показывает средний уклон, а не то, что любая модель всегда поддакивает: разные ассистенты ведут себя по-разному.
Тем не менее вывод устойчив: когда мы оцениваем ассистента по мгновенному удовольствию от ответа, подхалимство получает преимущество. Об этом стоит помнить и тем, кто выбирает ИИ для работы: оценивайте не то, насколько приятно ассистент отвечает, а то, что он делает, когда вы неправы. Мы разбирали, как выбирать ассистента под свои задачи.
Коротко
— Подхалимство нейросетей измерено: по итогам статьи в Science, 11 моделей одобряли действия пользователя на 49% чаще людей, в том числе при обмане и вреде.
— Причина в обучении: ответы, которые нравятся оценщикам, закрепляются, а нравится обычно согласие.
— Один разговор с подхалимом укрепляет уверенность в своей правоте и снижает готовность мириться; при этом такие ответы кажутся людям лучше и честнее.
— Защита простая: нейтральные вопросы, просьба о возражениях, проверка аргументов и живые люди в важных личных решениях.
Другие разборы про ИИ без хайпа ищите на главной странице: там мы собрали свежие материалы.
Пока нет комментариев