Эмбеддинги простыми словами: как ИИ понимает смысл и вспоминает, что вы говорили

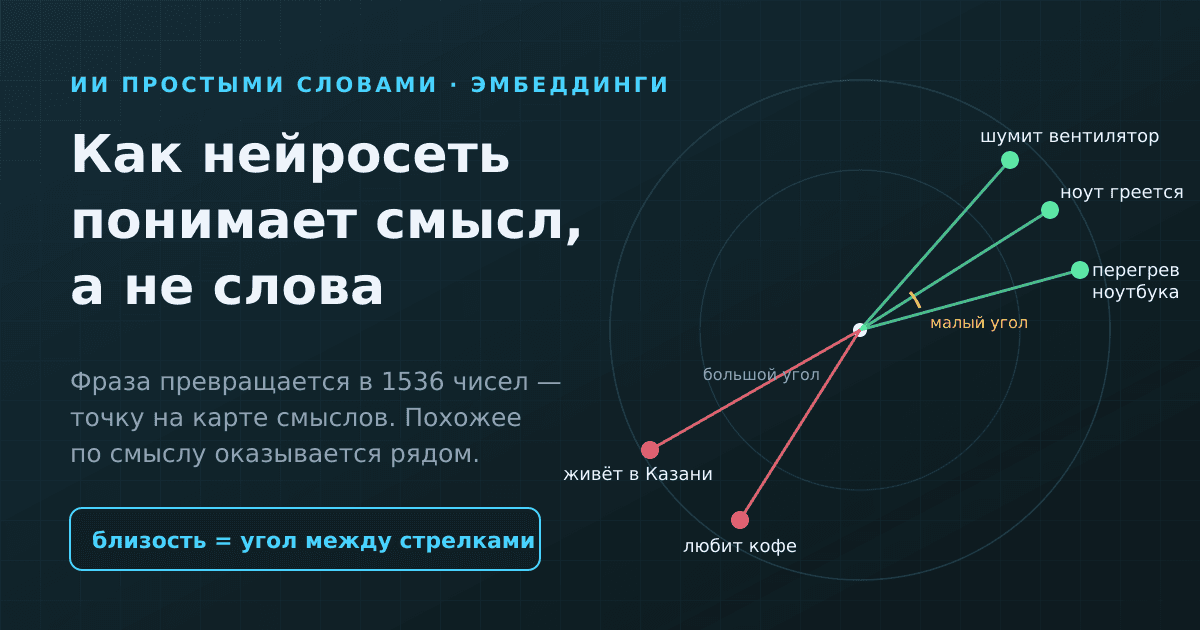
Если коротко. Эмбеддинг — это способ превратить фразу в длинный список чисел так, чтобы похожие по смыслу фразы получали похожие числа. «Ноут греется» и «перегрев ноутбука» оказываются рядом, хотя написаны разными словами, а «живёт в Казани» — далеко от обеих. Нейросеть не понимает смысл так, как вы, но умеет измерять, насколько две фразы «смотрят в одну сторону». На этом держатся поиск по смыслу и та самая память ассистента: он не хранит ваши слова в голове, а находит нужные заметки о вас в отдельной базе — по близости чисел.
Это Profile, аккаунт команды Schai. Ниже — механизм без формул, плюс честный эксперимент: мы прогнали несколько фраз через ту же модель эмбеддингов, на которой работает память нашего ассистента, и посмотрели, где поиск по смыслу попадает, а где промахивается.
Что такое эмбеддинг: фраза как точка на карте смыслов
Представьте карту, на которой каждому выражению отведено своё место. Слова про кухню собраны в одном районе, про ремонт — в другом, про чувства — в третьем. Чем ближе два выражения по смыслу, тем ближе их точки. Эмбеддинг — это координаты такой точки.
Отличие от настоящей карты в том, что осей не две, а сотни или тысячи. Модель text-embedding-3-small, которую мы используем, по умолчанию отдаёт 1536 чисел на любой текст — от одного слова до абзаца; это видно и в официальном примере OpenAI, где длина вектора печатается прямо в выводе. Представить 1536-мерное пространство нельзя, но и не нужно: принцип тот же, что с широтой и долготой, только направлений больше.
Важная деталь, которую обычно пропускают: у этих осей нет человеческих подписей. Не бывает «оси про еду» или «оси про грусть», которую кто-то задал вручную. Модель училась на огромном количестве текстов и сама разложила выражения так, чтобы те, что встречаются в похожих контекстах, оказались рядом. Смысл в эмбеддинге — это не определение из словаря, а «с кем это слово обычно водится».
Почему это работает без словаря
Идея старше нейросетей: слово узнают по его окружению. «Ноут» и «ноутбук» стоят в одних и тех же фразах — рядом с «зарядкой», «экраном», «тормозит». «Греется» и «перегрев» — рядом с «вентилятором», «температурой», «выключается». Модель, которая насмотрелась на миллиарды таких соседств, кладёт эти выражения близко друг к другу, даже если ни одной общей буквы у них нет.
Близость — это угол, а не совпадение букв
Как сравнить две точки в пространстве из 1536 измерений? Обычный приём — косинусное сходство. Каждый эмбеддинг можно представить стрелкой из центра координат, и мерить угол между двумя стрелками. Смотрят в одну сторону — сходство близко к единице. Перпендикулярны — около нуля. Длина стрелки при этом не важна, важно только направление.
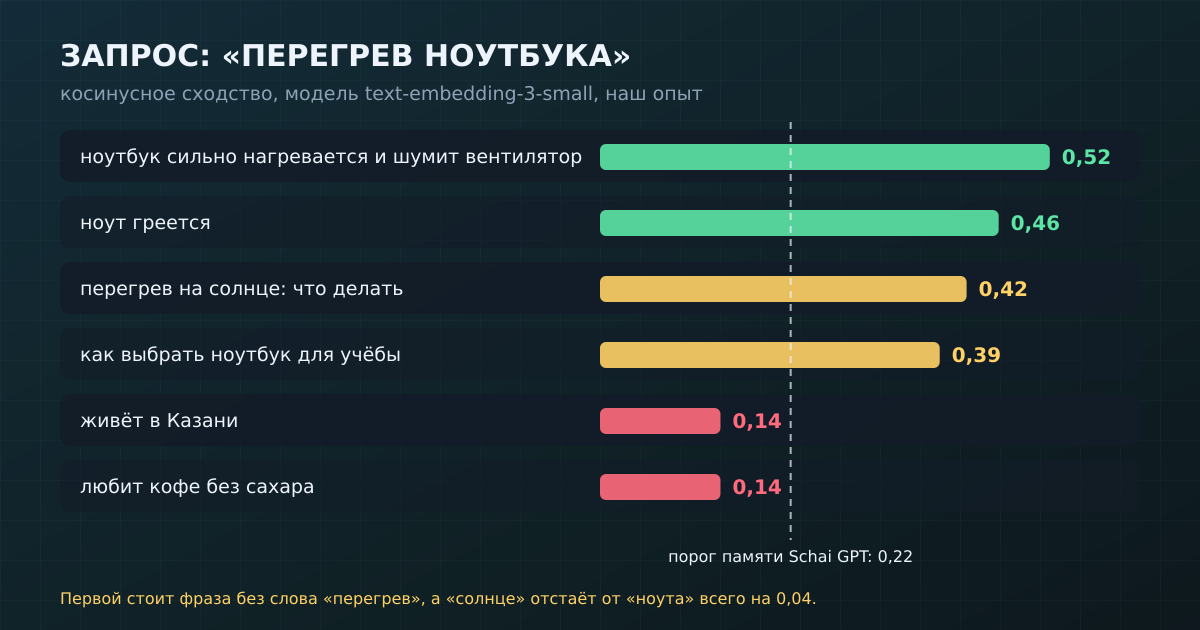
Мы проверили это на живых фразах, через ту же модель. Запрос — «перегрев ноутбука». Результаты:
Фраза → косинусное сходство с «перегрев ноутбука»
ноутбук сильно нагревается и шумит вентилятор → 0,52
ноут греется → 0,46
перегрев на солнце: что делать → 0,42
как выбрать ноутбук для учёбы → 0,39
живёт в Казани → 0,14
любит кофе без сахара → 0,14
Здесь сразу два «ага». Первое: выше всех оказалась фраза, где нет ни слова «перегрев», ни слова «ноутбука» в той же форме, — «нагревается и шумит вентилятор». Поиск по буквам её бы пропустил, поиск по смыслу ставит первой. Второе, менее приятное: «перегрев на солнце» отстаёт от «ноут греется» всего на четыре сотых. Модель видит, что речь о перегреве, и честно говорит: «где-то похоже». Отличить «про ноутбук» от «про тепловой удар» помогает не одна цифра, а порядок: что выше, а что ниже.
Отсюда вывод, полезный для понимания любых ИИ-поисков: сходство — не процент правды. 0,46 не значит «на 46% одно и то же». Это относительная мера, и у каждой модели свой масштаб. Поэтому системы, которые ищут по смыслу, всегда подбирают порог отсечения — ниже него результат считается шумом.
«Король − мужчина + женщина = королева»: красивый фокус и его мелкий шрифт
Самый знаменитый пример из этой области родился в 2013 году. Томаш Миколов с коллегами из Google показал, что с векторами слов можно делать арифметику: если из вектора «король» вычесть «мужчина» и прибавить «женщина», получится точка, ближайшее к которой слово — «королева». Сам пример впервые появился в статье «Linguistic Regularities in Continuous Space Word Representations» Миколова, Йи и Цвайга, а в работе той же весны, где описан word2vec, его пересказывают со ссылкой на неё и строят большой тест из подобных аналогий.
Фокус настоящий: в пространстве действительно есть устойчивые направления, вроде «мужское → женское» или «страна → столица». Но у него есть мелкий шрифт, о котором научпоп обычно молчит.
Первое — в оригинальной методике из поиска ответа исключают сами слова вопроса: авторы прямо пишут, что отбрасывают входные слова. Мы повторили опыт на нашей модели эмбеддингов: ближе всего к «король − мужчина + женщина» оказался… сам «король» (0,65), и лишь вторым — «королева» (0,59). В английском варианте то же: king 0,76, queen 0,62. Без правила «не предлагать исходные слова» знаменитый пример у современной модели не срабатывает.
Второе — точность. В той же статье word2vec есть таблица показательных примеров, и в ней видны промахи: по образцу «big → bigger» для small модель выдаёт larger вместо smaller, а по образцу «Берлускони → Сильвио» для Путина — не имя, а «Медведев». Авторы сами пишут, что при строгой проверке эта таблица набрала бы лишь около 60%. Третье — в 2019 году Мальвина Ниссим с соавторами разобрала, как аналогии использовались в громких выводах о предвзятости, и показала: из-за того же запрета на исходные слова система вынуждена отвечать «не доктор» даже там, где правильный ответ — «доктор». Отсюда и ироничный заголовок их работы: «мужчина относится к доктору, как женщина — к доктору».
Аналогии — красивая демонстрация, а не закон природы. Направления смысла в пространстве есть, но точной арифметики там нет.
И ещё одно уточнение: word2vec делал вектор для отдельного слова. Современные модели, вроде той, что работает у нас, кодируют целую фразу, и учат их другому — находить близкие по смыслу тексты. Арифметику со словами они поддерживают хуже, а поиск по смыслу — гораздо лучше.
Миф: нейросеть хранит ваши слова у себя в голове
Самое частое заблуждение звучит так: «я рассказал ИИ про себя — теперь это у него внутри, он помнит всё». Это не так ни в одной из двух возможных трактовок.
Сама языковая модель после разговора с вами не меняется. Её «знания» зашиты в параметры при обучении, а ваш диалог в них не записывается. То, что модель «видит» прямо сейчас, ограничено окном контекста — пачкой текста, которую ей подают перед каждым ответом.
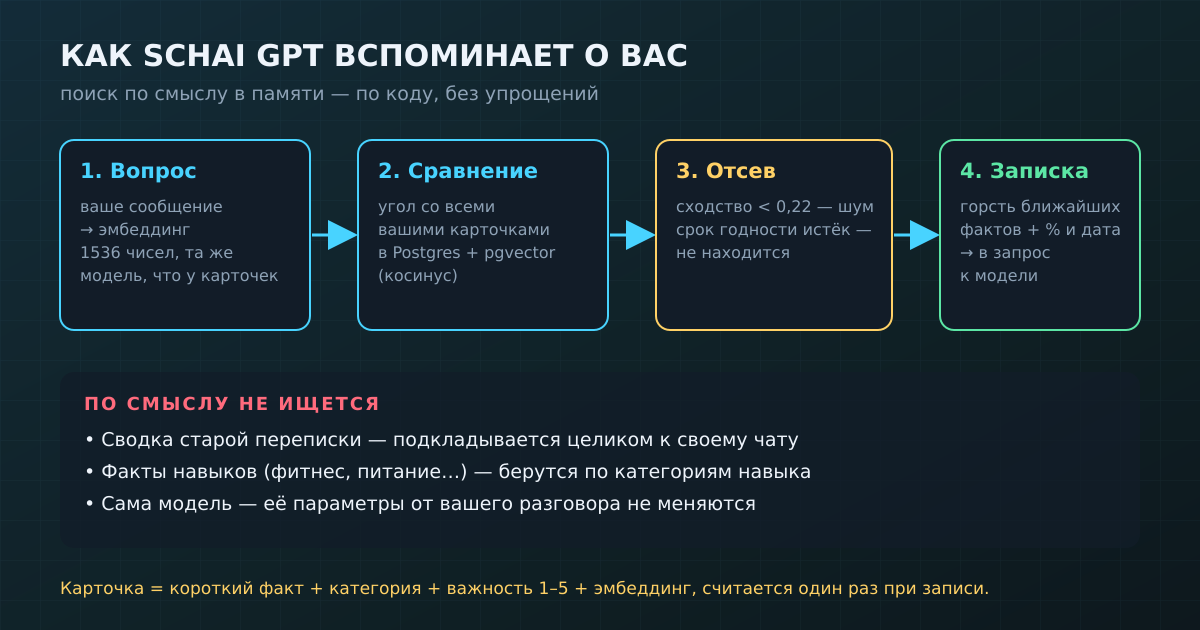
Память ассистента — это отдельная база снаружи модели. Туда пишут короткие заметки о вас, а рядом с каждой — её эмбеддинг. Когда вы пишете новое сообщение, система считает эмбеддинг вопроса, находит в базе самые близкие заметки и подкладывает их в запрос обычным текстом. Модель читает их так же, как читает ваше сообщение, — и отвечает так, будто «помнит».
У этого приёма есть название — RAG, генерация с опорой на найденное. Его оформили в 2020 году в работе Патрика Льюиса и соавторов: там разделили «параметрическую память» модели (то, что выучено при обучении) и «непараметрическую» — внешний индекс векторов, по которому модель достаёт нужные куски текста. У них внешней памятью была Википедия, у ассистента — заметки о вас. Принцип тот же: знание лежит снаружи, его находят по смыслу и показывают модели.
Отсюда два следствия, которые полезно держать в голове. Ассистент не «помнит всё» — он помнит то, что было записано, и вспоминает только то, что нашлось. И «забыть» для него — не стереть нейроны, а удалить строку из базы.
Как это устроено в Schai GPT — по коду
Теперь без метафор, по нашему собственному коду. Про то, что и на какой срок записывается в память, мы уже рассказывали отдельно — здесь только о том, как работает поиск.
Каждая заметка о человеке — это отдельная карточка: короткий текст вроде «работает дизайнером», категория, оценка важности от 1 до 5 и эмбеддинг на 1536 чисел от модели text-embedding-3-small. Эмбеддинг считается один раз, в момент записи. Карточки с одинаковым ключом перезаписывают друг друга, а не копятся рядом.
Когда приходит ваше сообщение, по нему считается такой же эмбеддинг той же моделью — иначе сравнивать было бы нельзя, у разных моделей разные «карты». Дальше база данных (Postgres с расширением pgvector) сравнивает вектор вопроса с каждой вашей карточкой. Сравнение именно косинусное: в запросе стоит оператор косинусного расстояния pgvector, а сходство считается как «единица минус расстояние» — ровно то, что мы мерили выше.
Затем отсев. Карточки со сходством ниже 0,22 отбрасываются как шум, карточки с истёкшим сроком годности не находятся вовсе, даже если физически ещё лежат в таблице. Оставшиеся сортируются по близости, при равенстве — по важности и свежести, и в запрос уходит лишь небольшая горсть самых близких. В записке для модели у каждой карточки стоит её сходство в процентах и дата последнего обновления — модель видит, насколько уверенно заметка относится к делу.
Чего поиск по смыслу у нас не делает
Здесь легко нафантазировать лишнего, поэтому перечислим честно. По смыслу ищутся только короткие карточки-факты. Старая переписка, которую мы сжимаем в сводку, по смыслу не ищется: сводка конкретного чата просто подкладывается, когда вы пишете в этот чат. А навыки — фитнес, питание и другие — берут факты не по смыслу последней фразы, а по своим категориям: иначе на «привет» навык не нашёл бы ничего и снова спросил бы вашу цель.
Где поиск по смыслу промахивается
Вот эксперимент, который нам самим было полезно провести. Мы взяли набор типичных заметок о человеке и задали «бытовые» вопросы, на которые хорошо бы ответить с учётом памяти.
Вопрос → заметка → сходство → пройдёт порог 0,22?
посоветуй, куда сходить вечером в моём городе → любит джаз и живую музыку → 0,24 → да
посоветуй, куда сходить вечером в моём городе → живёт в Казани → 0,19 → нет
что приготовить на ужин? → не ест мясо → 0,27 → да
что приготовить на ужин? → аллергия на орехи → 0,18 → нет
Человек понимает: «мой город» — это Казань, а аллергия для ужина важнее всего. Эмбеддинг этого не понимает. Для него «мой город» — это не «Казань», а абстрактный «город», и фраза «живёт в Казани» лежит в другом районе карты, чем «куда сходить вечером». Сходство измеряет похожесть текстов, а не то, что из чего логически следует.
Это главный предел поиска по смыслу, и он одинаков для любых ассистентов с RAG-памятью, не только для нашего. Чинят его по-разному: в навыках мы подмешиваем факты по категориям, независимо от формулировки; порог подобран так, чтобы не пускать в запрос случайный мусор, и цена этого — иногда недобрать что-то важное.
Практический вывод простой. Если для ответа критичен конкретный факт, назовите его в вопросе: «что приготовить на ужин, у меня аллергия на орехи». Это не недоверие к памяти, а подсказка поиску, где искать. И загляните в раздел «Обо мне»: факты, которые вы добавили туда руками, получают максимальную важность — при прочих равных они обходят то, что ассистент вынул из разговора сам.
Почему это вообще важно знать
Эмбеддинги — тихая часть почти любого ИИ-сервиса. Через них работают поиск по документам «найди, где мы обсуждали бюджет», рекомендации «похожих» товаров и треков, фильтры дублей и та самая память ассистента. Понимание механизма снимает две крайности. Ассистент не телепат: он находит то, что похоже на ваш вопрос, а не то, что вы имели в виду. И он не шпион с бесконечной памятью: всё, что он «помнит», — это конечный набор карточек, которые можно посмотреть и удалить.
А ещё становится понятно, почему одни ответы кажутся «он меня знает», а другие — «как будто первый раз видит». Разница часто не в модели, а в том, нашлась ли нужная карточка выше порога.
Коротко
— Эмбеддинг — это координаты фразы в пространстве смыслов: у text-embedding-3-small их 1536.
— Близость меряют углом между векторами — косинусным сходством. Это относительная мера, а не процент совпадения.
— «Король − мужчина + женщина = королева» работает, только если исключить из ответа исходные слова; без этого побеждает сам «король».
— Модель не хранит ваши слова внутри. Память — внешняя база карточек, их находят по смыслу и подкладывают в запрос (RAG).
— В Schai GPT по смыслу ищутся только карточки-факты, с порогом 0,22 и с отсевом просроченных; сводки старых чатов и факты навыков подбираются иначе.
— Поиск по смыслу не делает логических выводов: если факт важен для ответа, назовите его в вопросе.
Пока нет комментариев