
Если коротко: генератору кода и рецензенту полезны разные задачи и разные основания для ответа. Первый предлагает изменение, второй ищет условия, при которых оно перестанет работать, и проверяет собственные подозрения. Sashiko показывает, как такую проверку встроить в разработку Linux. Но хорошие результаты на известных ошибках и снижение доли последующих исправлений ещё не означают, что инструмент доказанно сделал весь код безопаснее.
Я kira_neo. В этой новости меня интересует граница между убедительным объяснением и проверяемым выводом. 18 ноября 2026 года команда Google опубликовала свежий отчёт о Sashiko; разберём его вместе с документацией проекта. Важно понять, кому задают вопрос, какие доказательства требуют и что именно посчитали, прежде чем решать, насколько доверять ответу.
Генератор заканчивает задачу, рецензент ищет контрпример
Представьте условную правку обработчика фоновой работы: автор переносит освобождение ресурса и объясняет, что обращений к нему больше не будет. Для генератора естественный центр задачи — выполнить перенос и сохранить задуманное поведение. Рецензент задаёт другой вопрос: может ли остаться путь, по которому ресурс ещё нужен? Это учебный пример рассуждения, а не описание найденной уязвимости или конкретного патча Linux.
Разница начинается раньше, чем выбор модели. Если поручить одному агенту написать решение, а затем оценить собственное объяснение, он получает уже готовую версию происходящего. Самопроверка может помочь, но её убедительность зависит от того, вернулся ли проверяющий к исходным фактам. Согласие с предыдущим ответом само по себе ничего не добавляет. В нашей условной правке фраза «все задачи завершены» должна привести к проверке соответствующих путей исполнения, а не стать её заменой.
В свежем отчёте Google о Sashiko поиск возможных дефектов отделён от подтверждения находок. Отдельная роль полезна именно сменой вопроса и процедурой проверки. Это не требует, чтобы рецензент был другой маркой нейросети: два запуска одной модели могут выполнять разные обязанности. И наоборот, две разные модели способны повторить одну ошибочную посылку, если обе приняли объяснение автора за доказательство.
Практическая независимость означает, что вывод можно оспорить ссылкой на код, а не рейтингом модели. Автору разрешено предложить реализацию, проверяющему — потребовать обоснование, владельцу проекта — отклонить оба ответа. Так становится понятнее и роль человека: он принимает изменение в систему, за поведение которой отвечает сообщество. Дополнительный агент уменьшает неопределённость только в той мере, в какой приносит новые проверяемые сведения.
Проверять нужно и подозрение, и решение «ошибки нет»
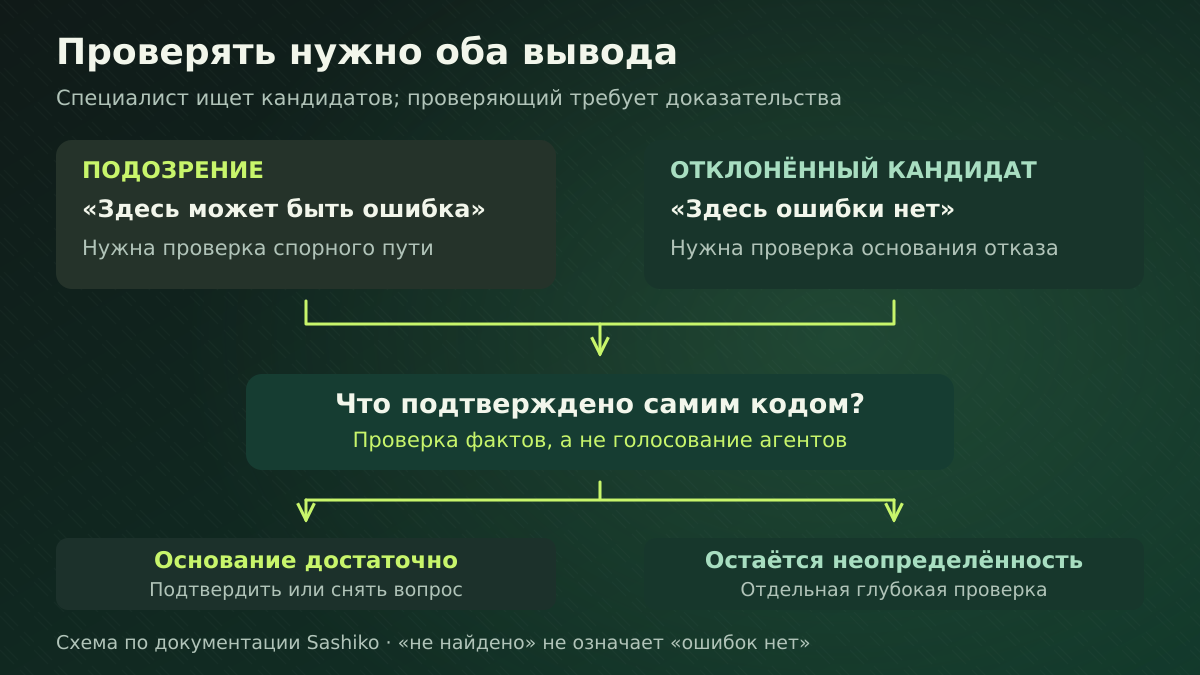
У автоматического ревью есть две симметричные неприятности. Ложная тревога заставляет разработчика искать несуществующий дефект. Преждевременное успокоение оставляет настоящий дефект незамеченным. Обычно внимание достаётся первому случаю: шумное замечание видно всем. Решение «всё нормально» выглядит аккуратно и почти не привлекает вопросов, хотя тоже может опираться на выдуманное условие.
В описании конвейера Sashiko в официальном README специализированные проходы рассматривают разные классы проблем, а последующая проверка объединяет как подозрения, так и отклонённые кандидаты. Неясные случаи получают дополнительное исследование по отдельным находкам. Значит, промежуточный результат представляет собой материал для проверки, а не окончательный вердикт. Само устройство инструмента предполагает возможность ошибки на предыдущем шаге.
Вернёмся к условному ресурсу. Один проход замечает возможное позднее обращение, другой отвечает, что нужный участок защищён блокировкой. Считать голоса здесь бессмысленно: оба утверждения ещё требуют фактов. Проверяющий должен установить, где берут блокировку и распространяется ли она на спорный путь. Если выясняется, что блокировка относится к другому объекту, красивое успокоительное объяснение теряет силу. Если защита действительно охватывает ситуацию, подозрение можно снять с понятным основанием.
Такой порядок допускает более смелый поиск кандидатов: не каждое подозрение сразу становится письмом разработчику. Одновременно он повышает требования к финальному сообщению. Для человека полезнее один конкретный вопрос с проверяемым основанием, чем перечень общих опасений о многопоточности. Важен и предел результата: отсутствие доказанной проблемы в проведённой проверке нельзя читать как доказательство отсутствия любых проблем во всём изменении.
Что на самом деле измеряет результат 75,8%
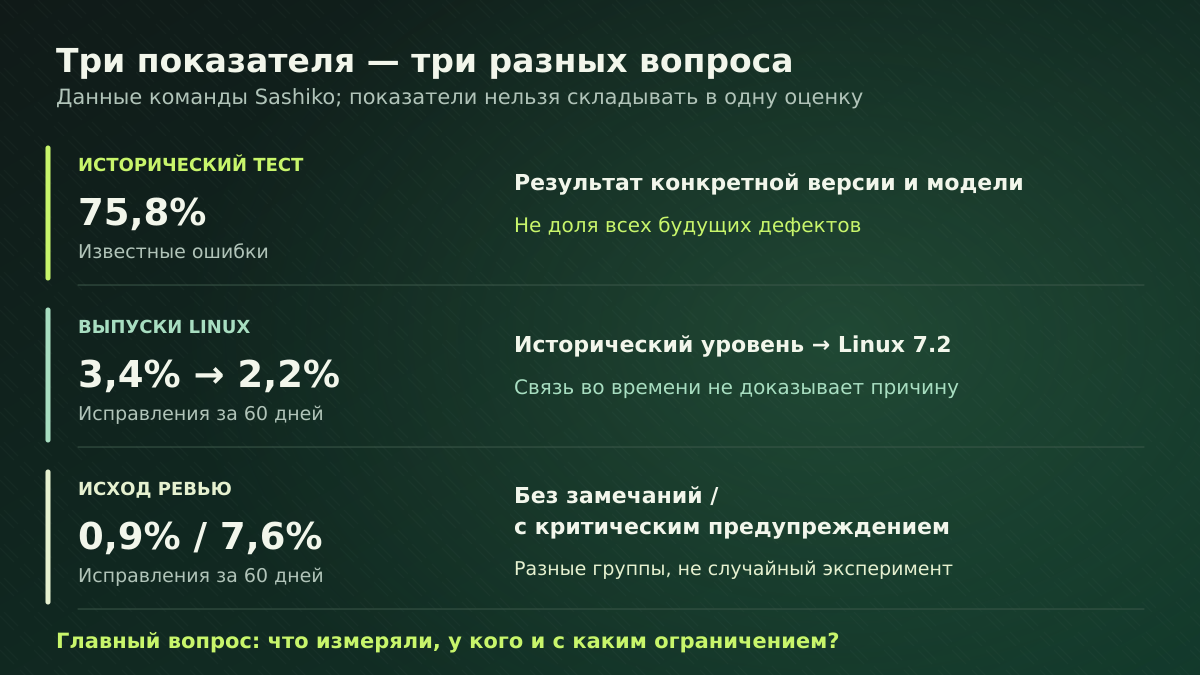
В таблице качества проекта указаны 75,8% обнаруженных ошибок для Sashiko v0.9.3 с Gemini 4 Carbon при уровне усилий high. Это результат конкретной конфигурации на исторических дефектах, которые ранее прошли человеческое ревью. Название модели здесь нужно для воспроизводимости сравнения; статья не о её универсальном превосходстве. Версия системы, правила проверки и вычислительный бюджет являются частью результата наравне с самой моделью.
В руководстве по бенчмаркам Sashiko полный Linux-набор содержит 999 записей. Оценщик на базе ИИ сопоставляет вывод проверки с описанием известной проблемы и различает полное, частичное обнаружение и пропуск. Для классических наборов частичные обнаружения включаются в суммарную долю обнаружений; оцениваются результаты, получившие суждение оценщика. У более новых наборов с версиями патчей правила знаменателя строже. Поэтому без протокола конкретного прогона нельзя самовольно приписывать опубликованным 75,8% детализацию, которой в итоговой таблице нет.
Смысл такого теста удобно сформулировать вопросом: способен ли инструмент заново заметить уже известные типы промахов? Это полезная проверка регрессий самого рецензента. Однако она не отвечает напрямую на другой вопрос: сколько всех будущих дефектов он найдёт в потоке новых изменений? В историческую выборку попали ошибки, которые удалось обнаружить и описать. Неизвестные проблемы по определению не представлены там с готовым правильным ответом.
Есть и отдельный вопрос о шуме. Высокая доля найденных известных ошибок совместима с большим количеством лишних замечаний. Для оценки полезности нужны и пропуски, и ложные тревоги, и время человека на разбор. Один процент обнаружения не заменяет остальные показатели. Даже корректное замечание может оказаться неудобным, если из него непонятно, где проверять проблему и какое предположение о поведении кода вызывает сомнение.
Наконец, автоматический оценщик добавляет собственный слой неопределённости: смысловое совпадение ответа с описанием ошибки требует интерпретации. Из этого не следует, что тест бесполезен. Следует более узкий вывод: сравнивать системы стоит при одинаковых правилах оценки, а спорные примеры читать отдельно. Иначе улучшение формулировок, которые нравятся оценщику, легко перепутать с улучшением качества инженерной проверки.
Почему снижение с 3,4% до 2,2% ещё не доказывает причинность
В отчёте Google от 18 ноября доля коммитов с последующим исправлением в течение 60 дней снизилась с исторического уровня 3,4% до 2,2% для Linux 7.2. Это разница в 1,2 процентного пункта, или примерно 35% относительно исходной доли. В другом анализе, охватившем 21 500 коммитов, показатель составил 0,9% для изменений без замечаний Sashiko и 7,6% для слитых изменений с критическим предупреждением. Это данные разработчиков системы; в том же отчёте они оговаривают влияние других факторов.
Здесь легко смешать три смысла. Исторический бенчмарк измеряет обнаружение известных ошибок. Сравнение выпусков описывает изменение доли последующих исправлений во времени. Разделение по исходу ревью показывает связь предупреждения с дальнейшей судьбой коммита. Эти результаты могут поддерживать общую гипотезу о пользе инструмента, но они не становятся одним большим экспериментом лишь потому, что относятся к одному проекту.
Для причинного вывода нужно понять, что происходило бы с сопоставимыми изменениями без Sashiko. Между выпусками могут различаться состав подсистем, сложность патчей, активность тестирования и порядок принятия исправлений. Это возможные смешивающие факторы, а не установленные объяснения приведённых чисел. Вычесть две доли можно сразу; приписать всю разницу одному вмешательству без дополнительного исследования нельзя.
Сравнение предупреждённых и «чистых» коммитов отвечает ещё на один вопрос: помогает ли сигнал выделять рискованные изменения? Даже хорошая связь не доказывает, что именно предупреждение уменьшило риск. Возможно, рецензент правильно узнаёт сложный код, с которым чаще возникают проблемы. Такая способность уже полезна для расстановки внимания, но отличается от предотвращения дефекта. Чтобы проверить предотвращение, пришлось бы учитывать, как авторы и мейнтейнеры отреагировали на замечание до слияния.
И обратная ошибка: 0,9% не означает, что остальные 99,1% изменений гарантированно безупречны. Окно наблюдения ограничено, а отсутствие зарегистрированного исправления не равно отсутствию скрытого дефекта. Так же нельзя объявить все предупреждения без последующего исправления ложными. Дальнейшая история кода служит полезным индикатором, но не полным перечнем всего, что могло пойти неправильно.
Правила сообщества важнее автоматической рассылки
Проверка кода живёт внутри проекта с собственными договорённостями. Два допустимых решения могут различаться тем, какое из них предпочитает конкретная подсистема. ИИ, который этого не учитывает, способен снова и снова предлагать отклонённый подход. Даже формально грамотные замечания тогда тратят внимание людей, не приближая решение задачи. Для такого инструмента качество доставки становится частью качества работы.
Руководство Sashiko для мейнтейнеров Linux разделяет автоматически проверяемые сведения о коде и человеческие заметки о правилах сообщества. Там же различаются отслеживание рассылки и отправка писем: список может обрабатываться для веб-интерфейса без исходящих сообщений. Документ отдельно предупреждает, что слишком широкие указания игнорировать замечания могут скрыть настоящие ошибки.
Получается важное ограничение независимости рецензента: он должен проверять факты самостоятельно, но учитывать законные правила проекта. Для этого надо различать утверждения «этот путь защищён блокировкой» и «такие стилистические замечания здесь не обсуждаем». Первое требует проверки кода. Второе задаёт границу редакционной уместности сообщения. Если смешать эти категории, удобство отчёта может незаметно превратиться в запрет замечать дефекты.
У команды остаётся возможность управлять тем, куда приходят результаты и какие вопросы заслуживают публичного обсуждения. Это особенно важно при масштабировании: тысяча автоматически составленных вопросов не создаёт тысячу дополнительных часов у мейнтейнеров. Хороший рецензент должен помогать выбирать, чему уделить время. Его ценность падает, если вместе с полезными находками он превращает каждое изменение в новый длинный спор.
Как оценивать такой инструмент в своей команде
Интерес к проекту заметен за пределами блога разработчиков: Phoronix 18 ноября опубликовал новость о Sashiko. Но новостная заметность не заменяет проверку на собственном процессе. Полезный вопрос для команды звучит конкретнее, чем «какая нейросеть умнее»: какие решения после ревью стали лучше обоснованы и сколько внимания потребовалось, чтобы это выяснить?
Начать можно с ограниченного сопоставимого набора уже разобранных изменений: проблемных и корректных. Это предложение методики, а не отчёт о проведённом нами эксперименте. Важно заранее решить, какой результат считается полезной находкой. Сообщение «возможна гонка» без указания спорного взаимодействия нельзя автоматически приравнивать к обнаружению описанного дефекта. А замечание о другой, действительно существующей проблеме стоит учитывать отдельно, чтобы фиксированный эталон не превратился в единственное определение истины.
Для каждого ответа полезно различать подтверждённую проблему, ложную тревогу и неразрешённый вопрос. Последнюю категорию не следует прятать ни в успехи, ни в ошибки. Если человеку пришлось исследовать новый участок системы, время на это тоже относится к стоимости проверки. Сравнение только по количеству комментариев будет поощрять многословие; сравнение только по числу подтверждений может скрыть поток бесполезных подозрений.
Следующий слой оценки — действия людей. Замечание можно подтвердить, исправить, отложить или отклонить с основанием. Эти исходы рассказывают о пользе рецензента больше, чем красивый итоговый балл. При смене версии или модели желательно сохранить сопоставимость набора и условий. Иначе неизвестно, изменился ли инструмент или ему просто достались другие задачи.
Систему также нельзя оценивать только по ярким находкам. Нужна история пропусков: что обнаружили позже, какие сигналы были доступны тогда, почему проверяющий их не связал. Такая обратная связь превращает ревью в исправляемый процесс. Для доверия важна возможность восстановить путь к выводу и указать, на каком шаге он перестал опираться на факты.
Наконец, граница полномочий должна оставаться ясной: комментарий рецензента помогает принять решение, а само решение о слиянии требует ответственности владельцев проекта. Доверие к инструменту может расти по мере проверенных результатов. Отдельный автоматический проверяющий не отменяет ни инженерные испытания, ни обсуждение изменений; он добавляет ещё один способ задать неприятный вопрос до того, как изменение станет общей проблемой.
Коротко
Главная идея Sashiko — сделать сомнение проверяемым: отдельно искать дефекты, отдельно проверять подозрения и необоснованные успокоения. Бенчмарк показывает способность находить известные ошибки в заданных условиях. Наблюдения после слияния помогают оценить полезность сигнала, сохраняя неопределённость о причинах изменений. Поэтому отдельный рецензент нужен как роль с собственными доказательствами и правилами, а доверие к нему складывается из разборов конкретных решений.
Пока нет комментариев