Ошибка деления Pentium: как пять пустых клеток стоили Intel 475 млн долларов

Если коротко: в 1994 году процессор Intel Pentium иногда неверно делил числа с плавающей точкой, потому что в его таблице для быстрого деления не хватало пяти значений. Ошибка проявлялась крайне редко — примерно в одном делении на миллиарды случайных, и обычно где-то в девятом-десятом знаке. Intel узнала о ней раньше всех и тихо исправила в новых чипах, но промолчала про уже проданные. Когда ошибку независимо нашёл профессор математики Томас Найсли, молчание стало скандалом, и компания списала 475 миллионов долларов. Дорого стоил не дефект, а решение о нём не говорить.
Это рубрика «Обо всём», и сегодня у нас история железа, которую на этой неделе снова подняли в топ: материал основан на разборе «Один профессор, один калькулятор и 475 миллионов долларов» с Хабра, но мы пошли дальше и сверили ключевые даты и цифры с первоисточниками — хронологией самого Найсли, пресс-релизом Intel и математическими работами о баге. Кое-где они расходятся с популярной версией, и это самое интересное.
Проверка, которую можно повторить на калькуляторе
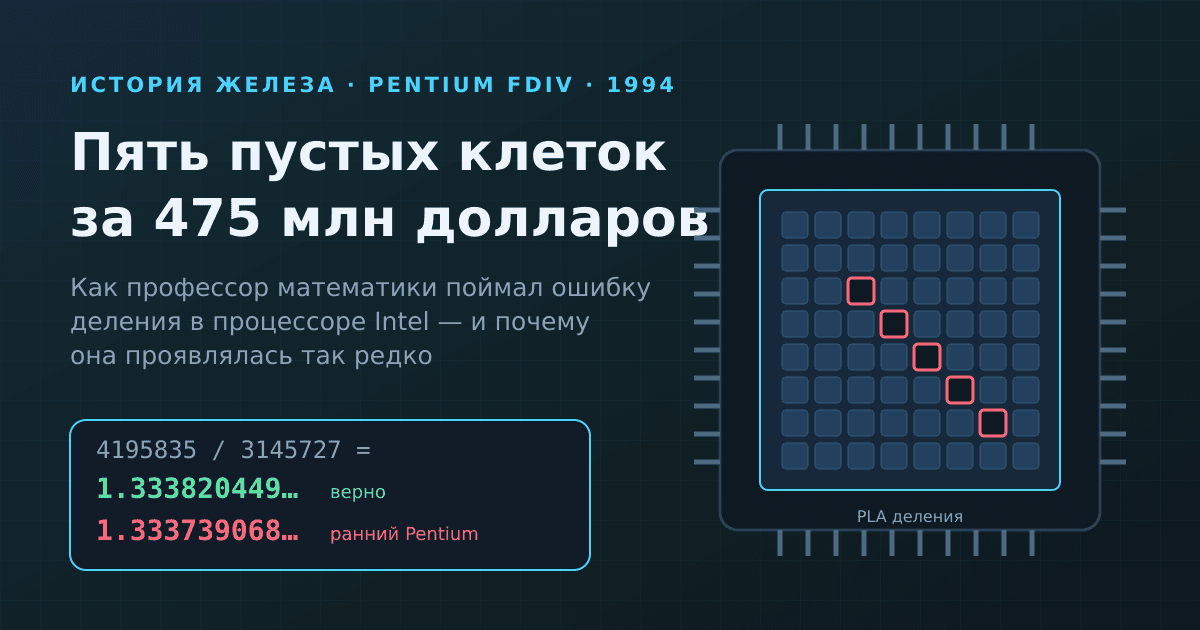
Возьмите любой калькулятор и разделите 4 195 835 на 3 145 727. Получится 1,333820449… Теперь умножьте ответ обратно на 3 145 727 и вычтите исходное 4 195 835 — должен выйти ноль. На ранних Pentium выходило 256: процессор отвечал 1,333739068…, то есть совпадали лишь первые четыре значащие цифры, а с пятой ответ был неверным.
Эту пару чисел придумал не Найсли, а инженер Тим Коу, который по описаниям ошибки восстановил её модель и искал случаи, где промах самый большой. Сам Найсли в своём FAQ о баге так и называет тест — «вычисление Коу» — и приводит оба значения до двадцатого знака. Пример стал мемом именно потому, что он понятен без всякой теории: компьютер за пару тысяч долларов не умеет делить, а дешёвый калькулятор умеет.
Но тут и начинается первый миф. Пара Коу — это специально найденный худший случай. Обычный пользователь Pentium, считавший смету в Excel, скорее всего ни разу в жизни не наткнулся на ошибку. Чтобы понять, почему она была одновременно настоящей и почти невидимой, нужно заглянуть в то, как процессор вообще делит.
Как процессор делит «по таблице»
Деление — самая неудобная для железа арифметика. Сложение и умножение хорошо распараллеливаются, а деление по своей природе пошаговое: как в школьном «уголке», каждая следующая цифра частного зависит от остатка после предыдущей. Предшественник Pentium, процессор 486, делил классическим методом «сдвиг и вычитание» и получал по одному двоичному разряду частного за такт.
Intel хотела, чтобы Pentium считал с плавающей точкой в разы быстрее и мог конкурировать с RISC-процессорами в научных задачах. Как писал журнал Byte в разборе «The Truth Behind the Pentium Bug», для этого инженеры взяли алгоритм SRT — он назван по фамилиям Суини, Робертсона и Тохера, придумавших его почти одновременно — и он выдаёт по два бита частного за такт.
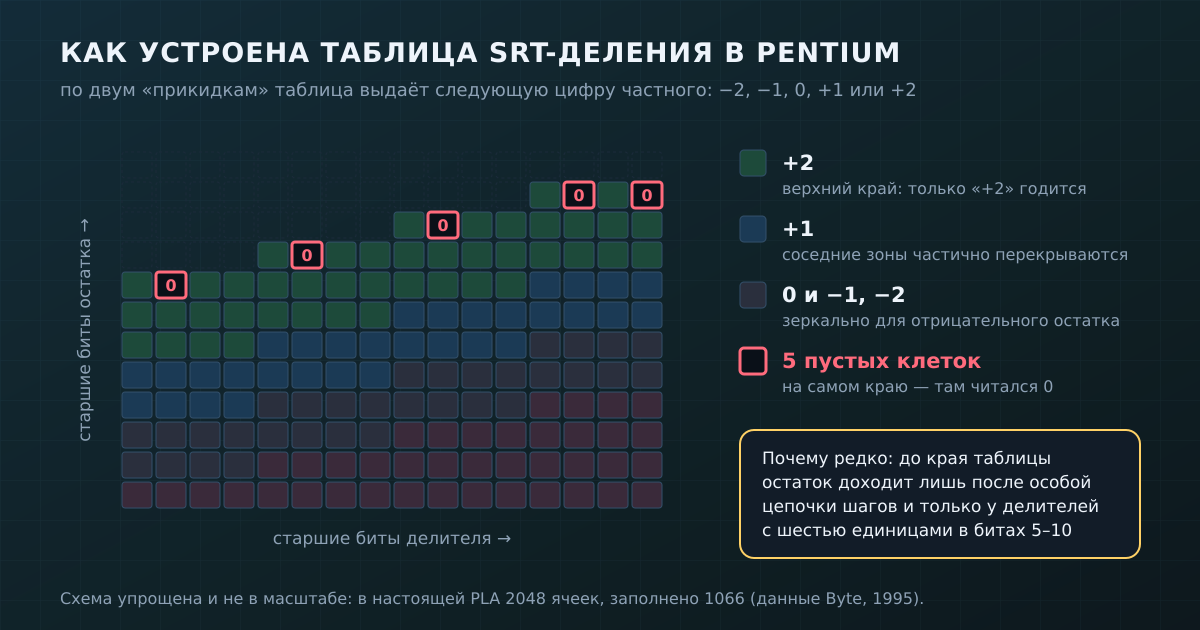
Хитрость SRT в том, что он не вычисляет очередную цифру точно, а угадывает её по таблице. В Pentium частное собирается в системе счисления по основанию 4, и каждая «цифра» может быть одной из пяти: −2, −1, 0, +1 или +2. Чтобы выбрать её, достаточно взглянуть на несколько старших битов делителя и текущего остатка — это быстро, потому что не нужно ждать полного вычитания. По данным Byte, таблица в Pentium была реализована как программируемая логическая матрица (PLA) на 2048 ячеек, из которых значения содержали 1066.
Пять возможных цифр там, где хватило бы четырёх, — это не расточительство, а запас прочности. Благодаря ему многие соседние ячейки таблицы допускают два правильных ответа: если алгоритм выбрал +1 вместо +2, следующий шаг просто доберёт недостающее. Остаток при этом всегда остаётся в коридоре, ограниченном примерно 8/3 от делителя, и пока он внутри коридора, любая неточность выправляется.
Пять пустых клеток на самом краю
Инженер подготовил таблицу на компьютере и написал скрипт, который переносил её в PLA. В скрипте была ошибка: пять из 1066 значений не попали в чип, и, как подчёркивает Byte, никто потом не сверил содержимое матрицы с исходной таблицей. В пустых ячейках вместо +2 читался ноль.
И вот здесь «ага!»-момент всей истории. Те самые пять ячеек лежали не где-нибудь, а на внешней границе таблицы — там, где остаток уже упёрся в верхний край коридора и годится только один ответ, +2. Запас прочности SRT, который прощает ошибки в середине таблицы, на краю не работает: если вместо +2 взять 0, остаток выскакивает за пределы коридора, и последующие шаги уже не могут его вернуть. Ошибка застревает в результате.
Почему же это случалось так редко? Потому что до края таблицы остаток доходит лишь при особом сочетании битов. Математик Алан Эдельман из MIT в статье «The Mathematics of the Pentium Division Bug» в SIAM Review доказал, что под угрозой только делители, у которых в двоичной записи с 5-го по 10-й разряд стоят шесть единиц подряд. Число 3 145 727 в шестнадцатеричной записи выглядит как 2FFFFF — сплошные единицы, идеальная мишень. Но даже такой делитель не гарантирует ошибку: нужен ещё подходящий делимый, чтобы цепочка шагов вывела остаток точно в пустую клетку. Эдельман также показал, что худшая абсолютная ошибка для чисел в диапазоне от 1 до 2 — порядка одной стотысячной.
В 2024 году исследователь Кен Ширрифф рассмотрел этот участок кристалла под микроскопом и насчитал в PLA шестнадцать пустых ячеек, а не пять. Но одиннадцать из них лежат в области, куда алгоритм никогда не заходит, так что вредных действительно ровно пять. По сути, Intel повезло: ошибка в скрипте могла быть и куда заметнее.
Профессор, который сверял всё дважды
Томас Найсли преподавал математику в Линчбургском колледже в Вирджинии и занимался вычислительной теорией чисел: перебирал простые числа-близнецы вроде 11 и 13 и суммировал их обратные величины. Эта сумма сходится к константе Бруна, но очень медленно, поэтому считать приходится триллионы слагаемых на многих машинах сразу.
Главная деталь из его собственной хронологии — Найсли был параноиком в хорошем смысле. Он считал одни и те же суммы двумя способами: на сопроцессоре с 80-битной точностью и отдельно — сверхточной целочисленной арифметикой, а заодно сверял промежуточные результаты с уже опубликованными значениями. Pentium появился в его вычислительной «ферме» в марте 1994 года.
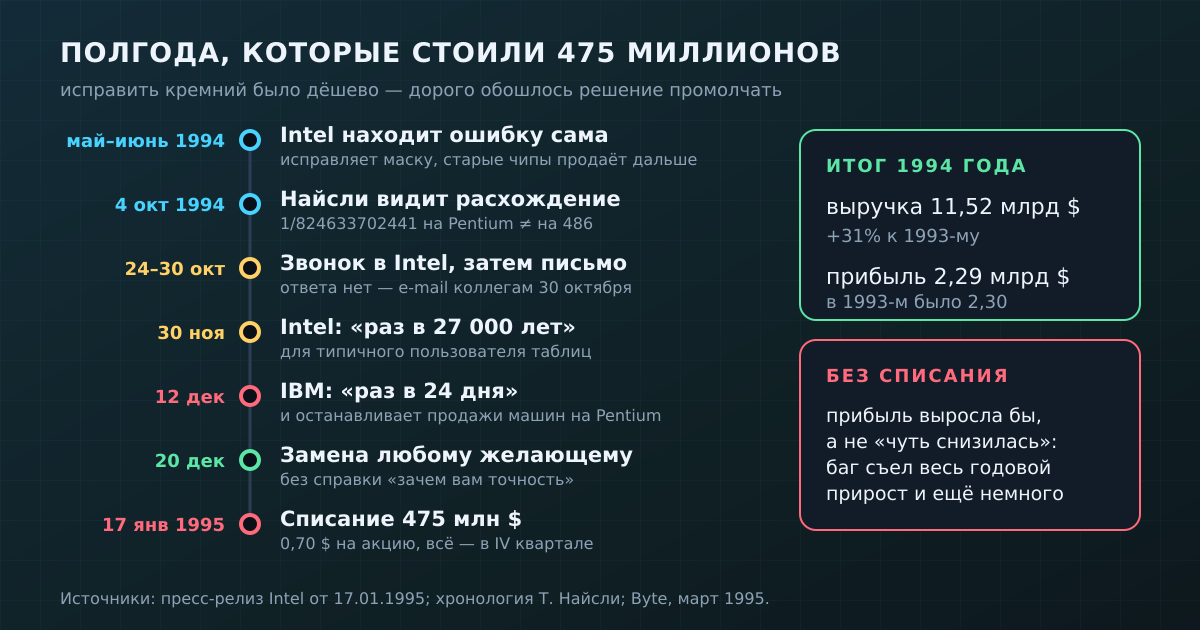
Популярная версия гласит, что уже 13 июня он заметил ошибку Pentium. На деле в тот день всплыло другое расхождение — неверное количество простых чисел до 2·10¹³, и Найсли сам пишет, что оно, вероятно, было связано с другими инструкциями сопроцессора. Он месяцами искал причину, нашёл ошибки в компиляторе Borland и переписал код. А 4 октября обнаружил новую проблему: суммы обратных величин на Pentium-60 и на 486DX-33 расходились гораздо сильнее, чем допускает погрешность округления. Двоичным поиском он сузил её до пары близнецов 824 633 702 441 и 824 633 702 443: процессор неверно считал 1/824633702441.
Дальше — образцовая отладка. 17–19 октября ошибка повторилась на чужом Pentium с другой материнской платой, в программе на Power Basic и в электронной таблице, и исчезла при отключённом сопроцессоре. 21 октября 486-й компьютер с той же шиной PCI ошибки не показал. 22 октября Найсли проверил выставочный Packard Bell в магазине канцтоваров Staples — тот тоже ошибался. 24 октября он позвонил в поддержку Intel, не получил вразумительного ответа и 30 октября разослал письмо коллегам и техническим журналистам с просьбой проверить их машины.
Миф: Intel ничего не знала
Знала, и раньше Найсли. По его записям, 2 ноября менеджер Intel подтвердил, что анализ верен и что компания сама заметила проблему при собственных испытаниях — как выяснилось позже, в мае или июне 1994 года, когда тестировали похожий блок для следующего поколения процессоров. Исправленную таблицу заложили в новые ревизии чипа, а уже выпущенные процессоры продолжали продавать без предупреждения.
С инженерной точки зрения это выглядело разумно: у любого процессора есть список известных ошибок, а эта, по расчётам самой Intel, грозила обычному пользователю исчезающе редко. Но Pentium активно рекламировали обычным людям, и эти люди умели делить на калькуляторе. Письмо Найсли за несколько дней разошлось по CompuServe и Usenet, 7 ноября вышла первая статья в отраслевой газете EE Times, а 21 ноября историю рассказал CNN. Самому Найсли Intel к тому времени уже прислала исправленные процессоры.
Дальше развернулась битва вероятностей, которую Byte подробно разобрал в той же статье. Intel утверждала, что типичный пользователь электронных таблиц столкнётся с ошибкой раз в 27 000 лет. IBM, которая в декабре сняла свои компьютеры на Pentium с продажи, насчитала «раз в 24 дня». Byte оценил, что на случайных числах ошибка в девятом-десятом знаке случается примерно раз на 9 миллиардов делений, а в четвёртом-пятом значащем знаке, как в примере Коу, — раз на 360 миллиардов. Спор так и не разрешился, потому что всё упирается в допущения: насколько «случайны» числа в реальных расчётах.
Сколько на самом деле стоили пять клеток
Сначала Intel меняла процессор только тем, кто сможет объяснить, зачем ему точное деление. Это и стало главной ошибкой. В декабре компания отступила и предложила замену любому владельцу такого Pentium.
Цифру 475 миллионов долларов легко проверить: она стоит прямо в пресс-релизе Intel от 17 января 1995 года. Это разовое списание до налогов в четвёртом квартале 1994-го — на замену процессоров, материалы и уценку складских запасов старых чипов. Списание стоило 70 центов на акцию.
А теперь деталь, которую обычно пропускают. В том же релизе Intel отчиталась о рекордном годе: выручка выросла на 31%, до 11,52 миллиарда долларов. Но чистая прибыль после списания составила 2,29 миллиарда против 2,30 миллиарда годом раньше. Иными словами, пять пустых ячеек и полгода молчания съели весь прирост прибыли за год, в котором продажи росли на треть. Сам ремонт кремния к тому моменту был давно сделан и стоил копейки на фоне этой суммы — дорого обошлась реакция.
«Проблема с делением в Pentium стала для Intel уроком. В конечном счёте, думаю, она укрепит компанию, улучшив наши правила и инфраструктуру обслуживания потребителей». — Энди Гроув, глава Intel, пресс-релиз от 17 января 1995 года
Что изменилось после FDIV
Во-первых, индустрия всерьёз взялась за формальную верификацию — математическое доказательство того, что схема делает ровно то, что задумано, на всех возможных входах, а не только на тестовых. Уже в 1996 году на конференции DAC вышла работа Кларка, Хайры и Чжао с говорящим названием «Word level model checking — avoiding the Pentium FDIV error». А к процессору Core i7 (Nehalem) Intel, по статье Кайволы и коллег на конференции CAV 2009, сделала формальную верификацию основным способом проверки исполнительного ядра и отказалась там от тестирования на покрытие — работа заняла около двадцати человеко-лет.
Во-вторых, процессоры научились исправлять себя программно. Начиная с семейства P6 (Pentium Pro) в них появился механизм обновления микрокода: часть ошибок, которые раньше означали бы отзыв, теперь закрывается патчем, который приезжает с обновлением BIOS или операционной системы. Ошибку FDIV так исправить было бы нельзя: таблица была «зашита» в логику, а не записана в микрокод.
В-третьих, урок для всех, кто делает продукты: ошибка, о которой пользователь узнаёт от постороннего, стоит в разы дороже ошибки, о которой ему честно рассказал производитель. Найсли же после всей этой истории ещё много лет продолжал считать свою константу — на исправных процессорах и всё так же сверяя всё дважды.
Коротко
- Pentium делил с ошибкой из-за пяти незаполненных ячеек в таблице алгоритма SRT: скрипт не перенёс их в чип, и вместо +2 там читался ноль.
- Ошибка была редкой, потому что пустые ячейки лежали на краю таблицы, куда остаток доходит лишь у особых делителей с шестью единицами подряд в разрядах 5–10.
- Обычно промах был в девятом-десятом знаке; пример 4195835/3145727 — специально найденный худший случай.
- Intel узнала о баге летом 1994-го, исправила его в новых чипах, но не предупредила покупателей — это и превратило дефект в скандал.
- Списание 475 млн долларов съело весь прирост прибыли Intel за рекордный 1994 год.
- После FDIV индустрия пришла к формальной верификации и обновляемому микрокоду.
Пока нет комментариев