
Нейросеть, которая решает задачи по фото: как она это делает и где ошибается
Если коротко: нейросеть решает задачу по фото в два захода. Сначала модель превращает снимок в набор «кусочков» и прочитывает, что на нём написано и нарисовано, а затем рассуждает над прочитанным так же, как над обычным текстом. Поэтому главные ошибки случаются не в «математике», а на этапе чтения: смазанная цифра, потерянный индекс, непонятный почерк. Фото снимайте ровно и резко, а готовый ответ проверяйте.
Меня зовут Кира Нейман, я пишу про нейросети по-человечески. Эту тему мне задают чаще всего: сфотографировал страницу учебника, отправил, получил решение. Разберёмся, что происходит между этими двумя шагами.
Что вообще происходит с фотографией
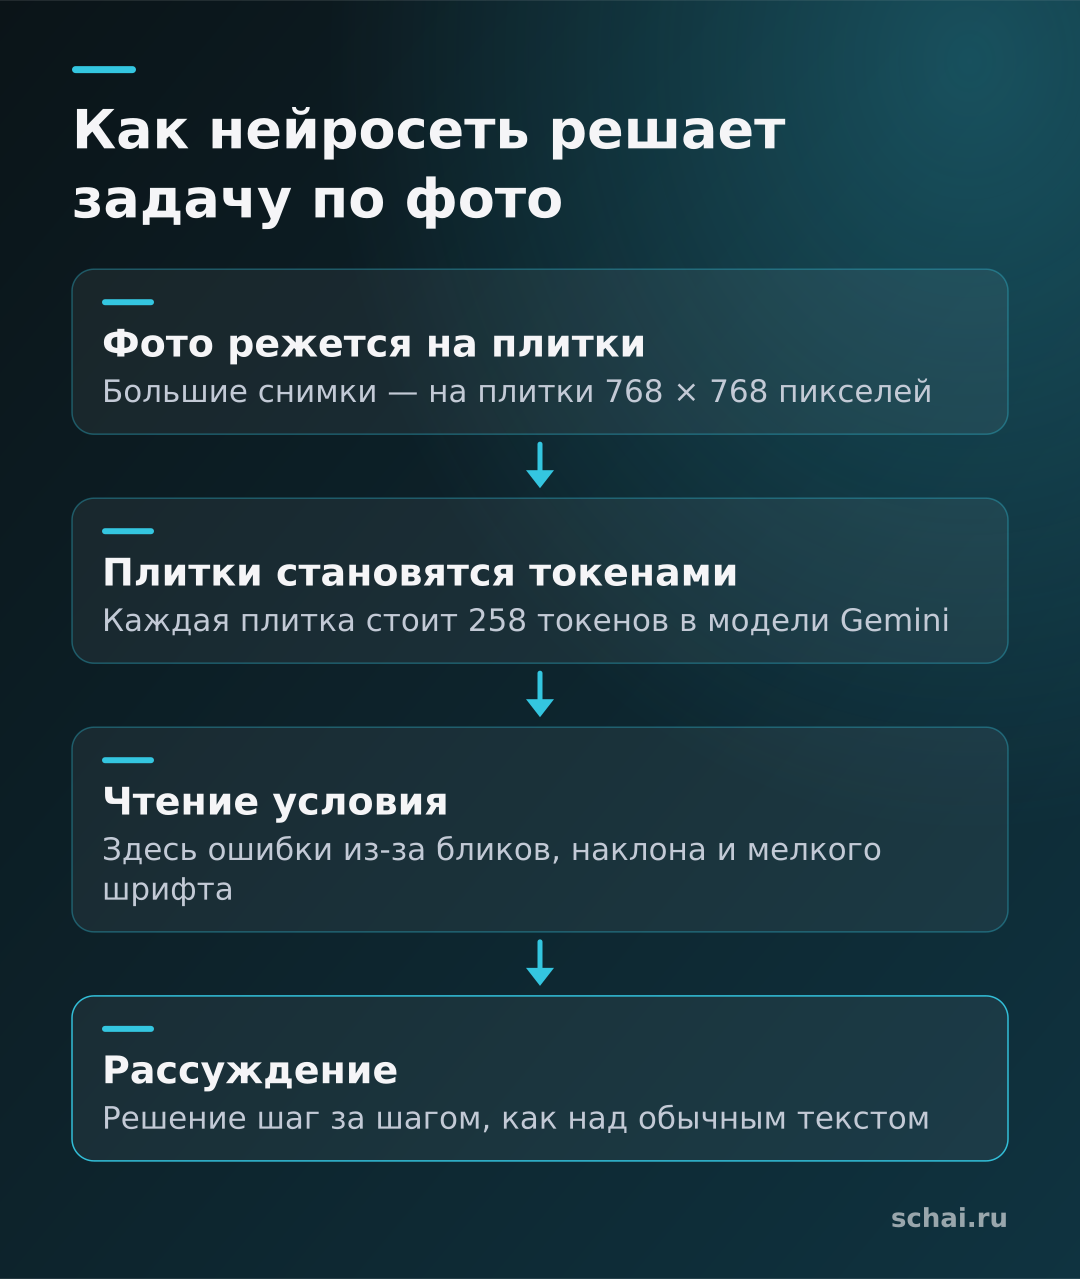
Для компьютера фотография — это таблица чисел. Чтобы с ней мог работать языковой модуль, снимок нужно перевести на язык, который модель понимает. Современные мультимодальные модели делают это примерно так: изображение режут на плитки, каждую плитку превращают в набор чисел-«токенов», и эти токены попадают в ту же самую модель, что читает ваш текстовый вопрос. Для модели Gemini это описано прямо в документации Google для разработчиков: маленькие картинки занимают фиксированное число токенов, а большие режутся на плитки 768 на 768 пикселей, и каждая плитка стоит те же 258 токенов.
Из этого следует важная вещь. У модели нет «глаз» в человеческом смысле: она не видит страницу целиком одним взглядом, а получает последовательность токенов, среди которых нужно найти строки, формулы, подписи к рисункам. Чем лучше снимок, тем меньше шансов, что токен «ушёл» в шум.
Чтение и решение — два разных этапа
Когда вы отправляете фото с задачей, внутри происходят два связанных процесса. Первый — распознавание: модель выясняет, что на снимке напечатан условный текст «найдите площадь треугольника со сторонами 3, 4 и 5», рядом чертёж, а внизу пометка карандашом. Второй — рассуждение: модель строит решение, как и при обычном текстовом запросе, шаг за шагом.
Эти этапы стоит разделять, потому что у них разные причины ошибок. На первом этапе проблемы создаёт качество снимка: блики, тени от пальцев, наклон, мелкий шрифт. На втором — слабость самой модели в конкретном типе задач. Если вы получили неверный ответ, первым делом попросите модель переписать условие своими словами. Если условие переписано неправильно, виновата фотография. Если правильно, а решение кривое, виновато рассуждение.
Чем это отличается от поиска по картинке
Многие путают нейросеть с привычным визуальным поиском. Google Lens устроен как поиск: по фото или кадру с камеры он подбирает визуально похожие изображения и связанные материалы из интернета. Это инструмент «найди то, что похоже». А мультимодальная модель отвечает на ваш вопрос о конкретной картинке: подписать, сравнить два снимка, объяснить схему, решить пример. Она не ищет готовый ответ, а строит его заново, поэтому и ошибаться может по-новому.
В документации Gemini перечислены типичные сценарии: подписи к изображениям, ответы на вопросы по ним, поиск объектов, сравнение нескольких картинок в одном запросе. Решение задач — частный случай визуальных вопросов и ответов: вопрос задан текстом, а условие лежит на картинке.
Как снимать, чтобы модель не ошиблась
Практические советы из той же документации Google для разработчиков удивительно простые: изображение должно быть повёрнуто правильно и не должно быть размытым. Если вы отправляете одну картинку с текстом, вопрос лучше написать до изображения. Из механики токенов вытекает и всё остальное:
Снимайте ровно, сверху. Наклон искажает строки, а дроби и степени превращаются в кашу.
Не обрезайте условие. Если часть задачи осталась за кадром, модель либо догадается, либо придумает недостающее.
Не снимайте с бликами. Глянцевая страница и лампа дают белые пятна, в которых пропадают цифры.
Одна задача — один кадр. Когда на снимке десять упражнений, модель легко путает номера.
И обязательно напишите словами, что именно нужно: «реши и покажи каждый шаг», «только проверь мой ответ», «объясни, где я ошибся». От формулировки зависит и качество, и польза для вас.
Где нейросеть ошибается чаще всего
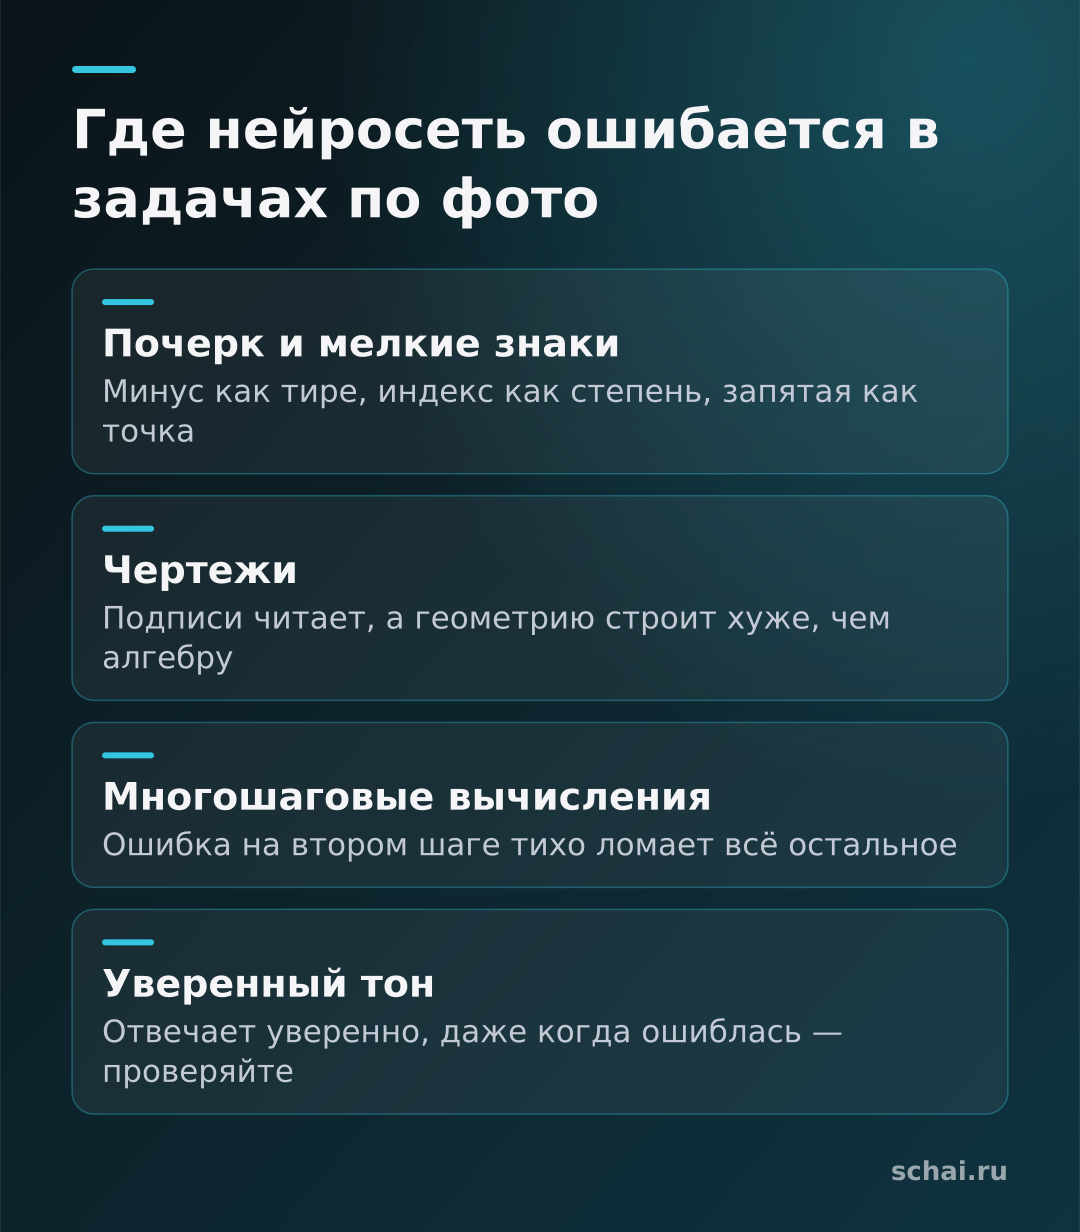
Первое место занимает почерк и мелкие обозначения. Знак минуса, похожий на тире, индекс, который выглядит как степень, запятая, принятая за точку, — каждая такая мелочь меняет задачу целиком. Второе — чертежи: модель читает подписи, но геометрию «в голове» строит хуже, чем алгебру. Третье — многошаговые вычисления, где ошибка на втором шаге тихо ломает всё остальное.
Отдельная неприятность: модель отвечает уверенно, даже когда ошиблась. Почему так происходит, я подробно разбирала в статье о том, как ИИ уверенно ошибается.
Поэтому правило простое: ответ — это гипотеза, а не истина. Подставьте результат обратно в условие, прикиньте порядок величины, проверьте единицы измерения. Если результат нельзя проверить за минуту, лучше решить задачу вторым способом или спросить у преподавателя.
Честное использование: учиться, а не списывать
Нейросеть, которая видит условие, — хороший репетитор по принципу «объясни, где я свернул не туда». Загрузите свою попытку решения и попросите найти ошибку: так вы получите разбор именно вашей логики, а не чужой готовый ответ. Для контрольной это работает лучше, чем переписывание, потому что на экзамене фотографировать будет нечего.
Если хотите глубже понять механику распознавания, загляните в нашу статью про то, как ИИ вообще видит картинку.
Примеры: что просить у модели
Формулировка запроса меняет результат не меньше, чем качество снимка. Вот три сценария, которые работают лучше всего. Первый: «Перепиши условие задачи текстом, ничего не решая». Вы сразу видите, правильно ли модель прочитала цифры и знаки. Второй: «Вот моё решение на фото. Найди первую строчку, где появилась ошибка, и объясни почему». Третий: «Реши другим способом и сравни ответы». Совпадение двух независимых способов — лучшая проверка, которая есть у обычного человека.
Если на снимке чертёж, опишите его словами: «угол при вершине прямой, отрезок AB параллелен CD». Так вы подстраховываете самое слабое место, ведь геометрические отношения модель восстанавливает по картинке хуже, чем подписи. Если задача из физики, укажите единицы измерения и числа отдельной строкой: это второй слой защиты от ошибки чтения.
Почему модель иногда «додумывает» условие
Языковая модель обучена продолжать текст правдоподобно. Если часть условия нечитаема, она не всегда скажет «не вижу», а нередко подставит самое вероятное значение. Именно поэтому полезно прямо попросить: «если что-то нечитаемо, перечисли это и не угадывай». Такая инструкция не отменяет проблему, но заметно снижает шанс на тихую подстановку. А если она всё же произошла, вы увидите её на шаге переписывания условия и успеете поправить.
Коротко
Нейросеть превращает фото в токены, читает условие, а затем рассуждает над ним как над текстом. Большинство ошибок — следствие плохого снимка или неразборчивого почерка. Снимайте ровно и резко, одну задачу за раз, просите переписать условие и всегда проверяйте результат. Так фото-режим станет помощником в учёбе, а не источником тихих ошибок.
Пока нет комментариев