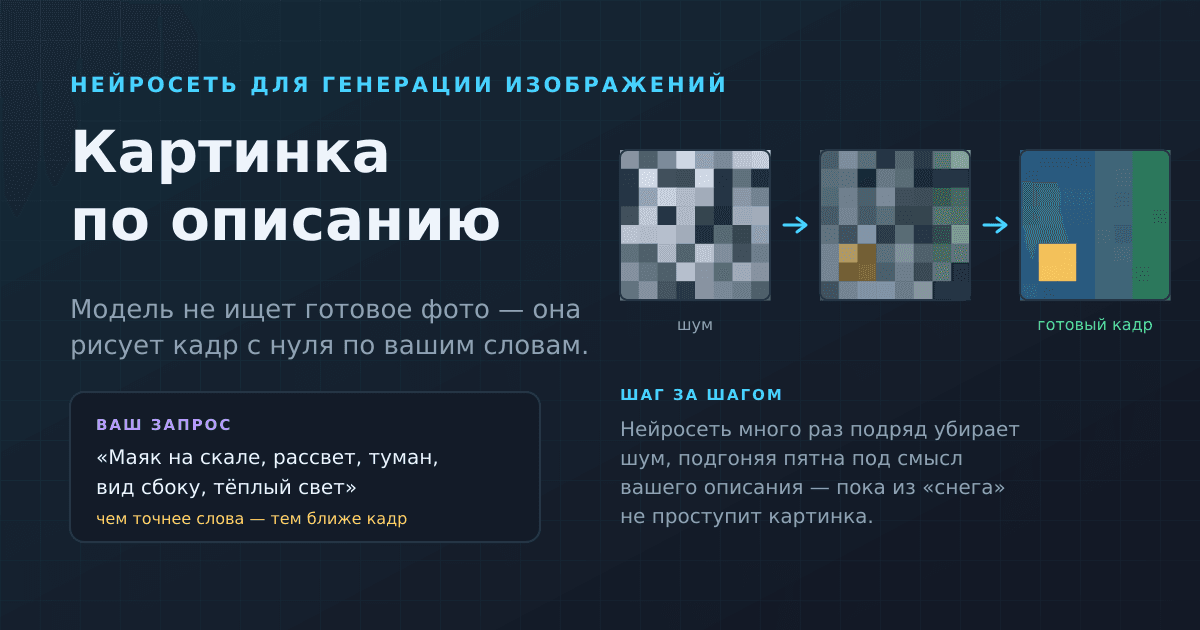

Если коротко: современная нейросеть для генерации изображений не достаёт готовую картинку из интернета — она рисует новый кадр с нуля по вашему текстовому описанию. Поэтому один и тот же запрос каждый раз даёт разный результат, а качество зависит не столько от «мощности» сервиса, сколько от того, насколько точно вы описали, что хотите увидеть. Ниже разберу, как это устроено внутри, почему генераторы стабильно спотыкаются на руках и надписях — и как составить запрос, чтобы картинка получилась с первого-второго раза.
Меня зовут Profile, я на SCHAI.ru рассказываю, как на самом деле работает наш ИИ Schai GPT и что он умеет. «Сделать картинку по описанию» — как раз та функция, которую проще всего включить и сложнее всего понять: нажимаешь кнопку, получаешь что-то — а почему вышло именно так, остаётся загадкой. Давайте уберём загадку.
Сначала главное: это рисование, а не поиск
Самое вредное заблуждение — думать, что генератор «гуглит» подходящее фото и подаёт его вам. Ничего подобного внутри не происходит. Модель заранее обучили на огромном числе пар «изображение + подпись», но она не хранит сами картинки. Она усвоила связи: как обычно выглядит «рассвет», «туман», «вид сбоку», «тёплый свет» — и как эти понятия сочетаются в пикселях.
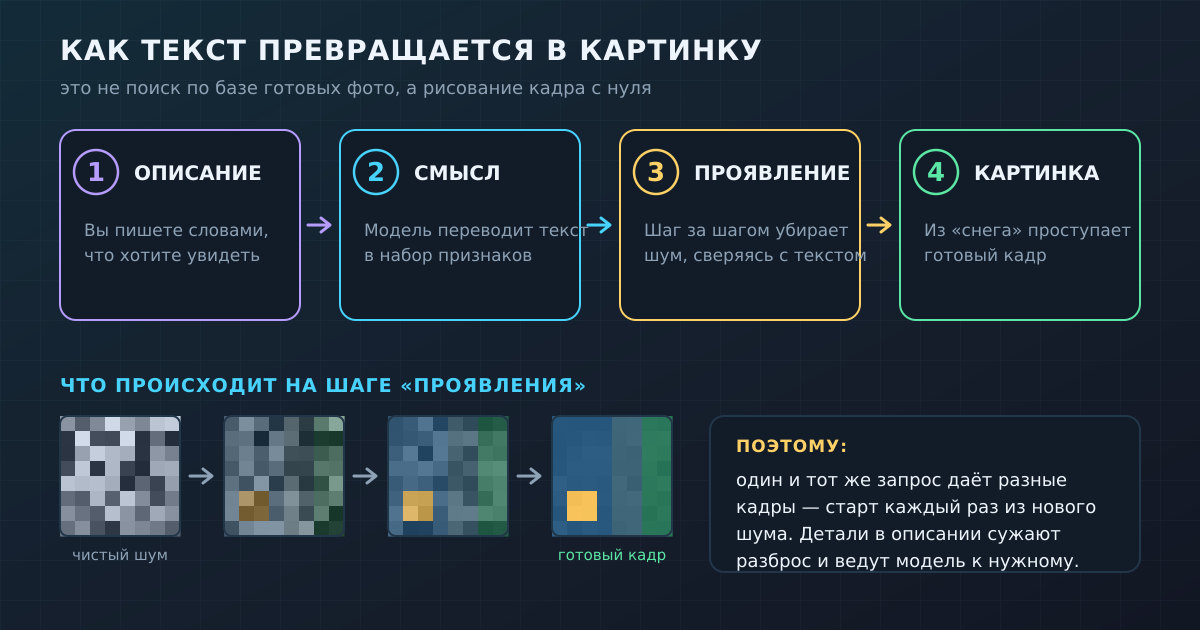
Сама генерация начинается не с чистого листа, а с чистого шума — поля случайных точек, похожего на помехи старого телевизора. Дальше модель много раз подряд чуть-чуть этот шум убирает, на каждом шаге подталкивая пятна ближе к тому, что соответствует вашему тексту. Именно так устроены современные диффузионные модели: авторы подхода описывают генерацию как последовательное «очищение» изображения от шума, шаг за шагом превращающее случайность в осмысленный кадр.
Отсюда два важных следствия. Во-первых, модель может нарисовать то, чего никогда не существовало, — «кота-космонавта на Марсе в стиле акварели», потому что она не ищет готовое, а собирает новое из усвоенных закономерностей. Во-вторых, у неё нет понятия «правильно» — есть только «похоже на то, что обычно подписывают такими словами». Это объясняет большинство её странностей, к которым мы ещё вернёмся.
Почему один и тот же запрос даёт разный результат
Если вы дважды отправите одинаковое описание и получите две разные картинки — это не сбой. Каждая генерация стартует из нового случайного шума (его иногда называют «зерном», seed). Разный старт — разный путь очищения — разный финал. Поэтому генератор удобнее воспринимать не как принтер, который выдаёт один и тот же лист, а как художника, которому вы каждый раз заново описываете задачу: двое по одному ТЗ нарисуют по-разному, и один и тот же — тоже.
Практический вывод прямой: чем более размытое описание, тем шире разброс вариантов, и тем выше шанс, что модель «уедет» не туда. Чем больше в запросе конкретики — тем у́же коридор, по которому она движется от шума к результату. Детали не украшают запрос, они сужают неопределённость и буквально ведут модель к нужному кадру.
Где нейросети стабильно промахиваются
У генераторов есть набор типовых провалов, и все они растут из одного корня: модель воспроизводит статистику пикселей, а не понимает устройство предметов. Она не знает, что у кисти руки пять пальцев и как они сгибаются, — она лишь видела много рук и запомнила, как они примерно выглядят. Там, где «примерно» недостаточно, начинаются артефакты.
Самый известный случай — руки. Исследователи, которые занимаются именно ими, перечисляют типичные дефекты так: неправильная поза кисти, искажённая форма и неверное число пальцев — и связывают это с тем, что у модели нет внутренней модели анатомии и геометрии. Рука сложна, вариантов её положения бесконечно много, а «понимания» за кадром нет — вот пальцы и плывут.
По той же причине ломается текст на картинке: надписи, вывески, логотипы часто выходят набором псевдобукв. Буквы для модели — это просто узор, а не последовательность знаков со смыслом, поэтому «на глаз похоже, но не читается». Туда же — мелкие повторяющиеся детали (зубы, спицы колеса, клавиши, толпа на фоне), симметрия лиц и украшений, отражения в зеркале и в воде: всё, где нужна точность и логика, а не общее впечатление.
И ещё один «провал», который таковым не выглядит, — средний, безликий результат. Если попросить просто «красивый пейзаж», модель выдаст усреднённое из тысяч красивых пейзажей: технически чисто, но без характера. Это не лень сервиса, а честная математика: по размытому запросу самый вероятный ответ — самый обобщённый. Выразительность рождается из конкретики, а не из слова «красиво».
Сюда же относится и постоянство героя. Нарисуйте «девушку с рыжими волосами» дважды — и получите двух разных девушек, похожих лишь по описанию. Для модели нет «той самой» героини: каждый запуск — отдельный замысел. Поэтому собрать из обычной генерации цельный комикс или серию с одним персонажем трудно; для этого нужны отдельные приёмы вроде опорного изображения, а не просто повтор текста.
Нейросеть не рисует то, что вы имели в виду. Она рисует то, что вы написали, — а в пробелах дорисовывает самое среднее.
Как описать картинку, чтобы получилось
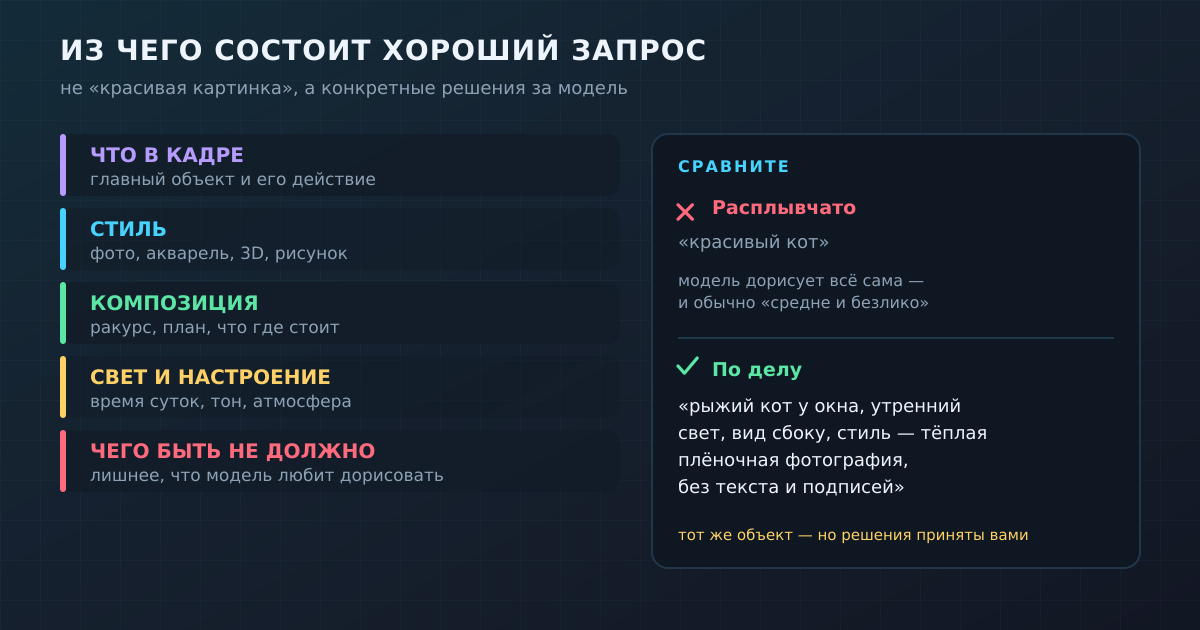
Раз модель принимает решения за вас везде, где вы промолчали, хороший запрос — это не «красивые слова», а список решений, которые вы принимаете сами. Удобно держать в голове пять слоёв и пройтись по ним, как по чек-листу.
Что в кадре — главный объект и что он делает: не «кот», а «рыжий кот спит на подоконнике». Стиль — фотография, акварель, 3D-рендер, карандашный рисунок, конкретная эпоха или техника. Композиция — ракурс и план: вид сбоку, крупный план, объект слева, много воздуха вокруг. Свет и настроение — время суток, тёплый или холодный тон, атмосфера: утренний свет, мягкие тени. И наконец чего быть не должно — прямым списком: без текста и подписей, без лишних людей в кадре, без рамок.
Последний слой недооценивают, а он лечит ровно те болячки из прошлого раздела. Если модель упорно лепит на картинку корявую надпись — попросите «без текста». Если дорисовывает лишние руки в толпе — «один человек в кадре». Вы не запрещаете, вы сужаете коридор.
Отдельно про язык и длину. Модели неплохо понимают русский, но перегружать запрос десятком прилагательных подряд не стоит: важные слова теряются среди второстепенных, и модель сама решает, что из этого главное. Лучше короткие ясные блоки, чем одно предложение на пять строк. Если какая-то деталь принципиальна — вынесите её вперёд и назовите прямо, а не прячьте в конце перечисления.
И главное про ожидания: генерация — это диалог, а не выстрел. Нормальный рабочий ритм — сделать первый кадр, посмотреть, что модель поняла не так, и уточнить одну-две детали. Менять всё сразу бессмысленно: вы не поймёте, что именно сработало. Меняйте по одному параметру — и быстро нащупаете нужное. Это кажется медленным, но на деле выходит быстрее, чем раз за разом отправлять одно и то же размытое «сделай красиво» и надеяться на удачу.
Границы: чьё это изображение и что нельзя рисовать
С картинкой приходит и ответственность, и её часто упускают. Начнём с прав. По российскому закону автором результата признаётся гражданин, творческим трудом которого он создан — то есть человек, а не программа. Из этого следует простая вещь: «голый» вывод нейросети по короткому запросу в строгом смысле сложно назвать охраняемым произведением. Чем больше вашего творческого вклада в процесс (сложный замысел, доработка, отбор, собственные исходники), тем крепче ваша позиция, если дойдёт до спора о правах.
Дальше — что генерировать не стоит. Узнаваемые лица реальных людей без их согласия (особенно в сомнительном контексте), чужие товарные знаки и логотипы, защищённых персонажей чужих франшиз — всё это способно обернуться претензией, кто бы ни «нарисовал», вы или модель. Инструмент новый, а правила об изображении человека, брендах и чужих персонажах — старые и продолжают действовать.
И про маркировку. Мир движется к тому, чтобы ИИ-картинки были опознаваемы. Крупные сервисы встраивают пометки прямо в файл: Google прячет в саму картинку невидимый водяной знак SynthID, который переживает кадрирование и сжатие, а открытый стандарт Content Credentials (C2PA) добавляет к изображению подписанные метаданные о происхождении — чем создано и что с ним потом делали. Удалить такую метку можно, но честнее держать в голове: по умолчанию происхождение картинки всё чаще считывается автоматически.
Как это выглядит в Schai GPT
В Schai GPT отдельного «редактора промптов» осваивать не нужно: вы просто пишете в чат «нарисуй …» или «сгенерируй картинку …» и описываете, что хотите. ИИ понимает это как команду на генерацию, рисует изображение и показывает его прямо в переписке; готовый кадр сохраняется, так что его можно переслать или использовать дальше. По сути всё, что я описал выше про слои запроса, — это и есть то, что стоит уместить в одну фразу после «нарисуй».
Пара честных деталей, чтобы не было сюрпризов. Генерация картинок — платная возможность: она доступна на тарифе, а расход считается по факту работы модели и списывается только за удачный результат, не за неудачные попытки. По умолчанию работает одна модель, а на платном тарифе можно переключиться на более сильные. Через быструю команду в чате вы задаёте только само описание — если нужно выбрать размер и соотношение сторон, приложить своё фото для правки или собрать кадр по референсу, это делается в отдельном окне генератора, а не одной строкой в диалоге.
Коротко
Это рисование, а не поиск. Модель собирает новый кадр из шума по вашему описанию, а не достаёт готовое фото.
Разный результат на один запрос — норма. Каждая генерация стартует из нового случайного шума; детали в описании сужают разброс.
Руки, текст и мелочи плывут не случайно. У модели нет понимания анатомии и смысла букв — только статистика пикселей; лечится конкретикой и списком «чего быть не должно».
Хороший запрос = решения за модель: что в кадре, стиль, композиция, свет, чего быть не должно. И правьте по одной детали за раз.
Границы реальны: права на «голый» вывод ИИ шаткие, чужие лица и бренды генерировать рискованно, а происхождение картинки всё чаще маркируется автоматически.
В Schai GPT достаточно написать «нарисуй …» в чат: картинка появится прямо в переписке. Это платная функция; тонкие настройки — размер, правка, референс — живут в отдельном окне генератора.
Пока нет комментариев