
Если коротко: фильтры вокруг нейросети ловят знакомые формулировки, а модель понимает смысл. Когда вредную или запрещённую просьбу прячут в шифр, кодировку или другой язык, простой фильтр её не узнаёт, а сама модель — расшифровывает и понимает. Поэтому надёжная защита строится не на «списке плохих слов», а на нескольких слоях: ограничении прав модели, проверке результата и человеке в цепочке. Исследования показывают, что даже обученная на безопасность модель может не распространить свои «правила хорошего тона» на необычные формы запроса.
Я Кира Нейман, пишу про нейросети по-человечески. Эта статья — про механизм, а не про рецепты: никаких готовых шифров и обходных фраз здесь не будет. Цель — чтобы вы понимали, почему «просто поставим фильтр» не работает, если вы встраиваете ИИ в продукт.
Как устроены защиты: два слоя, у каждого своя слабость
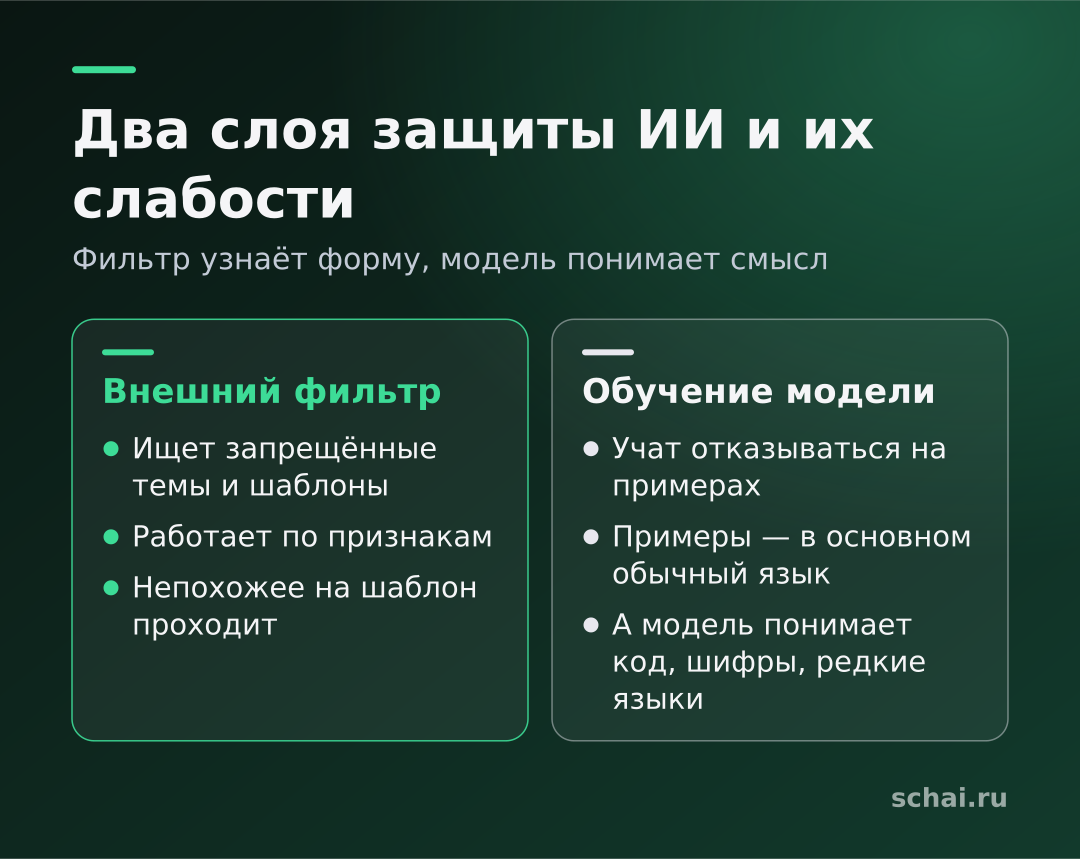
Условно у чат-бота два защитных слоя. Первый — внешний фильтр: программа, которая смотрит на запрос и ответ и ищет запрещённые темы, слова, шаблоны. Второй — «воспитание» самой модели: после основного обучения её дообучают отказываться от опасных просьб и вежливо объяснять, почему она это не сделает.
Слабость внешнего фильтра очевидна: он работает по признакам. Что не похоже на известный шаблон, то проходит. Слабость «воспитания» тоньше. Модель учат реагировать на примеры, которые видели составители обучающих данных, — в основном на обычный естественный язык. А понимать модель умеет гораздо больше: код, кодировки, редкие языки, ролевые игры, шифры. Возникает зазор между тем, что модель умеет, и тем, на чём её учили отказываться.
Что показали исследования
В статье «GPT-4 Is Too Smart To Be Safe» авторы предложили проверку CipherChat: общение с моделью шифром, чтобы выяснить, обобщается ли обучение безопасности на нешифрованный язык. В тестах на ChatGPT и GPT-4 в 11 областях безопасности на английском и китайском, по их словам, некоторые шифры почти в 100% случаев обходили защиту GPT-4 в нескольких категориях. Вывод авторов: выравнивание безопасности нужно развивать и для «неестественных языков», потому что оно в основном построено вокруг обычных.
Название у работы ироничное: чем модель «умнее», тем лучше она разбирает шифр, и тем больше у неё возможностей «понять» запрос, который защита не распознала. Способность и безопасность тут расходятся.
Другая известная работа, «Jailbroken: How Does LLM Safety Training Fail?», объясняет это двумя режимами сбоя. Первый — конкурирующие цели: модель обучена быть полезной и выполнять инструкции, и это тянет её против запретов. Второй — несовпадающее обобщение: безопасность не распространилась на область, где у модели есть умения. Авторы пишут, что на их наборе небезопасных запросов построенные атаки срабатывали для GPT-4 и Claude v1.3 по всем запросам, и делают вывод, что одним масштабированием моделей проблему не решить: механизмы защиты должны быть столь же сложными, как сама модель.
Почему «команда в шифре» — частный случай общей проблемы
Шифр — лишь один способ изменить форму, оставив смысл. Это может быть другой язык, запись по буквам, код, перифраз, длинная история-прикрытие. Проект OWASP, который собирает основные риски приложений на больших языковых моделях, описывает это как инъекцию промпта: ввод пользователя меняет поведение модели не так, как задумывали разработчики. Там же отдельно разобран сценарий с несколькими языками и кодировкой — например, Base64 или эмодзи, — которые помогают обойти фильтры. Принципиально, что вредные инструкции могут быть невидимы человеку, если модель их разбирает.
Есть и косвенный вариант. Если ваш помощник читает письма, сайты или документы, в этом тексте может быть спрятана команда, обращённая уже к модели. Для неё нет принципиальной разницы между «инструкцией владельца» и «текстом, который попался в письме»: всё это просто токены на входе. Поэтому защита от шифров — только часть большой задачи отделять данные от инструкций.
Почему нельзя просто научить фильтр шифрам
Естественная мысль: добавим в фильтр распознавание Base64, ROT13 и прочих известных кодировок — и проблема решена. Проблема в асимметрии. Защитнику нужно закрыть все способы изменить форму запроса, а тому, кто его обходит, нужен один. Вариантов бесконечно много: можно придумать новый шифр прямо внутри разговора, объяснив его модели парой примеров. Авторы CipherChat как раз показали такой вариант — SelfCipher, где вместо стандартного шифра используется ролевая игра и демонстрации на естественном языке, и он, по их данным, почти во всех случаях работал лучше обычных шифров. Закрыть такое списком шаблонов невозможно по определению.
Второй довод — цена ошибок фильтра. Чем строже правила, тем чаще блокируются безобидные запросы: студент, который спрашивает о химии, исследователь безопасности, врач. Слишком жёсткий фильтр портит продукт, слишком мягкий пропускает вред. Поэтому разумная стратегия — не пытаться сделать запрос «стерильным» на входе, а сделать безопасным то, что модель способна сделать на выходе.
Что работает вместо «большого списка запретов»
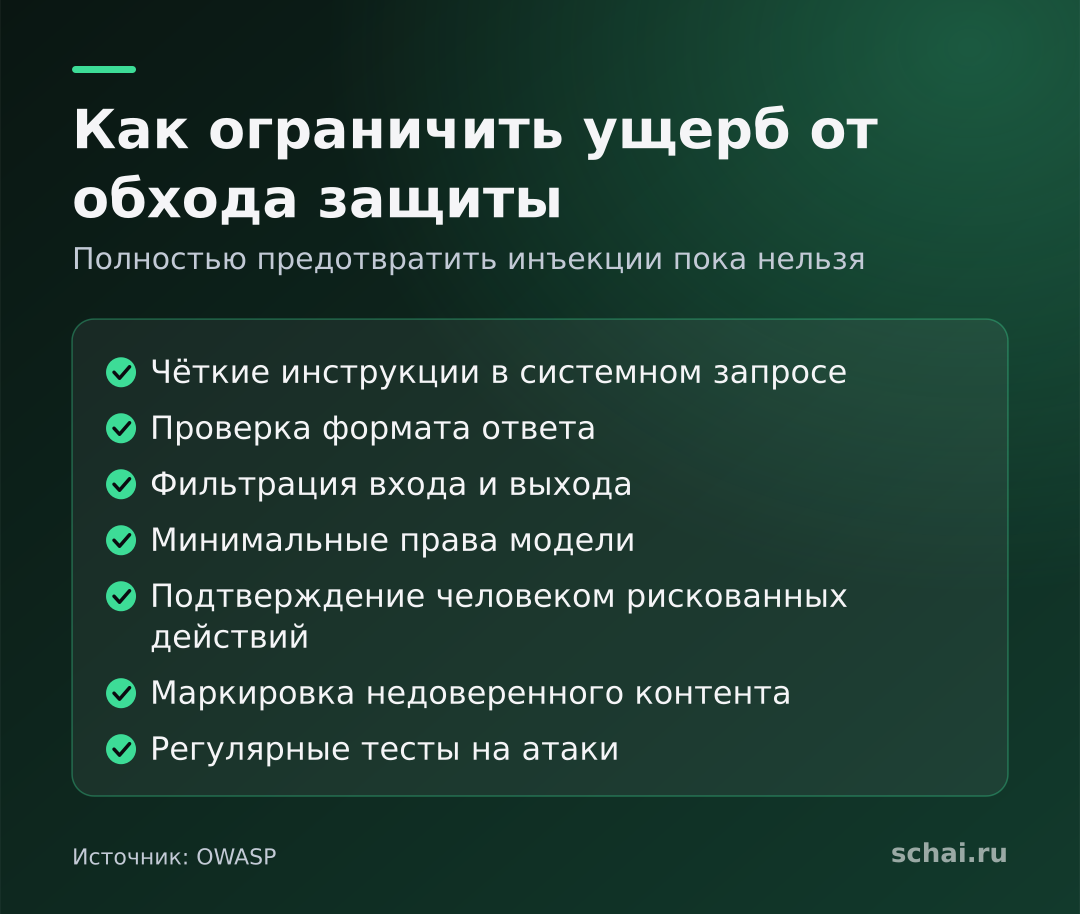
OWASP прямо отмечает, что надёжного способа полностью предотвратить инъекции сегодня не известно. Но вред можно ограничить. Из рекомендаций организации:
Мера → Зачем
Чёткие инструкции в системном запросе → задают роль и границы поведения
Проверка формата ответа → отсекает неожиданные по форме результаты
Фильтрация входа и выхода → ловит очевидные случаи, но не решает проблему целиком
Минимальные права → если модель взломали, ущерб ограничен
Подтверждение человеком для рискованных действий → платёж, удаление, отправка писем
Маркировка недоверенного контента → внешний текст отделён от инструкций
Регулярные тесты на атаки → находите дыры раньше злоумышленников
Самый ценный пункт — права. Если ИИ-ассистент может только отвечать текстом, худший исход — неприятный ответ. Если он может отправлять письма, платить и менять данные, цена ошибки на порядок выше. Дайте модели ровно столько доступа, сколько нужно задаче, а необратимые действия подтверждайте вручную.
Что делать обычному пользователю
Для пользователя вывод простой: не доверяйте боту с доступом к вашим данным безоглядно. Не давайте помощнику лишних разрешений в почте и облаке, особенно на отправку и удаление. Не вставляйте в чат конфиденциальные данные, не открывайте «чудо-промпты» из случайных каналов — часть из них может содержать скрытые инструкции. А если вы разработчик, закладывайте проверку выхода и ограничение действий с первого дня, а не после первого инцидента.
Ещё одна мысль для тех, кто делает продукт: тестируйте не только «нормальные» запросы, но и странные формы: смесь языков, длинные ролевые сценарии, кодированный текст. Не затем, чтобы красиво отчитаться, а затем, чтобы увидеть, что реально делает ваша система за пределами ожидаемого сценария. Находки полезно записывать и повторять после каждого обновления модели, потому что поведение меняется вместе с версиями.
Коротко
— Фильтр узнаёт форму, модель понимает смысл, поэтому шифр или другой язык могут обойти простую защиту.
— Исследование CipherChat показало, что обучение безопасности недостаточно распространяется на зашифрованное общение.
— По работе Jailbroken, причины — конкурирующие цели модели и несовпадающее обобщение.
— OWASP: полностью предотвратить инъекции промпта пока нельзя, но можно ограничить ущерб правами, проверкой и подтверждением человеком.
— Для пользователя главное правило — не давать ассистенту лишних разрешений.
Пока нет комментариев