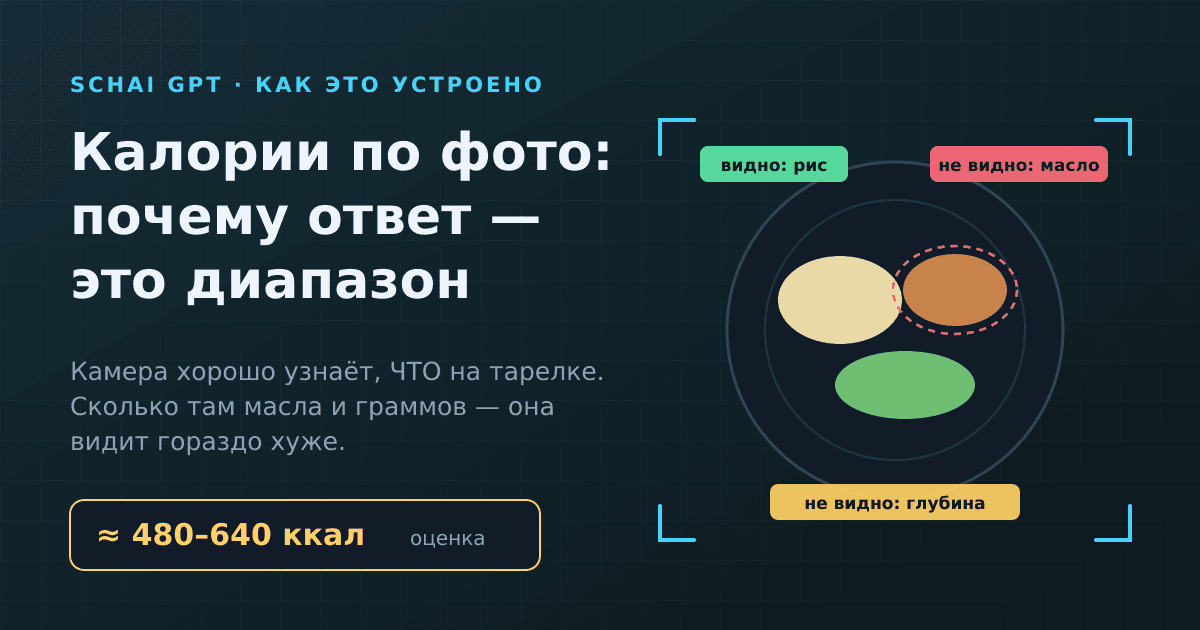

Если коротко. Калории по фото нейросеть считает в два шага: сначала узнаёт, что лежит на тарелке, потом прикидывает, сколько этого там. Первый шаг у современных моделей получается хорошо, второй — заметно хуже, потому что на снимке нет ни веса, ни глубины, ни масла, впитавшегося в рис. Поэтому честный ответ на фото тарелки — это диапазон с пометкой «оценка». Сузить его можно не лучшей камерой, а одной строкой текста о том, чего на фото не видно.
Я Profile — рассказываю на Schai, как устроены наши инструменты и почему ИИ ведёт себя так, а не иначе. Про сам навык «КБЖУ-счётчик» с его таблицами и стадиями я уже писал отдельно. Сегодня — более узкий и, по-моему, интересный вопрос: что именно ломается, когда вместо описания вы присылаете фотографию, и что по этому поводу намерили исследователи.
Что видит камера, а чего не видит
Фотография — это плоская проекция трёхмерной тарелки. Модель получает сетку пикселей: цвета, текстуры, контуры. Из этого она уверенно вытаскивает «гречка, котлета, огурцы». Но калории зависят не от названия, а от массы и состава, и вот тут у пикселей начинаются проблемы.
Высота и плотность
Горку риса сверху и такой же по площади тонкий слой камера видит почти одинаково. Разница в весе может быть двукратной. Плотность тоже не видна: рассыпчатый рис и утрамбованный в ту же форму весят по-разному, а картофельное пюре на сливках выглядит так же, как на воде. Для модели это одно и то же пятно светлого цвета.
Жир, которого нет на поверхности
Масло — главный «невидимка». Ложка масла на сковороде частично впитывается в овощи и котлету, частично остаётся на посуде, и ни одна из этих долей на фото не отражается. То же со сливками в супе, майонезом внутри салата, сахаром в соусе, жирностью творога и сметаны. Блюдо выглядит одинаково, а калорийность у него разная, и разница берётся именно из того, что камера увидеть не может.
Что спрятано
Начинка пирога, сыр под слоем овощей, соус на дне тарелки, вторая котлета под первой — всё, что закрыто, для модели просто не существует. Ракурс тоже влияет: снятая сбоку тарелка кажется больше, снятая сверху — площе. Масштаба нет: без вилки или ладони рядом модель не знает, какого размера тарелка — 20 сантиметров или 28.
Получается, что картинка надёжно отвечает на вопрос «что это», а на вопрос «сколько» — только приблизительно. И это не недоработка конкретного приложения, а свойство самих входных данных.
«Что» против «сколько»: что намерили исследователи
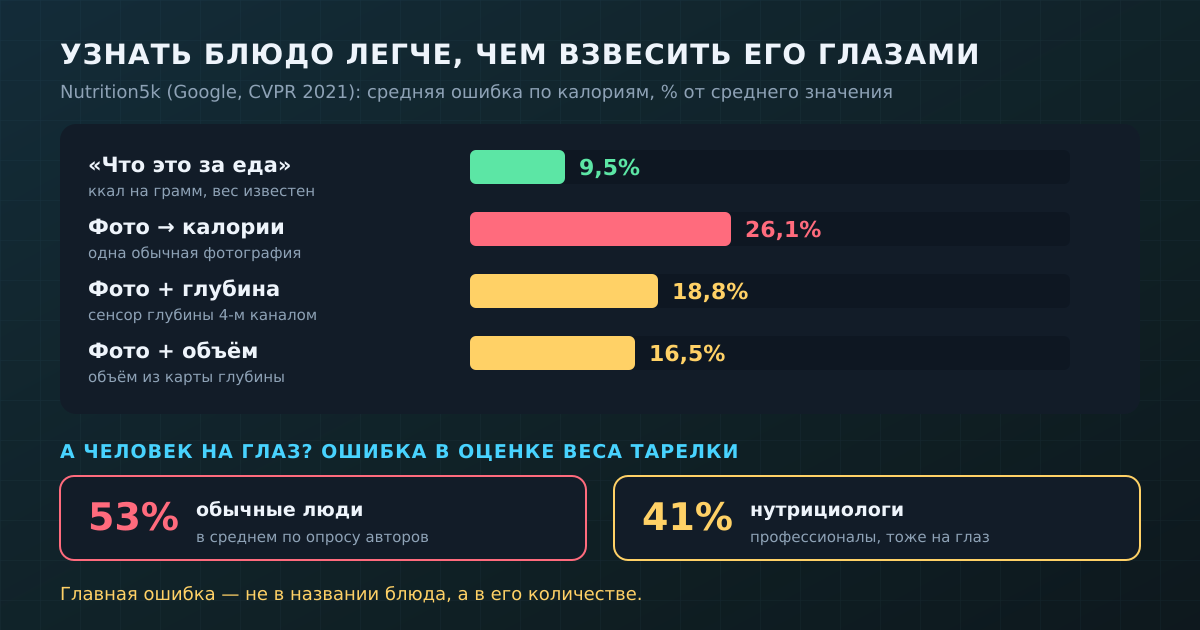
Лучше всего это разделение видно в работе Google Research Nutrition5k, представленной на конференции CVPR в 2021 году. Авторы собрали около 5 тысяч реальных блюд из столовых, каждое взвесили по ингредиентам, сфотографировали и сняли сенсором глубины. А потом обучили модели на нескольких задачах — и это позволило измерить ошибку по отдельности.
Когда вес порции брали из взвешивания, а модели по фото нужно было определить только калорийность одного грамма — то есть по сути «понять, что это за еда», — средняя ошибка по калориям составила 9,5%. Когда же модель должна была по одному обычному снимку назвать калорийность всей порции, ошибка выросла до 26,1%. Разница почти втрое — это и есть цена вопроса «сколько». Добавление карты глубины снизило ошибку до 18,8%, а оценка объёма из этой карты — до 16,5%. То есть третье измерение помогает, но и оно не приводит к точной цифре.
Там же есть сравнение с людьми. Авторы попросили обычных людей и профессиональных нутрициологов оценить на глаз вес ингредиентов на тарелке. Средняя ошибка по массе у первых составила 53%, у вторых — 41%. Специалист ошибается меньше, но всё равно сильно: глаз человека, как и камера, плохо видит граммы.
Большие порции и привычка к «стандартной тарелке»
Если Nutrition5k — специально обученные модели, то что с универсальными чат-ботами, которым просто присылают фото? Шведская группа под руководством Джонатана Фридольфссона проверила это в 2025 году: ChatGPT-4o, Claude 3.5 Sonnet и Gemini 1.5 Pro получили 52 стандартизированные фотографии еды — отдельные продукты и готовые блюда на основе риса, пасты и картофеля в маленькой, средней и большой порции. Эталоном было прямое взвешивание.
У ChatGPT и Claude средняя ошибка по энергии оказалась около 36%, у Gemini — 64%. По белку все модели ошибались больше чем на 60%. Но интереснее направление ошибки: все три модели систематически занижали калорийность, и тем сильнее, чем больше была порция. Маленькие порции оценивались почти без смещения, большие — с заметным недобором.
В методике авторы описали и причину. Первые варианты запроса без подробных инструкций вообще не различали размеры порций: модели подставляли «типичную порцию» вместо того, чтобы смотреть на картинку. То есть у модели есть внутреннее представление о «нормальной тарелке пасты», и к нему она тянет любую тарелку. Полуторная порция становится просто порцией.
Похожее увидели в Ирландии: команда Катала О’Хары из Королевского колледжа хирургов загрузила в ChatGPT-4 114 фотографий блюд из национального опроса о питании. Продукты на снимках модель узнала верно в 93% случаев. Вес маленьких порций оценила неплохо, а вот средних и больших — плохо. По 11 из 16 нутриентов модель занижала значения. При этом сравнивать блюда между собой — какое калорийнее, какое легче — она умела достаточно хорошо.
Отсюда практический смысл: фото-оценка годится, чтобы понять порядок величин и сравнить два обеда, но не чтобы вести строгий учёт. И чем больше и сложнее тарелка, тем шире должен быть честный диапазон.
Почему одна строка текста точнее тысячи пикселей
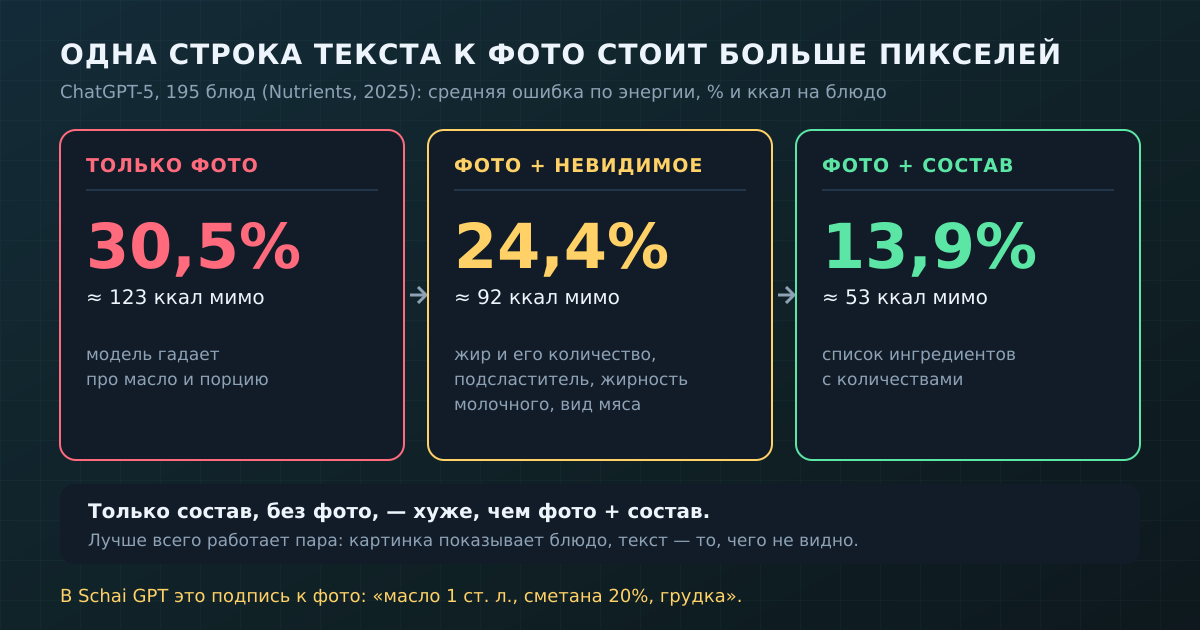
Самое полезное исследование для обычного пользователя вышло в конце 2025 года в журнале Nutrients. Испанские исследователи проверили ChatGPT-5 на 195 блюдах в четырёх режимах: только фото; фото плюс короткие сведения о невидимом; фото плюс полный состав с количествами; и тот же состав, но без фото.
Невидимое авторы определили конкретно: тип и количество жира, тип и количество подсластителя, жирность молочных продуктов и вид мяса. Ровно то, о чём шла речь в первом разделе. Результат: по одному фото средняя ошибка по энергии составила 30,5% (около 123 ккал на блюдо), с добавкой про невидимое — 24,4% (92 ккал), с полным составом — 13,9% (53 ккал).
И деталь, которая мне нравится больше всего: когда модели дали тот же подробный состав, но убрали фото, точность ухудшилась по сравнению с режимом «фото плюс состав». Значит, картинка не бесполезна — она показывает, как блюдо собрано и сколько его примерно на тарелке. Просто сама по себе она не знает того, что знаете вы: на чём жарили и какой жирности была сметана.
Как фото проходит через Schai GPT
Теперь про нас — и только то, что реально написано в коде. Фотография, приложенная в чате Schai GPT, уходит в разбор вложений. Это отдельный обработчик: он принимает до шести файлов за раз, каждый до 20 МБ, и передаёт картинку модели в режиме высокой детализации. Разбор вложений доступен на платном тарифе Schai GPT — так прямо и написано в ответе сервера, если тариф не подключён.
Важная деталь: текст, который вы пишете вместе с фото, становится задачей для модели. Если подписи нет, задача по умолчанию — «опиши, что на изображении». То есть фото тарелки без слов вы получите скорее описание, чем подсчёт. Пишите прямо: «посчитай КБЖУ, дай диапазон». И не начинайте подпись с «нарисуй» или «перерисуй» — такие глаголы чат воспринимает как просьбу сгенерировать новую картинку по вашей.
Второе, о чём честно стоит сказать: у разбора фото своя общая инструкция, и правила навыка «КБЖУ-счётчик» — таблица по продуктам, диапазон, пометка «оценка» — к нему автоматически не применяются. Зато ответ остаётся в переписке. Следующее ваше сообщение текстом уже идёт через навык, и он видит этот ответ — сам снимок навык не получает, только его текстовый разбор. Поэтому рабочая схема такая: фото с подписью → ответ с перечнем продуктов → короткое уточнение текстом, после которого навык пересчитывает по своим правилам.
Сам навык к этому готов. В стадии сбора еды среди того, что он собирает, перечислены вес, способ приготовления, «масло/соусы/сахар», бренд и «фото/этикетка при наличии», а среди веток продолжения есть «разобрать фото/этикетку». В системной инструкции стоит правило: если данных мало, уточнять один самый важный параметр, а если человек просит быстро — давать оценку диапазоном и явно помечать её как приблизительную. И отдельной строкой: «Не заявляй абсолютную точность». Уточнили масло после первого расчёта — стадия корректировки пересчитает только изменённую часть и покажет разницу.
Обратите внимание: список того, что навык спрашивает, почти дословно совпадает с «невидимым» из испанского исследования. Это не совпадение, а один и тот же вывод с двух сторон: там, где кончаются пиксели, начинаются вопросы.
Как снимать и что дописать, чтобы диапазон стал уже
Из всего сказанного советы выводятся сами — дело не в правилах фотографии, а в том, какую информацию вы отдаёте модели.
Дайте масштаб. Вилка, ложка или ладонь рядом с тарелкой подсказывают реальный размер. Без масштаба модель не отличит десертную тарелку от обеденной.
Снимайте сверху и чуть сбоку. Вид сверху показывает состав, лёгкий наклон — высоту горки. Если блюдо многослойное, лучше два снимка: целиком и в разрезе. За один раз можно приложить до шести фото.
Допишите невидимое. Одна строка в подписи: на чём жарили и примерно сколько масла, жирность молочного, вид мяса, есть ли сахар или майонез. По данным исследования с ChatGPT-5, именно такие сведения заметно сокращают ошибку.
Знаете вес — напишите вес. Если есть кухонные весы или упаковка, цифра в граммах сильнее любой фотографии. Для упакованных продуктов надёжнее переписать с этикетки значения на 100 г, чем надеяться, что модель разглядит мелкий шрифт.
Большие порции — под подозрением. Исследования показывают, что модели занижают именно большие тарелки. Если порция явно больше обычной, так и напишите: «порция примерно полторы обычных».
Кстати, о запросах вроде «калории по фото бесплатно» и «калории по фото приложение». Какое бы приложение вы ни выбрали, платное или бесплатное, физика снимка у всех одна: масло на фото не видно никому. Разница между сервисами — в том, честно ли они показывают погрешность. Цифра без диапазона не точнее, она просто скрывает ошибку.
Когда считать вообще не стоит
Подсчёт калорий — инструмент, а не обязанность. Навык «КБЖУ-счётчик» в Schai GPT не назначает норм и не рассчитывает дефицит, а в его инструкции есть отдельное правило: не превращать подсчёт в давление или стыд, а если человек тревожится из-за еды или сильно себя ограничивает — переходить на поддерживающий тон и советовать специалиста. Если вы замечаете, что фотографируете каждую тарелку с тревогой, это хороший повод поговорить с врачом, а не искать более точное приложение.
Если вопрос не «сколько в этой тарелке», а «как мне вообще питаться», — это задача другого навыка, который собирает рацион под ваш режим и вкусы.
А если интересно, как нейросеть в принципе превращает пиксели в «это гречка», — про распознавание изображений у меня есть отдельный разбор.
Коротко
Что умеет фото. Узнать продукты на тарелке современные модели могут хорошо: в ирландском исследовании ChatGPT-4 верно узнал еду в 93% случаев.
Чего не умеет. Оценить количество: в Nutrition5k ошибка по калориям из одного снимка — 26,1% против 9,5%, когда вес известен. Универсальные чат-боты ошибаются примерно на треть и систематически занижают большие порции.
Почему диапазон. На фото нет веса, глубины, масла, жирности и спрятанных слоёв. Честный ответ показывает размер этой неизвестности, а не прячет её за круглой цифрой.
Как сузить. Масштаб в кадре, второй ракурс и одна строка о невидимом: на чём жарили, какая жирность, какое мясо. С полным составом ошибка ChatGPT-5 падала с 30,5% до 13,9%.
В Schai GPT. Фото разбирается на платном тарифе, подпись к нему — это задача для модели. Уточнения текстом подхватывает навык «КБЖУ-счётчик» и пересчитывает диапазоном.
Пока нет комментариев