Как распознать дипфейк: почему подделку выдают мелочи, а не моргание

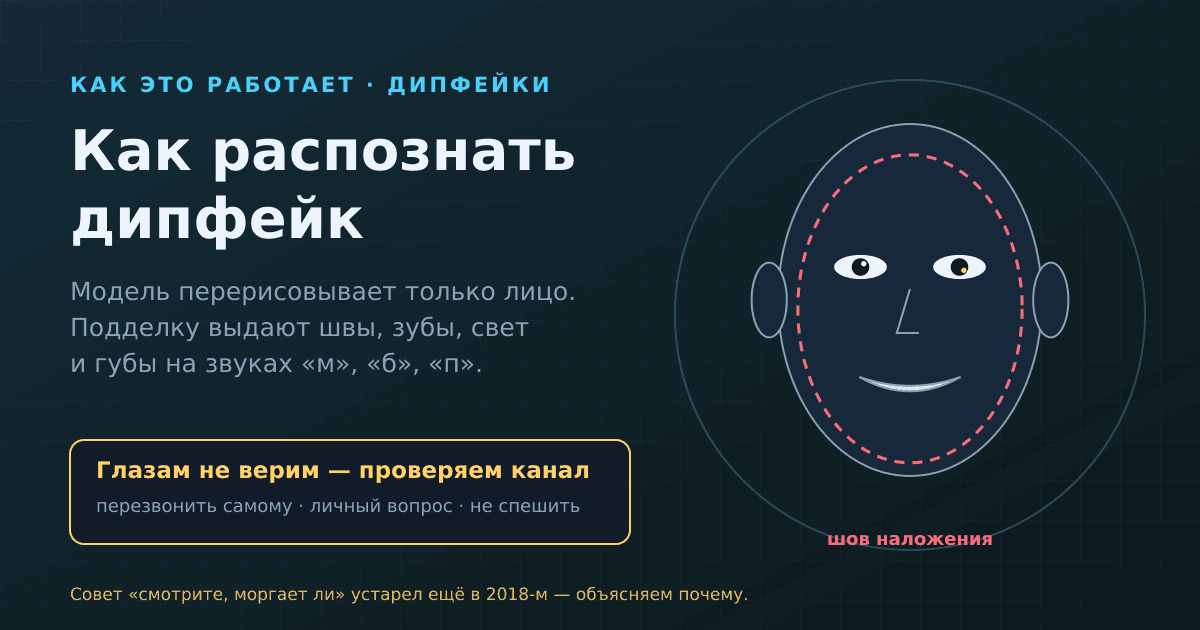
Если коротко: дипфейк — это видео, фото или голос, в которых нейросеть подменила человека: вклеила чужое лицо, заставила губы произносить другие слова или синтезировала знакомый голос. Распознать его «на глаз» всё труднее, но выдают подделку не случайные глюки, а закономерные мелочи — там, где работа модели стыкуется с настоящим кадром или где ей не хватило примеров: граница лица, свет, зубы, уши, губы на звуках «м», «б», «п». Совет «смотрите, моргает ли человек» устарел. А против мошеннических звонков работает не зоркость, а процедура: положить трубку и перезвонить самому.
Это канал «Всё про ИИ и Роботов». Мы уже разбирали, как отличить машинный контент от живого в целом, — сегодня узкий и самый неприятный случай: подделка конкретного человека. Разберём, как она устроена изнутри, потому что из устройства сами собой следуют и признаки, и их пределы.
Дипфейк — это что такое простыми словами
Слово склеено из deep learning (глубокое обучение) и fake (подделка). Под ним сегодня понимают несколько разных вещей, и полезно их различать — у каждой свои слабые места:
• Замена лица (face swap): в настоящем видео лицо одного человека заменяют лицом другого. Тело, комната, свет — настоящие.
• Подмена губ (lip-sync): лицо родное, но рот перерисован под новую звуковую дорожку — человек «говорит» то, чего не говорил.
• Полная генерация: весь кадр, включая человека, нарисован моделью с нуля.
• Голосовой клон: синтез речи тембром конкретного человека — по телефону, в голосовом сообщении, в озвучке видео.
Мошенникам чаще всего нужны первые два и четвёртый вариант: они дешевле и позволяют «оживить» реального знакомого жертвы. Банк России описывает именно такую схему: материалы берут из взломанных аккаунтов — фото, видео, записи голоса — и рассылают друзьям и родственникам ролик с просьбой срочно помочь деньгами.
Как нейросеть подменяет лицо: три поколения технологии
Автоэнкодер: сжать и разжать
Первые массовые дипфейки, появившиеся в конце 2010-х, строились на автоэнкодерах. Идея простая. Сеть учится сжимать картинку лица в короткое описание — «куда смотрит, как открыт рот, как повёрнута голова» — и потом восстанавливать лицо обратно из этого описания. Хитрость в том, что «сжимающая» часть у двух людей общая, а «разжимающих» две, по одной на человека. Сжали кадр с человеком А — получили позу и мимику. Разжали «разжималкой» человека Б — получили лицо Б с мимикой А.
Важная деталь, которая объясняет почти все артефакты: модель видит и рисует только вырезанный прямоугольник с лицом. Потом этот фрагмент приходится вклеивать обратно в настоящий кадр — подгонять по цвету, размывать край. Всё остальное — волосы, шея, фон, освещение — остаётся от оригинала.
GAN: художник и критик
Генеративно-состязательные сети добавили к рисующей модели вторую — «критика», которая учится отличать сгенерированные картинки от настоящих. Художник старается обмануть критика, критик — не обмануться, и в этой гонке картинка становится чище. Именно GAN научились рисовать фотореалистичные лица несуществующих людей.
Диффузия: проявить из шума
Современные генераторы изображений и видео — диффузионные. Модель учится шаг за шагом убирать шум из картинки, а при генерации начинает с чистого шума и «проявляет» из него кадр, ориентируясь на подсказку — текст, фото-образец, позу. Такие модели лучше держат свет и текстуру кожи, и многие старые признаки подделки на них уже не работают.
Но одно у всех трёх поколений общее: модель воспроизводит то, что часто видела в обучающих данных, и плохо справляется с тем, что видела редко. А при подмене лица в настоящем видео добавляется вторая проблема — стык. Вот на этих двух слабостях и держится распознавание.
Почему подделку выдают мелочи
Шов на границе лица
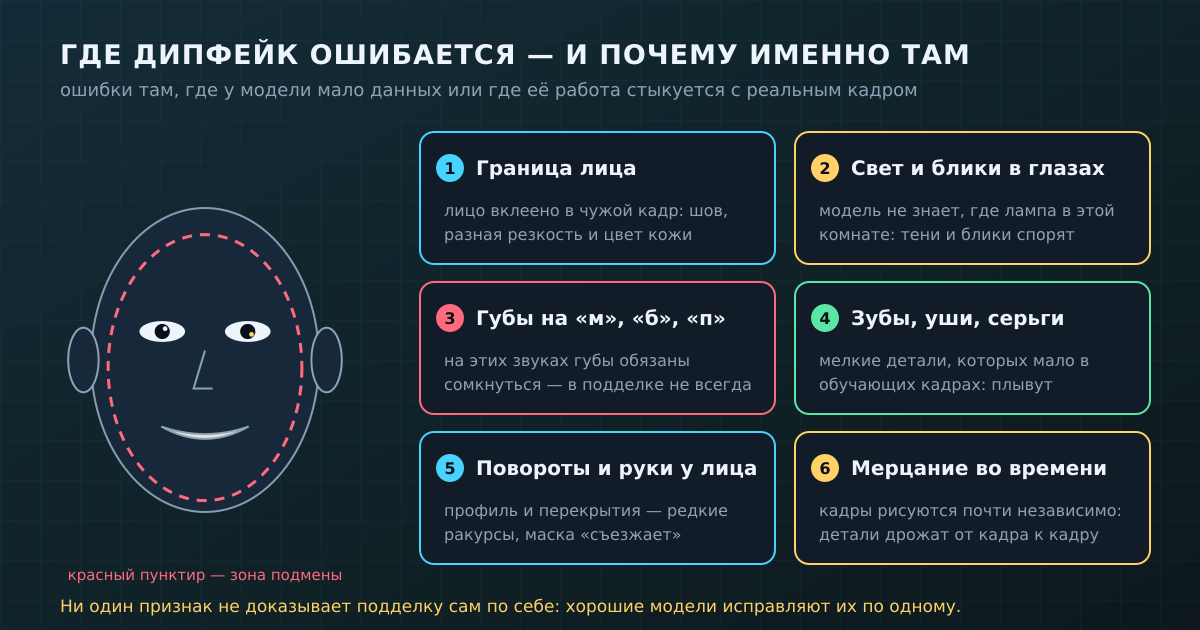
Раз модель рисует только лицо, а кадр вокруг — настоящий, их где-то нужно сшить. На этом стыке часто и прячется подделка: чуть разная резкость лица и шеи, другой оттенок кожи у линии волос, «плывущий» контур подбородка при повороте. Исследователи из Microsoft Research Asia построили на этом целый метод — Face X-ray (CVPR 2020). Его логика: почти все способы подмены лица проходят общий шаг — вклеивание изменённого лица в чужой фон, поэтому искать надо не следы конкретной нейросети, а саму границу наложения. Это работает и на подделках, сделанных незнакомыми детектору методами.
Свет, который не знает комнаты
Лицо в подделке собрано из кадров, снятых при другом освещении. Модель старается подогнать тон, но физику света в этой конкретной комнате она не знает. Отсюда тени, падающие не туда, куда падают тени от носа в соседнем кадре, и блики в двух глазах, которые не совпадают по форме и положению — в реальности оба глаза отражают одно и то же окно или лампу.
Зубы, уши, серьги, очки
Это зоны, где мало пикселей и много вариантов. В обучающем наборе лицо чаще всего видно спереди, рот закрыт или улыбается одинаково, уши прикрыты волосами. В итоге модель рисует такие детали «в среднем»: зубы сливаются в светлую полосу без отдельных промежутков, серьга в одном кадре есть, в другом нет, оправа очков на границе маски обрывается.
Повороты головы и руки у лица
Тот же закон редкости: в профиль и с рукой перед лицом людей фотографируют мало. Когда человек в видео резко поворачивает голову, трёт глаз или подносит телефон к щеке, маска может на мгновение «съехать», размыться или проступить сквозь пальцы.
Мерцание во времени
Видео — это десятки кадров в секунду, и модель далеко не всегда помнит, что нарисовала в прошлом кадре. Поэтому детали подрагивают: родинка чуть смещается, линия волос дышит, текстура кожи «кипит». На одном стоп-кадре всё безупречно, а при покадровом просмотре видно дрожание.
Губы на «м», «б», «п»: самый физичный признак
Из всех мелочей эта — самая наглядная. Чтобы произнести звуки «м», «б», «п», губы обязаны полностью сомкнуться: попробуйте сказать «мама» с приоткрытым ртом — не получится. Это не привычка, а физика артикуляции.
Шрути Агарвал и Хани Фарид с коллегами показали, что в подделках с перерисованным ртом это смыкание часто нарушается: звук «б» есть, а рот в этот момент приоткрыт. Форму рта на конкретном звуке лингвисты называют визема, звук — фонема, и метод так и называется — поиск несовпадений фонем и визем. Сила подхода в том, что он ловит даже маленькие правки: когда в настоящей речи заменено одно-два слова, а остальное видео подлинное.
Практический вывод для зрителя: если ролик вызывает сомнение, пересмотрите медленно фразы, где много «м», «б» и «п». Рот, который «проговаривает» эти звуки не смыкаясь, — серьёзный повод насторожиться.
Миф о моргании: почему этот совет устарел
В 2018 году исследователи из Университета Олбани опубликовали работу «In Ictu Oculi» — «в мгновение ока». Наблюдение было остроумным: в обучающих наборах почти нет фото с закрытыми глазами (неудачные кадры никто не публикует), поэтому лица в тогдашних дипфейках моргали заметно реже нормы. Авторы приводят среднюю частоту моргания в покое — около 17 раз в минуту — и предлагают ловить подделки по её отсутствию.
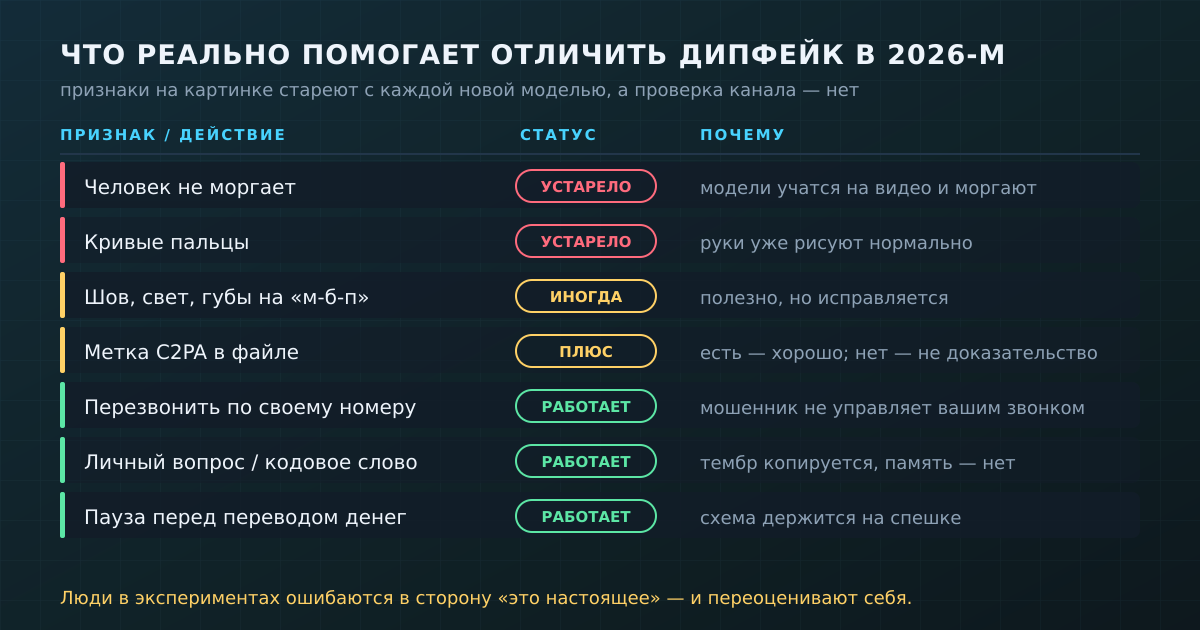
Совет быстро разошёлся по СМИ и памяткам и живёт там до сих пор. Но уже в той же статье авторы честно предупреждали: продвинутые подделыватели могут добавить реалистичное моргание постобработкой, более совершенными моделями и бо́льшим объёмом данных. Так и вышло: стоило добавить в обучение видео, а не только фото, — модели заморгали. Сегодня отсутствие моргания может что-то подсказать про старый или очень грубый фейк, а наличие моргания не доказывает ничего.
Это вообще главный урок про любые «признаки дипфейка»: как только признак становится известен, его исправляют. Так случилось с морганием, с кривыми пальцами на сгенерированных картинках, так рано или поздно будет со швом и губами. Детекторы и генераторы играют в бесконечную партию, и зритель с чек-листом всегда отстаёт на ход.
Почему люди почти не видят подделку — и не знают об этом
Можно было бы надеяться, что внимательный человек всё-таки заметит неладное. Эксперимент Нильса Кёбиса и коллег из Института Макса Планка, опубликованный в iScience в 2021 году, показывает, что нет. Участники (210 человек) не смогли надёжно отличать дипфейки от настоящих видео, причём ни предупреждение о подделках, ни денежное вознаграждение за точность их результат не улучшили.
Ещё интереснее две другие находки. Люди ошибались несимметрично: гораздо чаще принимали подделку за настоящее видео, чем наоборот, — работает правило «увидел — значит, было». И они переоценивали свои способности: были уверены, что отличают фейк, когда на деле не отличали. Отсюда название статьи: «Обмануты дважды».
С голосом картина похожая, мы подробно разбирали её в материале о том, как нейросети клонируют голос. Тембр, интонации, характерные словечки современная модель воспроизводит по короткой записи, а телефонная связь своим сжатием и шумом заодно маскирует остатки артефактов.
Звонок «от родственника» или «начальника»: что делать
Мошенническая схема держится не на качестве подделки, а на трёх вещах: знакомом лице или голосе, срочности и просьбе о деньгах или данных. Поэтому защита строится не вокруг вопроса «настоящее ли это видео», а вокруг вопроса «настоящий ли это канал связи».
Банк России в той же памятке называет признаки подделки — неестественная монотонная речь, дефекты звука и видео, несвойственная человеку мимика — но главная рекомендация не про них: прежде чем переводить деньги, обязательно позвоните тому, от чьего имени пришло сообщение, и перепроверьте. Если дозвониться нельзя — задайте личный вопрос, ответ на который знает только этот человек.
Почему это работает, понятно из механизма. Модель может скопировать лицо и тембр, потому что они есть в открытых записях. Но она не знает того, чего нет в данных: как вы называли кота в детстве, о чём договорились вчера на кухне. И мошенник не управляет звонком, который вы сделали сами на номер из своей записной книжки.
Короткий порядок действий:
• Положить трубку или закрыть чат, не обсуждая детали.
• Перезвонить человеку по номеру, который сохранён у вас, а не продиктован в разговоре или в сообщении.
• Если не дозвонились — написать или позвонить кому-то, кто рядом с ним.
• Заранее договориться в семье о проверочном слове или вопросе, ответа на который нет в соцсетях.
• В видеозвонке можно попросить человека повернуть голову в профиль или провести рукой перед лицом — это редкие для модели ракурсы. Но это лишь дополнительная проверка, а не доказательство: перезвонить всё равно надёжнее.
• Начальник просит срочно оплатить счёт или прислать данные «по секрету»? Проверить через официальный канал компании, а не через тот, по которому пришла просьба.
Метки происхождения: C2PA и Content Credentials
Есть и обратный подход: не ловить подделку, а подтверждать подлинность. Его развивает стандарт C2PA, на котором основана маркировка Content Credentials. Спецификация C2PA описывает «манифест» — набор сведений о том, кто и чем создал файл и как его редактировали, привязанный к содержимому криптографическими хешами и подписанный цифровой подписью. Фотоаппарат или телефон с поддержкой стандарта создаёт такой манифест в момент съёмки, редакторы и генераторы дописывают свои шаги.
Ограничение то же, что у любой метки: при скриншоте, перезаливке или пересылке через мессенджер метаданные легко теряются. Поэтому наличие подписи — хороший знак, а её отсутствие ничего не доказывает. Подробнее про то, чем такая метка отличается от водяного знака и почему её трудно снять, мы рассказывали в статье «Водяной знак сняли, метка осталась».
Коротко
• Дипфейк — подмена человека нейросетью: лица, губ, всего кадра или голоса.
• Модель рисует только лицо и вклеивает его в настоящий кадр, поэтому подделку выдают стыки: граница лица, свет, блики в глазах.
• Второй источник ошибок — редкость в обучающих данных: зубы, уши, профиль, руки у лица, мерцание деталей между кадрами.
• Самый физичный признак — губы на «м», «б», «п»: они обязаны сомкнуться.
• «Не моргает — значит фейк» — устаревший совет: авторы самого исследования 2018 года предупреждали, что моргание добавят.
• Люди плохо распознают дипфейки и при этом уверены в себе — поэтому полагаться на глаз нельзя.
• Против мошенничества работает процедура: перезвонить самому по своему номеру, задать личный вопрос, не спешить с переводом.
Пока нет комментариев