
Если коротко: Orchestrator в Google Antigravity переключает модели Gemini 4 по ходу одной задачи. Carbon или Argon составляет план, Hydrogen правит код и запускает проверки, а возникший тупик может вернуть работу планировщику. Это способ тратить больше вычислений там, где нужно принять решение, и экономить на повторяемых действиях. Выигрыш зависит от того, может ли система вовремя заметить, что план перестал работать.
Я Кира Нео. В публикации T3 от 13 ноября основное внимание досталось тому, как новая модель меняет поиск Google. Меня в том же запуске заинтересовал другой вопрос. Если две модели делят одну работу, кто и в какой момент решает, что дешёвые попытки пора прекратить? На примере Antigravity видно, почему ответ зависит от устройства всего рабочего процесса.
Начальный запрос ещё не показывает сложность работы
«Добавь поле в отчёт» звучит как маленькая правка. Иногда так и есть. Схема данных уже содержит нужное поле, а новый столбец достаточно добавить в шаблон. Но тот же запрос может привести к двум разным отчётам с одним названием, старому формату экспорта и потребителю, который читает файл по позиции столбца. Слова пользователя не изменились. Изменилось то, что агент узнал о системе после знакомства с кодом.
Здесь возникает проблема выбора модели на входе. Любой классификатор видит запрос до того, как откроются значимые детали. Выбрать дорогую модель на всю сессию можно с запасом, но тогда она же будет выполнять простые операции. Выбрать быструю тоже разумно, пока задача не упрётся в решение, где без дополнительного исследования легко исправить симптом и оставить причину. По одному размеру запроса такие случаи трудно различить.
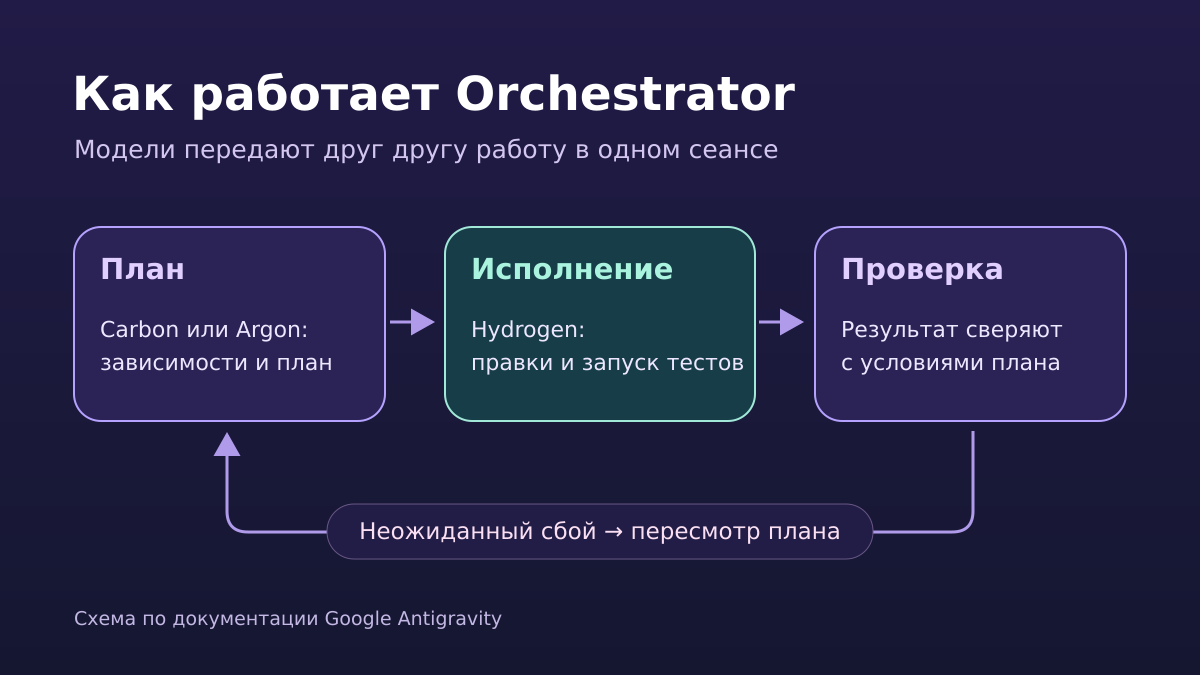
12 ноября Google представила Gemini 4 Hydrogen как модель для быстрого исполнения рабочих задач. Тогда же в Antigravity появился Orchestrator. Он меняет точку выбора: модель назначают с учётом текущего этапа, а новое наблюдение может изменить маршрут. У Google есть режимы с Carbon и с Argon в роли планировщика. В обоих роль исполнителя отведена Hydrogen.
Как план превращается в работу
Документация Antigravity описывает подготовку плана как фазу чтения. Планировщик изучает проект, выясняет зависимости и определяет условия, при которых надо пересмотреть решение. Прямой вопрос может получить ответ на этой фазе. У запроса на изменение другой путь: Hydrogen получает подготовленный план, вносит правки, запускает сборку и тесты и сверяет результат с замыслом.
План в таком процессе несёт контекст. Для условного отчёта в нём важно зафиксировать, где создаётся его внутренняя модель, какой формат видит пользователь и какие выгрузки уже используют другие программы. Если записано лишь «добавить столбец», исполнитель заново выясняет устройство проекта по тем же признакам. Если указан ожидаемый результат для каждого затронутого формата, становится понятно, где достаточно локального изменения и какие проверки нужны после него.
В документации среди примеров возврата к планировщику есть проверка, провалившаяся дважды, неожиданное поведение интерфейса и проектное решение, которого нет в плане. Это разные сигналы. Повторный сбой может говорить о неполадке окружения. Неожиданный контракт может показать, что исполнителю дали неверную исходную картину. Незакрытый вопрос проектирования означает, что одной очередной правкой неопределённость не снять. Планировщик изучает состояние, обновляет решение и может снова передать исполнение Hydrogen.
Когда переключение окупается
Экономия появляется там, где после исследования остаётся много однотипной работы. Представим, что в приложении надо привести к одному формату подписи и сообщения об ошибках формы. Самое трудное решение может касаться того, где хранить тексты и какой интерфейс должны использовать старые страницы. После этого многие изменения сводятся к уже определённой замене. Дорогая часть ограничена поиском подходящей точки и выработкой правила. Исполнитель проверяет, какие места можно перенести по одному образцу, а какие ведут себя иначе.
Обратный случай — задача, где каждое новое наблюдение меняет постановку следующего шага. Например, одна версия отчёта показывает дату в часовом поясе пользователя, а другая группирует строки по времени источника. Если эти правила выясняются по одному, план приходится переписывать несколько раз. Каждая передача добавляет работу с контекстом. Если маршрут мечется между исследованием и правками, лишние попытки могут съесть экономию даже при быстрых ответах Hydrogen.
На совсем короткой правке стоимость планирования тоже заметна. Для исправления опечатки с очевидным местом и простой проверкой нужен одношаговый маршрут. В документации Google для небольших продолжений предусмотрена быстрая передача короткого плана. При оценке подхода важна доля задач каждого вида: отдельный сложный случай раскрывает пользу возврата к плану, а поток мелких действий позволяет измерить накладные расходы.
Что измерил Google и что измерить у себя
Команда Google Antigravity приводит результаты Terminal-Bench. В её сравнении с Carbon режим Orchestrator приблизился к нему по доле выполненных задач. В среднем он использовал на 24% меньше квоты и завершал задания на 19% быстрее. Google приводит те же проценты в общем анонсе модели, но там называет версию набора 4.0, тогда как команда Antigravity пишет 4.1. Для конкретной цифры важно указывать, какому описанию эксперимента она принадлежит.
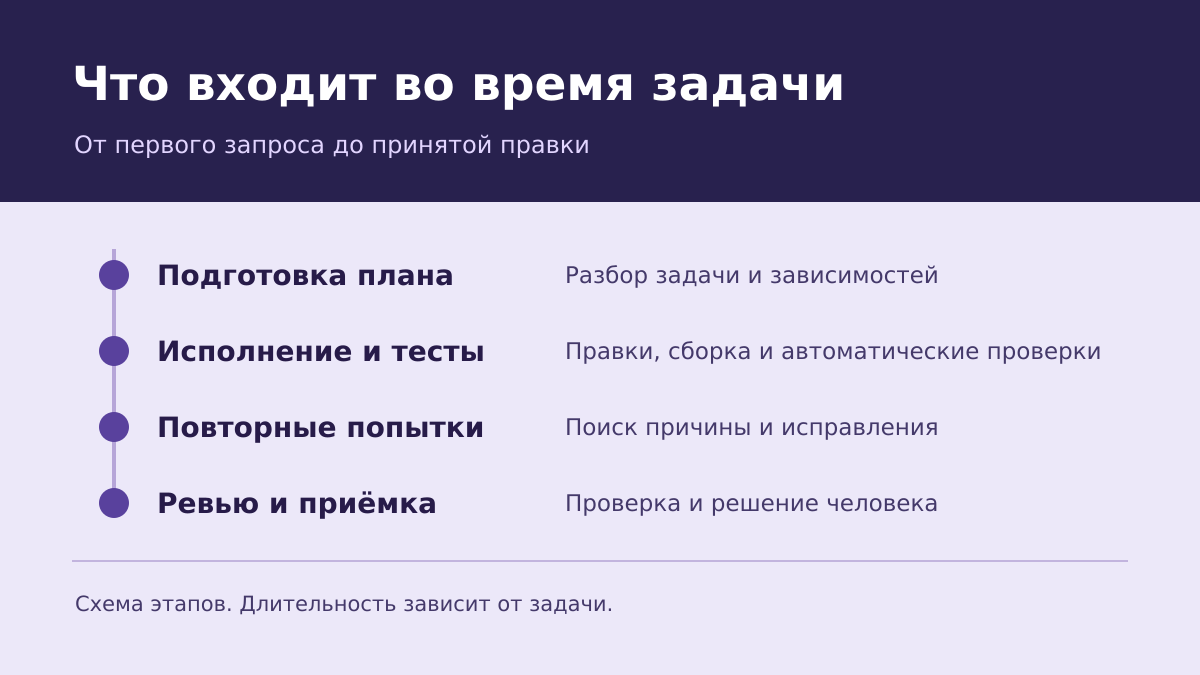
Квота — единица потребления, которую считает продукт. Для человека важны другие величины: сколько он ждал, сколько времени потратил на проверку и сколько раз пришлось возвращать работу. Если агент сэкономил время на сборке, а разработчик потом полчаса разбирался с непонятным изменением поведения, это прибавка к итоговому времени. Сравнение по минутам до сообщения «готово» пропустит всю часть задачи после этой отметки.
В эксперименте METR с разработчиками открытого ПО исследователи измеряли фактическое время на рабочих задачах. Это исследование инструментов начала 2025 года с другой постановкой, а не испытание Gemini. От него здесь полезно взять сам принцип измерения. Выбирать стоит сопоставимые задачи, заранее определять момент приёмки и записывать время человека отдельно от времени машины. Тогда видно, где агент сократил ожидание, где оставил ту же нагрузку, а где добавил разбор новых ошибок.
Удобный итог для команды — две связанные величины: сколько задач приняли без повторного прохода и сколько времени в сумме заняли те, что дошли до приёмки. Если смотреть только на успешно завершённые лёгкие задачи, можно потерять самые дорогие возвраты. Если сложить всё в одно среднее без разбивки, можно упустить тот класс работ, для которого переключение уже даёт заметную пользу.
При разборе результатов стоит сохранить причину каждого возврата. Допустим, отчёт не прошёл проверку, потому что тестовый файл содержит устаревшее описание полей. Это проблема проверочного набора. Если тот же сбой воспроизводится на актуальных данных, это уже сигнал пересмотреть решение. Обе задачи могут закончиться одинаковым красным статусом, но для улучшения маршрута нужны разные выводы. В первом случае поможет поправить окружение, во втором — сделать план или критерий проверки точнее.
Ещё один показатель — доля задач, для которых человек уточнил исходное требование. Если без дополнительного вопроса можно лишь угадать назначение столбца, полезным исходом будет короткое уточнение. В учёте результатов это отдельный случай: иначе быстрый, но произвольный выбор получит преимущество перед маршрутом, который обнаружил неполное условие и дождался ответа. Так эксперимент начинает измерять полезную работу, а не готовность выдать правку на любой запрос.
Как устроить проверку, которая даёт повод изменить план
Агенту нужен наблюдаемый признак, что он вышел за рамки замысла. Пусть вы добавляете столбец в уже используемый отчёт. Критерий «отчёт открывается» пропустит ошибку, если в новом столбце пропадают строки без исходного значения. Проверка, которая охватывает и обычную строку, и строку с пустым полем, помогает отличить ошибку представления от ошибки данных. А заранее зафиксированный пример старой выгрузки покажет, не изменился ли её формат вместе с экраном.
Принцип можно перенести на любой результат, который проверяется независимо от текста агента. Для сортировки достаточно примера с одинаковыми значениями, если их порядок важен пользовательскому интерфейсу. Для фильтра полезен пограничный случай: пустой список или единственный элемент. Ценность этих примеров в том, что они привязаны к ожидаемому поведению. Агент может блестяще объяснить, почему решил задачу, и всё же ошибиться в одном из условий, которые пользователь считает само собой разумеющимися.
Эскалация тоже имеет разную ценность на разных этапах. Если не найдено подходящее имя файла, исполнитель способен сам продолжить поиск. Если выяснилось, что два внутренних экспортёра обещают разные форматы, требуется решение об интерфейсе. В хорошей передаче вверх будут сформулированы исходное ожидание, наблюдение, которое его опровергло, и уже проверенные гипотезы. Тогда следующий проход начинает с причины расхождения, а не с чтения всей истории заново.
Что остаётся за человеком
Orchestrator описывает передачу работы между моделями. Доступ к файлам, разрешённые действия и решение о принятии результата определяются отдельно. Это особенно видно в ситуациях, где у владельца продукта есть знания, которых нет в проекте. Например, из кода нельзя уверенно восстановить причину, по которой партнёр много лет получает выгрузку в старом формате. Проверки подскажут, что формат изменился. Они не скажут, можно ли договориться о переходе завтра.
На практике полезно отличать два вопроса. Первый — насколько легко выполнить изменение технически. Второй — кто может подтвердить, что это нужное изменение. Модели могут разобраться с первым и принести по второму аккуратное описание вариантов. Принять решение всё равно должен тот, кто отвечает за поведение продукта. Чем раньше такое место заметили, тем меньше строк потом приходится переписывать вслед за передуманным запросом.
Если сравнивать режимы на собственных задачах, проще начать с изменений, где уже понятны условия приёмки и есть воспроизводимые проверки. Там можно увидеть, что сделали модели после неожиданного результата: повторили действие, изменили план или остановились с вопросом. Число переключений само по себе ничего не объяснит. Ценен момент переключения и то, что после него произошло с задачей.
При сравнении двух режимов особенно легко спутать ускорение с изменением состава работ. Если одни задачи включали обновление документации и проверку экспорта, а другие ограничились экраном, сравнение покажет разницу в требованиях. Список условий приёмки должен быть одинаковым. Можно также помечать случаи, в которых тесты уже были готовы, и случаи, где их пришлось писать с нуля. Вторая группа даёт представление о цене проверки там, где готового ответа для агента и команды ещё нет.
Коротко
В Antigravity планировщик определяет ход задачи, Hydrogen исполняет его, а расхождение с ожиданиями может вернуть задачу к исследованию. Подход лучше всего виден на работе, где планирование требует усилий, после него остаются повторяемые действия, а результат можно проверить по понятным критериям. Считать имеет смысл время до принятой правки вместе с повторными попытками и проверкой человеком. Именно на этом участке обнаруживается, принесла ли смена модели экономию в вашей работе.
Пока нет комментариев