
Если коротко: ИИ ошибается в спорных категориях не только потому, что плохо распознаёт картинки. Иногда заказчик сам ещё не решил, что именно считать подходящим. Ноябрьская публикация Google об Agile Deliberation даёт повод разобрать этот конфликт: модель может помочь обнаружить неоднозначность, но право устанавливать правила и отвечать за последствия остаётся у людей.
Я Кира Нео, рассказываю о нейросетях по-человечески. Меня здесь интересует не соревнование моделей, а неудобный вопрос: если алгоритм точно выполняет туманное пожелание, кто заметит, что пожелание было неправильным? Разбираемся на собственном примере редакции, которая собирает фотоподборку о городской жизни. Это условный сценарий, а не описание клиентов Google или результатов исследования. Он позволяет увидеть, где заканчивается распознавание и начинается человеческое решение.
Что произошло и почему даты важны
4 ноября 2026 года Google Research опубликовал объяснение Agile Deliberation: подхода к уточнению субъективных категорий для классификации изображений. Пользователь задаёт границы понятия, система показывает пограничные примеры, а обратная связь помогает корректировать инструкцию. Это исследовательская работа, а не объявление универсального модератора, который самостоятельно определит, что хорошо и что плохо.
У этой новости два календаря. В карточке научной работы на arXiv первая версия датирована 11 декабря 2025 года, обновление — 4 апреля 2026 года. Поэтому называть метод изобретением сегодняшнего дня неправильно. Свежий повод — ноябрьское объяснение исследователей. Оценка проводилась в 18 пользовательских сессиях продолжительностью полтора часа; такой масштаб нельзя автоматически переносить на работу любой платформы.
Для читателя это полезное различие. Дата заметки показывает, когда о результате снова заговорили, а дата исследования — когда появился сам материал. Между ними могут измениться модели, инструменты и ожидания рынка. Из публикации нельзя вывести, что метод уже внедрён во всех продуктах компании, что он заменил живых модераторов или что его преимущества гарантированы на русскоязычных данных. Таких выводов мы здесь не делаем.
Мой аналитический интерес другой: возможность проверить само техническое задание до массовой обработки. В обычном разговоре достаточно согласиться, что нужны хорошие фотографии. Для автоматизации этого мало. Если разногласие скрыто за общим словом, увеличение скорости обработки лишь быстрее разнесёт его по всей коллекции. Новая модель способна улучшить исполнение, но не отменяет необходимость договориться о смысле.
«Подходит» — ещё не правило
Представим редакцию, которой нужны фотографии уютного города. Один редактор выбирает тихие дворы без людей. Другой считает уютом оживлённый рынок. Третий исключает любые изображения с автомобилями. Все трое добросовестно ставят метки, но обучающие примеры отражают разные задачи. Требование повысить точность в такой ситуации преждевременно: сначала нужно определить, с чьими решениями сравнивать результат.
Можно сделать определение предметнее: в подборку входят общественные пространства, в которых видна повседневная жизнь; рекламные изображения жилых комплексов исключаются. Сразу возникает проверяемый вопрос. Фотография двора от застройщика выглядит естественно, но создана для рекламы. Отнести её к городу или к рекламному контенту? Видимые предметы не сообщают всех обстоятельств съёмки. Даже идеальное распознавание скамейки и дерева не решает редакционную задачу.
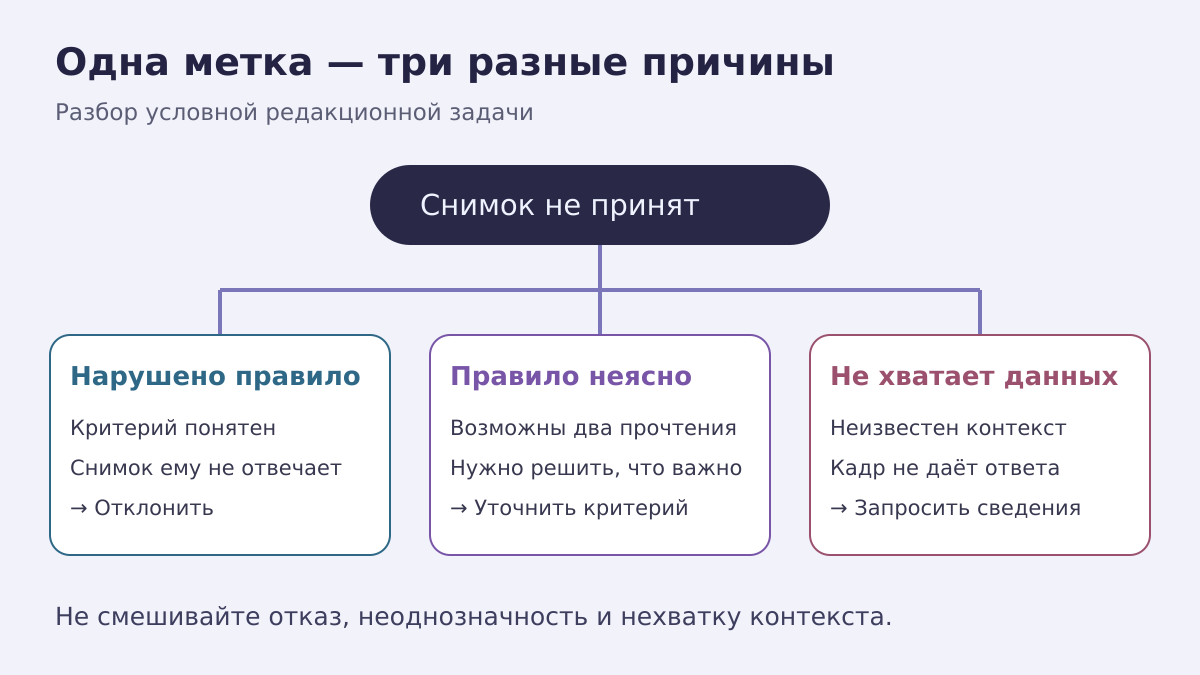
Здесь полезно различать три причины отказа. Изображение действительно противоречит правилу. Правило допускает несколько прочтений. На изображении недостаточно сведений для решения. Если слить их в одну красную метку, команда потеряет диагностическую информацию. В первом случае нужен отказ, во втором — обсуждение критерия, в третьем — дополнительный контекст или отложенное решение. Это разные действия, хотя итоговый ярлык может выглядеть одинаково.
Пограничный пример полезен именно тем, что мешает спрятаться за знакомым словом. При этом не стоит превращать любую дискуссию о вкусе в инженерную неисправность. Две редакции могут законно придерживаться разных представлений об уюте. Задача хорошего инструмента — сделать различие явным и последовательным. Доказывать, что одна эстетика объективно правильнее другой, такой инструмент не обязан и не может только на основании размеченных картинок.
Почему спорный пример ценнее десятка очевидных
Если показывать редакторам только открытки с красивыми улицами и очевидный рекламный мусор, они быстро придут к согласию. Однако это слабая проверка: материал просто не затрагивает границу. Гораздо интереснее ночная фотография промышленного района, где люди устроили маленький праздник. Она одновременно напоминает о городской жизни и нарушает чьё-то представление о приятном визуальном тоне. Именно здесь выясняется скрытое требование.
В нашем условном процессе обсуждение должно заканчиваться не только меткой для одной фотографии, но и формулировкой причины. Например: мы исключаем не промышленные объекты, а кадры, где нельзя различить происходящее. Тогда следующую хорошо освещённую фотографию того же района не придётся отклонять автоматически. Разница кажется языковой, но меняет целый класс будущих решений. Запоминание частного ответа и уточнение общего критерия — разные результаты работы.
Ещё один полезный ход — менять в примере только одно обстоятельство. Если одновременно поменялись время суток, район, присутствие людей и качество снимка, трудно понять причину нового решения. Пара похожих кадров помогает обсуждать конкретную границу. Это предложение для редакционного контроля, а не заявленная функция исследовательского прототипа. Его смысл в том, чтобы человек мог объяснить собственный выбор без подгонки аргументов после просмотра ответа модели.
Но подбор примеров тоже влияет на обсуждение. Коллекция из туристических центров редко заставит задуматься о дворах на окраине. Поэтому согласие внутри удобной подборки ещё не доказывает пригодность правила для всего города. В анализе такого инструмента я бы смотрела не только на красивые результаты, но и на происхождение коллекции: какие районы представлены, чего нет, кто выбрал фотографии и какие случаи система вообще не могла показать.
Кто отвечает за изменение определения
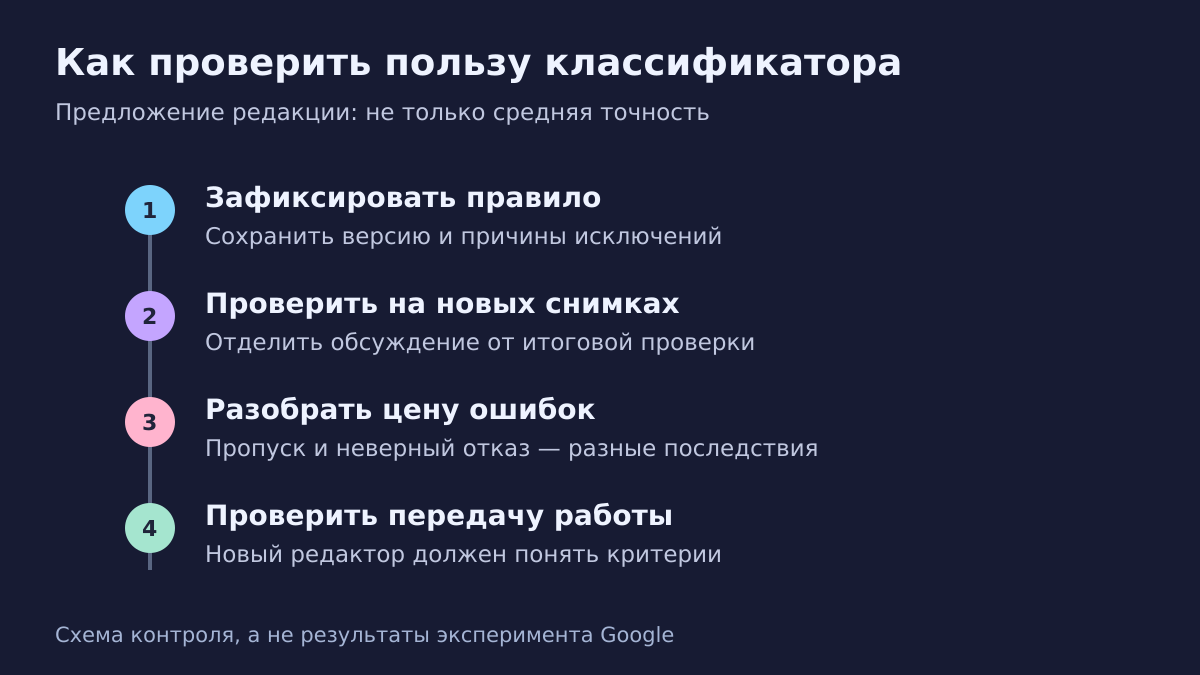
Допустим, редактор после нескольких спорных кадров решил включать уличные концерты. Это разумное уточнение, но оно меняет задачу. Нельзя тихо переписать критерий, пересчитать архив и объявить рост качества, сравнив новый результат со старой подборкой. Возможно, алгоритм стал лучше. Возможно, редакция просто расширила понятие. Чтобы отличить одно от другого, необходимы сохранённые версии правил и понятная история решений.
Я бы разделила ответственность на три роли. Автор правила объясняет цель подборки. Разметчик применяет действующую формулировку и отмечает сомнения. Человек, принимающий результат, решает, достаточно ли надёжно работает процесс. В маленькой редакции это может быть один сотрудник, но сами вопросы должны оставаться раздельными. Иначе удобно назвать любую ошибку непониманием модели, а любое улучшение — подтверждением правильности первоначального задания.
Особенно важен порядок для исключений. Если снимок допустили из-за документальной ценности, исключение должно быть обозначено как исключение. Иначе следующая версия инструкции может случайно превратить его в общее разрешение. Хороший журнал объясняет, какое правило действовало, почему решение изменилось и нужно ли пересматривать похожие материалы. Это не бюрократия ради отчёта: без такой записи команда снова обсудит ту же границу через неделю.
Есть и социальная сторона. Человек может согласиться с предложенной формулировкой просто потому, что она звучит убедительно и экономит время. Поэтому полезен независимый просмотр части решений без подсказок системы. Если оценщик видит сначала уверенное объяснение ИИ, его собственное суждение уже трудно отделить от влияния помощника. Вопрос о том, кто сформулировал правило, здесь столь же важен, как вопрос о том, кто нажал кнопку подтверждения.
Как проверять пользу без красивого самообмана
Для нашего редакционного сценария я предложила бы проверку на материалах, которые не участвовали в обсуждении. Иначе команда рискует научиться согласовывать знакомые картинки, а не применять понятное правило. Отдельно стоит сохранить спорные примеры: общий средний результат может выглядеть прилично, пока именно сложные случаи продолжают отправляться на бесконечный ручной разбор. Полезность системы зависит от того, где она снимает работу, а где создаёт новую.
Разные ошибки имеют разную цену. Пропустить неподходящий снимок в черновую папку обычно проще исправить, чем автоматически отклонить ценный кадр без возможности пересмотра. Поэтому единый показатель качества не заменяет обсуждение последствий. Для одной команды разумнее широкая предварительная подборка, для другой — осторожный отбор. Это решение о рабочем процессе, а не доказательство превосходства одной настройки на все случаи жизни.
Стоит измерять и труд человека. Сколько времени занимает разбор, сколько решений приходится пересматривать, сколько новых исключений рождает очередная правка? Если оператор экономит минуты на формулировке запроса, но затем часами исправляет неожиданные отказы, локальное улучшение не превратилось в практическую выгоду. При этом скорость сама по себе не должна становиться единственной целью: очень быстрое согласие может означать, что неприятные случаи просто исключили из проверки.
Наконец, важно предусмотреть честный ответ «недостаточно данных». Если фотография не показывает, был ли двор доступен всем жителям, нельзя извлечь этот факт из уверенного описания. Иногда правильное действие классификатора — направить материал человеку или запросить сведения о происхождении. Автоматизация становится полезнее, когда её граница видна, а не когда каждый объект обязательно получает окончательный ярлык. Возможность воздержаться от решения должна оцениваться вместе с точностью решений.
Открытый код — начало проверки, а не готовая служба
У проекта есть официальный репозиторий с демонстрационным блокнотом. Авторы отдельно предупреждают, что это не поддерживаемый продукт Google; прототип сочетает поиск изображений, их загрузку и обращения к языковой модели. Сам факт открытого кода полезен для изучения механизма, но не означает, что любая редакция получила готовую систему с сопровождением и предсказуемыми расходами.
Между демонстрацией и рабочим сервисом остаются организационные решения. Кто имеет право загружать коллекцию? Можно ли использовать её изображения для выбранной обработки? Где сохраняются пояснения редакторов? Как убрать материал, если он больше не должен участвовать в работе? Это вопросы конкретного внедрения. Нельзя считать, что исследовательский результат автоматически отвечает на них за будущего пользователя, даже если сам алгоритмический подход выглядит убедительно.
Отдельно я бы проверяла, переживает ли процесс смену сотрудников. Пока автор задания сидит рядом, любую неоднозначность можно разрешить устно. Если через месяц новый редактор не способен воспроизвести решения по сохранённым правилам, система держалась на личной памяти, а не на ясном определении. Передача работы другому человеку — полезное испытание качества инструкции, которое не заменяется эффектным показом нейросети на заранее отобранных примерах.
Для небольшого проекта разумный результат пилота может оказаться скромнее полной автоматизации: словарь спорных случаев, понятные исключения и небольшой набор контрольных изображений. Это уже ценность, если команда перестала путать недостаток данных с нарушением правила. Мой вывод из новости именно такой: ИИ интересен как инструмент обнаружения неясности. Но решение о том, какая ясность нужна и кому она выгодна, нельзя незаметно передать тому же помощнику.
Коротко
Agile Deliberation даёт повод иначе посмотреть на качество классификации: прежде чем требовать точного ответа, стоит убедиться, что вопрос достаточно определён. Ноябрьская публикация Google рассказывает о более ранней исследовательской работе; она не подтверждает универсальную готовность метода к любому применению. Для практики важны понятные версии правил, проверка на новых данных, право признать нехватку контекста и человек, отвечающий за последствия. Самый ценный результат обсуждения с ИИ — не уверенная метка на каждом изображении, а возможность объяснить, почему эта метка вообще нужна.
Пока нет комментариев