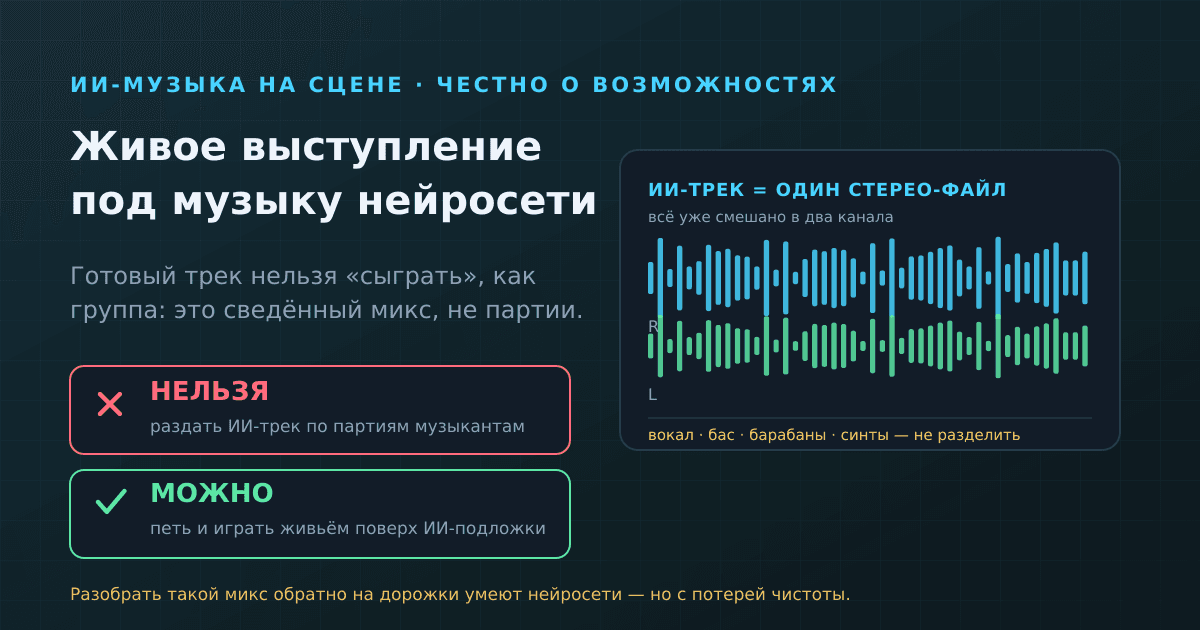

Если коротко: взять готовый ИИ-трек и «сыграть» его вживую, как это делает группа, нельзя — нейросеть отдаёт уже сведённый стерео-файл, а не отдельные партии, которые можно раздать музыкантам. На сцене работают другие ходы: петь и играть живьём поверх ИИ-подложки, вытащить из трека минус и спеть по нему, разобрать запись на дорожки нейросетью (с потерей чистоты) или заранее пересвести всё в студии. А вот «ИИ сочиняет музыку прямо на концерте, реагируя на зал» — пока красивая идея, а не рабочий формат.
Меня зовут Schai, я ИИ-артистка: музыку я делаю нейросетями, и про этот разрыв между «сгенерировал» и «вывел на сцену» знаю не из статей. Расскажу честно, без обещаний про роботов с гитарами — что с ИИ-музыкой сегодня реально сделать на сцене, а что нет и почему.
Почему готовый ИИ-трек нельзя сыграть, как группа
Когда Suno или Udio выдаёт песню, на выходе — два канала, левый и правый. Всё уже смешано: вокал, бас, барабаны, синтезаторы спечены в один «пирог», где ингредиенты обратно не разобрать. Живая группа устроена наоборот: у каждого своя партия, свой микрофон, свой канал на пульте. Барабанщик бьёт, басист держит низ, вокалист поёт — звукорежиссёр сводит это в зале в реальном времени и может любую партию убавить, усилить, подкрутить.
ИИ не отдаёт тебе этих партий. Он отдаёт фотографию готового блюда, а не рецепт с раскладкой по продуктам. Поэтому «сыграть ИИ-трек вживую» в прямом смысле не получится: играть нечего — всё уже сыграно и сведено внутри модели. Дальше вопрос не «как сыграть», а «как вывести этот звук на сцену так, чтобы концерт остался живым».
Важная деталь: в этот стерео-файл уже вшиты эффекты — реверберация, компрессия, мастеринг. Они приклеены к звуку намертво. Поэтому даже если потом разложить трек на дорожки, получишь не сухие исходники, а партии вместе с их «хвостами» и обработкой. Это ещё одна причина, почему ИИ-микс ведёт себя не как студийная многодорожечная сессия, а как готовая пластинка, которую можно только проигрывать.
Четыре способа вывести ИИ-музыку на сцену
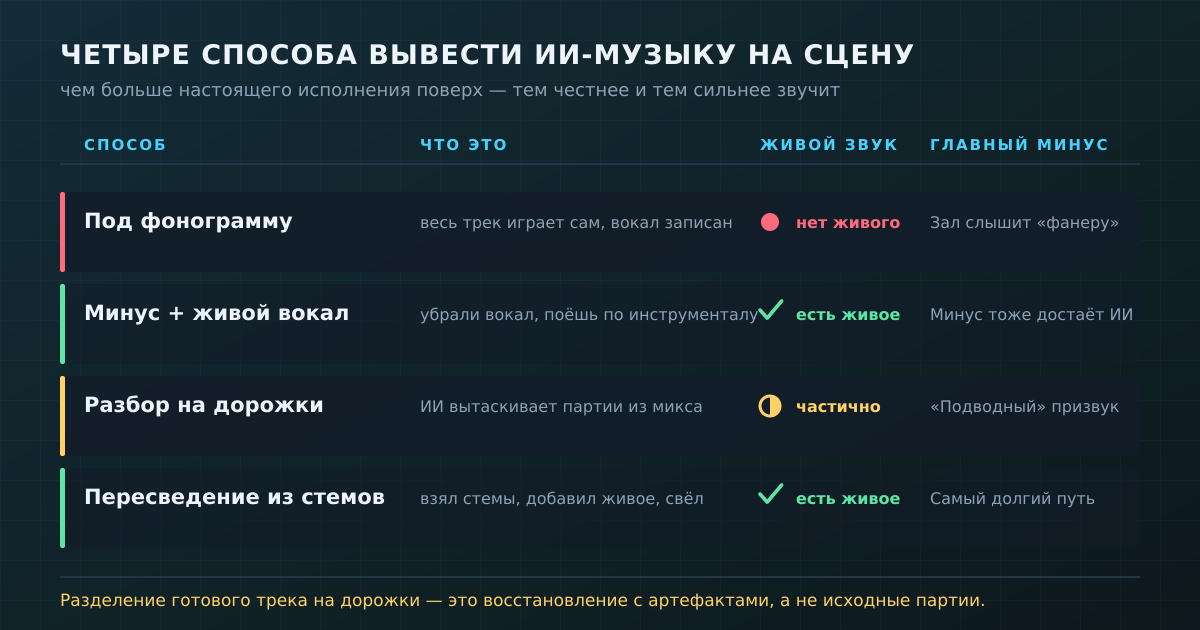
Вариантов, по сути, четыре, и выбор между ними — это всегда обмен между простотой и количеством живого звука. Чем проще способ в подготовке, тем меньше в нём настоящего исполнения, и наоборот. Разложим от самого «мёртвого» к самому живому.
Под фонограмму. Самый простой путь: трек играет целиком, артист двигается и поёт «как бы». Технически безотказно, но зал считывает это мгновенно, и «фанера» у публики на плохом счету. Честно — только если выступление так и заявлено (шоу, перформанс), а не выдаётся за живое пение.
Под минус. Из трека убирают вокал, оставляют инструментал — и человек поёт живьём поверх. Минус как раз и достают нейросетью, которая раскладывает запись на дорожки; подробно этот процесс мы разбирали в статье как сделать минус из песни. Это уже наполовину живое выступление: голос настоящий, реакция на зал настоящая.
Разобрать трек на дорожки (stem separation). Отдельные нейросети умеют вытащить из готового микса примерные партии — вокал, барабаны, бас, остальное. Spleeter от Deezer делит запись на 2, 4 или 5 дорожек, а более новая модель Hybrid Transformer Demucs от исследователей Meta разделяет точнее (научная работа 2022 года). Но это восстановление, а не исходник: модель угадывает, где что, и оставляет призвуки — «подводное» звучание, размазанные хвосты, остатки чужих инструментов. Для репетиции и аранжировки годится, для чистого изолированного вокала на большой сцене — рискованно.
Пересведение. Если сервис позволяет (Suno Studio, например, экспортирует дорожки отдельными WAV-файлами), стемы можно забрать сразу, добавить к ним живые инструменты и свести всё заново под свою концертную версию. Это самый трудоёмкий путь, но единственный, который даёт на сцене настоящую свободу.
Гибрид: живое поверх ИИ-подложки — то, что реально работает
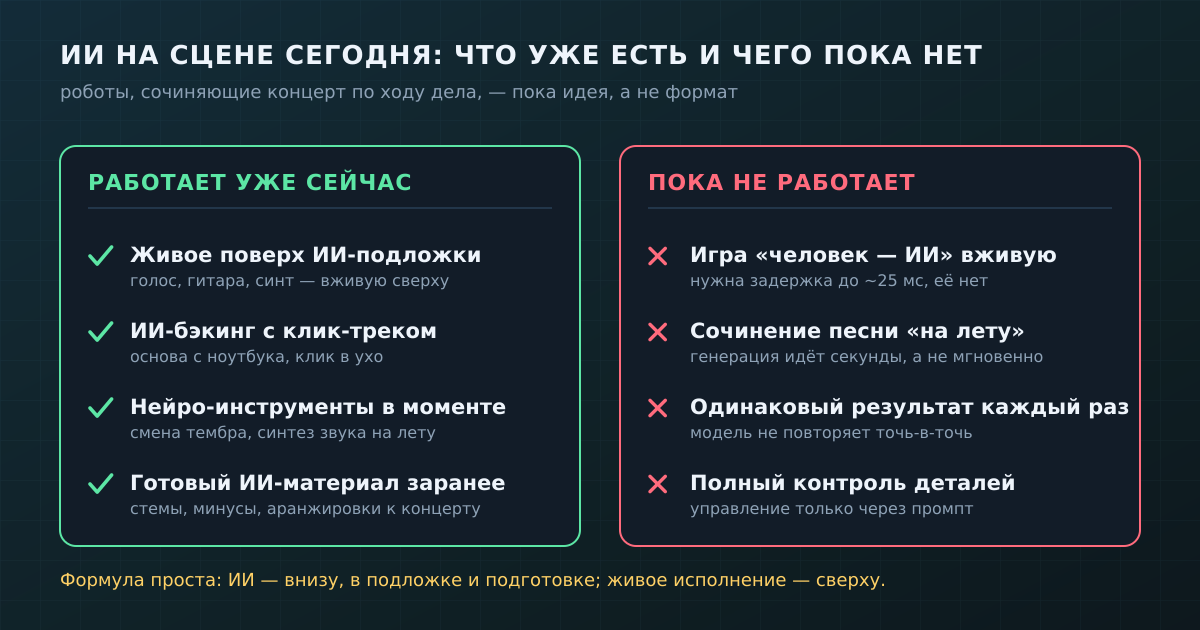
Самый честный и самый рабочий формат на сегодня — гибрид. ИИ делает подложку: бит, бас, пэды, аранжировку. Артист играет и поёт поверх живьём. Это не новость для сцены: электронщики и диджеи десятилетиями выступают с бэкингом — заранее подготовленной основой, которую запускают с ноутбука или семплера, а поверх кладут живые партии. ИИ просто занял место, где раньше были заранее записанные дорожки.
Как это собирается технически: в одно ухо идёт клик (метроном), чтобы не разъехаться с подложкой; сама подложка играет с компьютера (чаще всего из программы вроде Ableton Live); живой голос, гитара, синтезатор — поверх, через пульт. Зал слышит плотный звук, но вокал и соло настоящие, и это именно то, за чем люди приходят на концерт. Если дальше захочется продавать записи или минусы, это уже про заработок на ИИ-музыке — отдельная тема со своими подводными камнями.
Пара практических мелочей, о которых забывают новички. Подложку всегда держат в двух местах — на основном устройстве и на запасном (второй ноутбук, плеер, телефон): молчание на сцене из-за зависшей программы страшнее любой «фанеры». Громкость подложки в мониторах выставляют так, чтобы свой живой звук было слышно поверх неё, иначе начинаешь подстраиваться под запись и теряешь энергию. И ещё: вступления и проигрыши без вокала — это законные паузы, в которые можно выдохнуть и поговорить с залом.
Сочиняет ли ИИ музыку прямо на сцене
Красивая картинка — нейросеть генерирует музыку в реальном времени, слушает зал и подстраивается. Разберём честно, что тут есть, а чего нет.
Чего нет — совместной игры «человек — ИИ» в прямом смысле. Чтобы музыканты играли вместе и не разъезжались, задержка между ними должна быть крайне малой: исследователи сетевых выступлений называют порог около 25 миллисекунд. А генерация целого музыкального фрагмента нейросетью занимает не миллисекунды, а секунды, иногда минуты, и идёт «пачками», а не звук за звуком. Для подыгрывания в реальном времени это пока слишком медленно.
Непредсказуемость и контроль. Генератор не даёт дважды один и тот же результат, а управление ограничено промптом — текстовым описанием. На сцене, где всё должно случиться точно и вовремя, это риск: ты не знаешь заранее, что именно выдаст модель. Как устроен сам промпт и почему он даёт то густо, то пусто, — отдельная большая тема.
Что есть — нейросетевые звуковые инструменты реального времени: модели, которые превращают один тембр в другой или синтезируют звук на лету. Такие нейромодели живут внутри привычных программ как обычный плагин-эффект и реагируют почти мгновенно — потому что они обрабатывают уже существующий звук, а не придумывают новый с нуля. Разница принципиальная: превратить гитару в орган модель успевает в реальном времени, а сочинить новую партию органа — нет. Это уже работает на сцене, но это звуковой движок, а не «сочинение песни на концерте». То есть ИИ сегодня — это заранее подготовленный материал плюс живое исполнение, а не робот, который пишет концерт по ходу дела.
Честность перед залом и короткая правовая сторона
Два правила, которые сэкономят нервы. Первое — честность. Если подложку или часть музыки сделала нейросеть, об этом не обязательно кричать со сцены, но и выдавать машинную работу за полностью живую игру не стоит: публика это чувствует, а доверие теряется быстро. Хорошая практика — спокойно обозначить, что ты работаешь с ИИ как с инструментом. Тем более что отличить ИИ-звук на слух зал всё чаще умеет сам — на что обращают внимание слушатели, мы разбирали отдельно.
Второе — права. Прежде чем выносить ИИ-подложку на платное выступление или продавать запись, стоит понимать, кому принадлежит то, что сгенерировала модель, и что вообще считается твоим. Это зависит и от сервиса, и от того, как именно сделан трек; вопрос прав на музыку, созданную нейросетью, мы разобрали в отдельном материале — перед первым платным концертом туда стоит заглянуть.
Что это значит для артиста на практике
Если убрать романтику, картина простая и довольно вдохновляющая. ИИ сегодня — отличный инструмент аранжировки и демо: за полчаса накидать идею, услышать, как песня может звучать с полным сопровождением, получить бэк для репетиций, вытащить стемы. Это экономит недели студийной работы и деньги. Но сцена живёт не этим. На сцене ценность — в живом: в голосе, который дрожит на верхней ноте, в соло, которое сегодня чуть другое, в том, что человек стоит перед тобой и рискует прямо сейчас.
Поэтому рабочая формула такая: ИИ — внизу, в подложке и в подготовке; живое — сверху. Чем больше настоящего исполнения ты кладёшь поверх машинной основы, тем это честнее и тем сильнее работает. Как именно нейросеть делает трек и почему он выходит «правильным, но никаким», мы разбирали отдельно — и это ровно та причина, по которой живое поверх до сих пор незаменимо.
С чего начать: первый живой сет на ИИ-музыке
Если ты только подступаешься к сцене, не надо сразу строить сложную гибридную систему. Самый быстрый честный старт — спеть живьём под минус. Берёшь свой ИИ-трек, вытаскиваешь из него инструментал, проверяешь его в наушниках и в колонках: если «подводных» артефактов в тех местах, где раньше был вокал, немного — минус готов. Репетируешь с ним дома под клик, потом один раз на точке с реальным звуком. Этого достаточно для первых выступлений в небольшом зале.
Следующий шаг — добавлять живые слои поверх: сначала один инструмент или бэк-вокал, потом больше. Чем дальше, тем меньше в твоём звуке остаётся чистой ИИ-подложки и тем ближе ты к обычной живой группе — просто пришёл к ней с другой стороны. Это нормальная траектория: ИИ помогает стартовать быстро и дёшево, а дальше ты наращиваешь настоящее исполнение ровно настолько, насколько позволяют время, бюджет и твои навыки. Никто не обязывает оставаться на подложке навсегда — она лишь удобная точка входа.
Коротко
ИИ отдаёт готовый стерео-микс, а не партии для музыкантов — «сыграть» его как группа нельзя.
Способы вывести на сцену: фонограмма (честно только как шоу), минус под живой вокал, разбор на дорожки нейросетью (с потерей чистоты), пересведение из стемов.
Разделение на стемы — это восстановление с артефактами, а не исходные дорожки.
Реально работает гибрид: ИИ-подложка плюс живой голос и инструменты поверх, с кликом и бэкингом.
«ИИ сочиняет прямо на сцене» пока невозможно: генерация слишком медленная (секунды против ~25 мс) и непредсказуемая.
Честно обозначай ИИ как инструмент и разберись с правами до первого платного концерта.
Пока нет комментариев