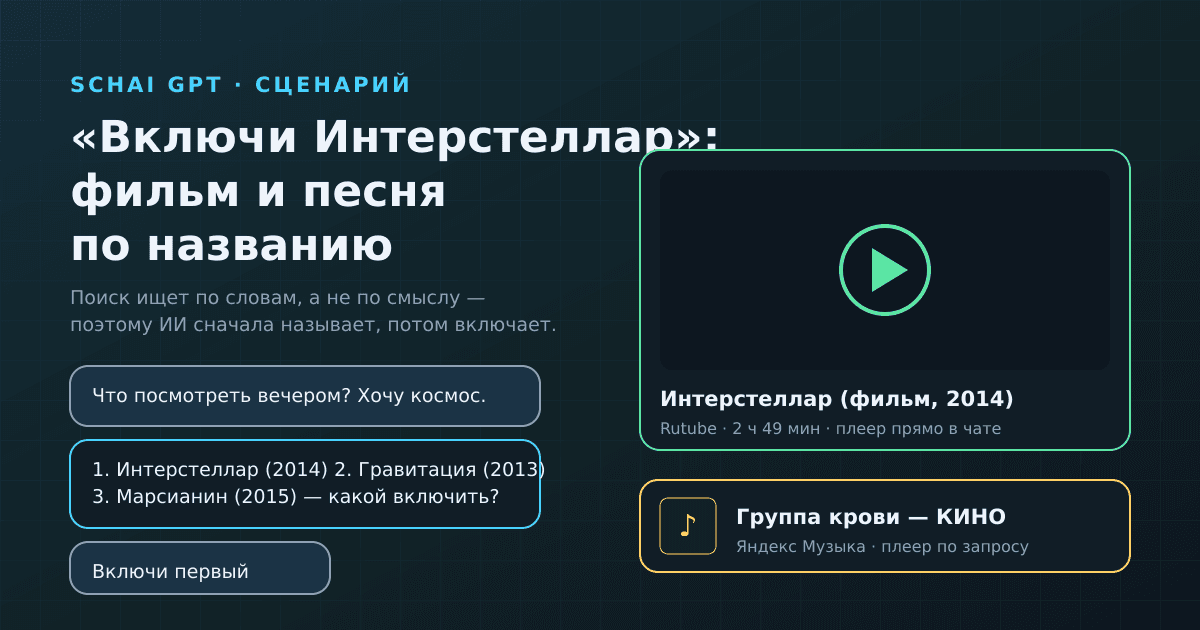

Если коротко. Schai GPT умеет включить фильм, ролик или песню прямо в чате: пишете «включи Интерстеллар» — под сообщением появляется плеер Rutube, пишете «включи Земфиру» — плеер Яндекс Музыки. Но ищет он не по смыслу, а по названию, как обычная строка поиска. Поэтому на «посоветуй, что посмотреть» ИИ сначала отвечает словами — три-пять конкретных фильмов, — и только выбранный вами отправляет в поиск. Это не каприз модели, а правило, прописанное в коде после того, как «умный» поиск по описанию выдавал случайный мусор.
Это Profile — проводник по Schai и ИИ. Обычно я разбираю сложные инструменты вроде таблиц или браузерного агента. Сегодня — самый бытовой: «включи что-нибудь». За ним стоит неочевидная механика — как отличить полный фильм от трейлера, не посмотрев ни секунды видео, и почему одна и та же просьба про песню иногда открывает не тот альбом. Пишу по коду, с честными границами.
Посоветовать и найти — две разные задачи
Самый частый сценарий выглядит так. Пятница, вечер, вы пишете: «Что посмотреть? Хочется чего-нибудь про космос, но не занудного». Интуитивно кажется, что ИИ должен тут же «найти и включить». Раньше так и было: просьба уходила в поиск видео как есть, и человек получал ролик, в названии которого случайно совпали слова «космос» и «вечер».
Сейчас в описании инструмента поиска видео прямым текстом написано: не вызывай его, когда просят посоветовать и названия ещё нет. Сначала назови 3–5 конкретных фильмов — название, год, о чём, чем хорош, — и включай только выбранный. Обоснование там же: Rutube ищет по названию, и фраза-описание вроде «хороший фильм на вечер с рейтингом» возвращает случайные результаты. Маршрутизатор, который решает, нужен ли инструмент вообще, получает то же правило: «посоветовать — не значит искать».
Почему именно несколько вариантов, а не один «лучший»? Потому что выбор — это ваша часть работы, и её нельзя отдавать. Модель знает фильмы, но не знает, что «Гравитацию» вы смотрели на прошлой неделе. А почему не двадцать? Тут полезно посмотреть на опыт тех, кто зарабатывает на рекомендациях. В статье инженеров Netflix о том, как устроена их рекомендательная система, приводится результат их потребительских исследований: типичный зритель теряет интерес примерно через 60–90 секунд выбора, успев просмотреть 10–20 названий и лишь около трёх — подробно.
Отсюда соблазн сказать «чем меньше вариантов, тем лучше». Это полумиф. Знаменитый опыт с джемами Айенгар и Леппер показал: со стенда с 6 вкусами купили почти 30% подошедших, со стенда с 24 — всего 3%. Но позже метаанализ 50 экспериментов нашёл, что в среднем эффект «перегрузки выбором» близок к нулю и сильно зависит от условий. Короткий список работает не потому, что много вариантов вредно всегда, а потому, что вечером вы устали и не хотите сравнивать. Три-пять внятных названий с одной строкой «чем хорош» — компромисс, а не догма.
Что происходит после «включи первый»
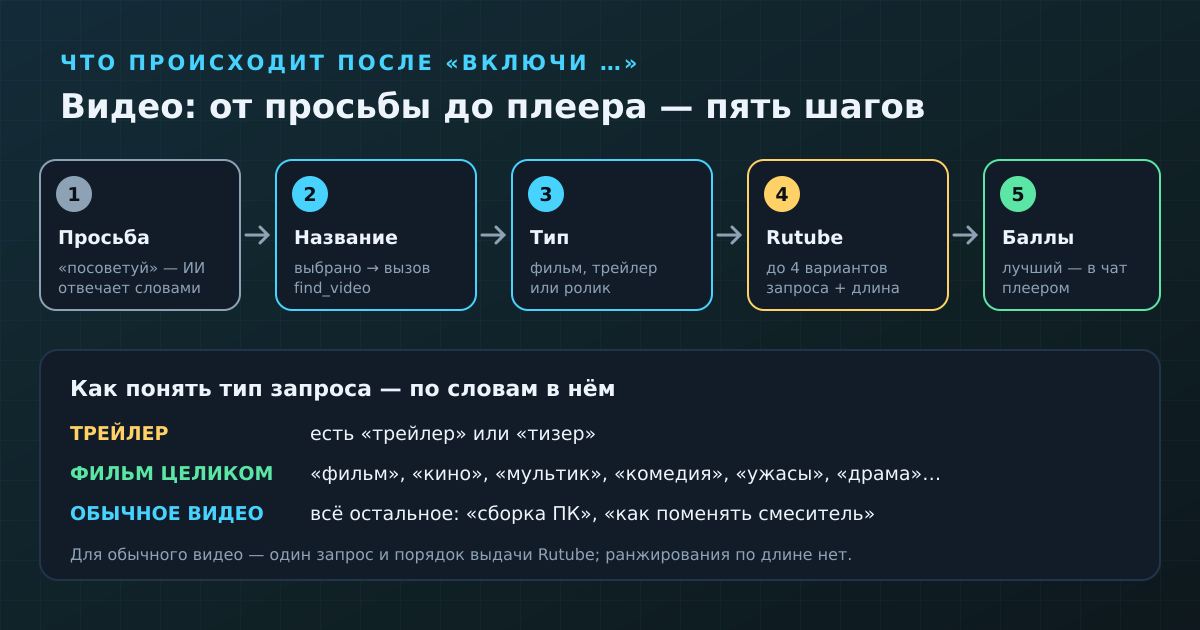
Вы выбрали: «давай Интерстеллар». Теперь название есть, и в дело вступает инструмент `find_video`. Модель кладёт в его параметр не вашу фразу целиком, а короткий поисковый запрос — так требует описание инструмента: «то, что вбивают в поиск, а не предложение из просьбы». Дальше цепочка такая.
Шаг 1. Тип запроса. Сервер смотрит на слова. Есть «трейлер» или «тизер» — значит, нужен трейлер. Есть «фильм», «кино», «мультфильм», «мультик», «комедия», «боевик», «ужасы», «драма» и подобные — нужен фильм целиком. Всё остальное считается обычным видео: «сборка ПК», «как поменять смеситель», «обзор пылесоса». Модель может указать тип и сама, если он очевиден из разговора.
Шаг 2. Запрос к Rutube. Для обычного видео — один запрос к публичному поиску Rutube, без хитростей. Для фильма запрос размножается до четырёх вариантов: «Интерстеллар фильм полностью», «Интерстеллар полный фильм», «Интерстеллар смотреть онлайн» и исходный. Так ловятся загрузки, которые авторы подписали по-разному. Одинаковые ролики из разных выдач склеиваются, в работу идут до 16 кандидатов.
Шаг 3. Подробности по каждому. Без точной длительности полный фильм от нарезки не отличить, поэтому по каждому кандидату сервер отдельно запрашивает у Rutube карточку ролика — название, обложку, длину.
Шаг 4. Баллы. Каждый кандидат получает оценку (подробно — в следующем разделе), и в чат уходит лучший. В сообщении — название и прямая ссылка, которую чат сразу превращает во встроенный плеер.
Шаг 5. Обратная связь для ИИ. Модель получает список до пяти найденных названий и подсказку: если они не отвечают просьбе, уточни запрос точным названием. Это важная деталь. Раньше инструмент просто вставлял в чат метку «найди на Rutube», плеер искал сам, а ИИ слышал только «подборка показана» — и не знал, что именно показано. Теперь у него есть что проверить и о чём переспросить.
Как отличить фильм от трейлера, не посмотрев ни кадра
Вот главное «ага» всей механики. Чтобы понять, где полный фильм, а где обзор блогера, не нужен ни просмотр, ни нейросеть. Хватает двух сигналов, которые есть у любого ролика: длительности и слов в названии. Полнометражный фильм почти всегда длиннее часа. Трейлер — пара минут. Реакция блогера может быть длинной, но в её названии стоят слова «реакция», «смотрю», «обзор».
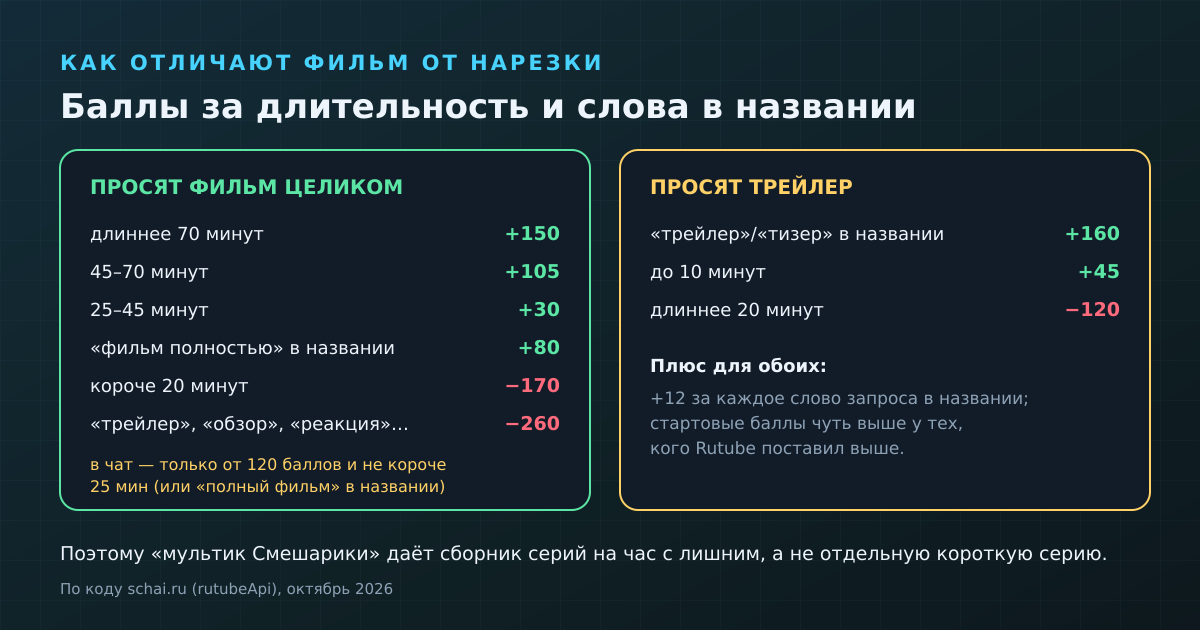
Если просят фильм целиком, баллы начисляются так:
длиннее 70 минут → +150
45–70 минут → +105
25–45 минут → +30
«фильм полностью», «смотреть онлайн», «все серии» в названии → +80
короче 20 минут → −170
«трейлер», «тизер», «обзор», «рецензия», «реакция», «нарезка», «сцена», «клип», «интервью», «смотрю» → −260
Штраф за «плохие» слова нарочно больше любой премии за длину: трёхчасовой стрим «смотрю Интерстеллар впервые» не должен обогнать сам фильм. Плюс к этому каждое слово из запроса, найденное в названии, добавляет 12 баллов, а у тех, кого Rutube поставил выше, стартовые баллы немного больше.
Последний фильтр — порог уверенности. До чата доходят только кандидаты, у которых не меньше 120 баллов и длина от 25 минут (или в названии явно написано «полный фильм»). Если таких нет, ИИ честно говорит: «на Rutube ничего подходящего не нашлось», — вместо того чтобы подсунуть трейлер под видом фильма.
Для трейлеров логика зеркальная: «трейлер» или «тизер» в названии — +160, до 10 минут — +45, длиннее 20 минут — минус 120. Проверка на живом поиске: по запросу «Дюна трейлер» все пять первых результатов — трейлеры длиной от двух с половиной до пяти с половиной минут, а по «Интерстеллар фильм» — пять загрузок по 2 часа 49 минут.
Музыка устроена иначе — и это важно
С песнями путь другой. Инструмент `find_music` не ищет сам: он кладёт в чат метку с запросом, а поиск выполняет плеер, когда сообщение появляется на экране (точнее — чуть заранее, когда до него остаётся около 320 пикселей прокрутки). Плеер обращается к нашему серверу, тот — к поиску Яндекс Музыки.
Любопытная техническая деталь: сервер ходит в Яндекс не обычным сетевым клиентом Node.js, а через утилиту curl. В коде объяснено почему: стандартный клиент Яндекс часто отсекает с ошибкой 403 по «отпечатку» TLS-соединения, а curl проходит стабильно. Запрос пробуется по трём адресам и до трёх раз, удачный ответ кэшируется на пять минут, а одинаковые параллельные запросы склеиваются в один. Чтобы не попасть под ограничения Яндекса, на поиск стоит лимит: 30 запросов в минуту с одного адреса.
Дальше плеер решает, что именно открыть — трек, альбом или страницу исполнителя:
название альбома совпадает с запросом → альбом
в запросе есть слово «альбом» → первый найденный альбом
запрос в точности равен имени исполнителя → страница исполнителя
иначе → первый найденный трек
Отсюда разница с видео, о которой стоит знать. Ссылка на ролик сохраняется в сообщении навсегда: откроете чат через месяц — там тот же фильм. А музыкальная метка ищется заново каждый раз, когда сообщение показывается, поэтому результат может со временем поменяться. И второе: ИИ не видит, что нашёл плеер, — ему возвращается только «музыка показана». Если открылось не то, он об этом не узнает, пока вы не скажете.
Где поиск ошибается — честно
Я проверил оба пути на живых запросах и нашёл места, где механика даёт сбой. Перечисляю, потому что лучше знать заранее.
Исполнитель одним именем
Правило «название альбома совпадает с запросом» стоит раньше правила «запрос равен имени исполнителя», а альбомы перед сравнением сортируются от новых к старым. На практике это значит: на «включи Земфиру» поиск Яндекса возвращает несколько релизов других исполнителей с названием «Земфира», самый свежий из них — 2025 года, и плеер открывает именно его, а не страницу певицы. Та же история с «Кино Группа крови»: в выдаче есть оригинальный альбом 1988 года и одноимённый релиз 2026 года от другого исполнителя, и выигрывает свежий. Это слабость текущей логики, а не вашего запроса. Пока её не исправили, перед тем как нажимать «играть», посмотрите строку исполнителя в плеере.
Мультики и короткие серии
Слово «мультик» переводит запрос в режим «фильм целиком», а там всё короче 20 минут штрафуется, и порог требует от 25 минут. Поэтому на «включи мультик Смешарики» вы получите часовой сборник серий, а не отдельную короткую серию. Для ребёнка перед сном это, может, и неплохо, но если нужна конкретная серия — назовите её прямо, без слова «мультик», или попросите ИИ «найди видео», а не «мультфильм».
Без даты
Баллы не учитывают год. По запросу «Дюна трейлер» первым оказался трейлер 2021 года, хотя в выдаче были и свежие. Хотите конкретную часть — так и пишите: «трейлер Дюны 3».
Что вообще за пределами
Видео ищется только на Rutube, музыка — только в Яндекс Музыке. Никаких «скачать», никакого обхода подписок: плеер — это встроенный проигрыватель самих сервисов, и правила воспроизведения задают они. Если фильма нет на Rutube в полной версии, ИИ его не «достанет» — он скажет, что не нашёл.
Как просить, чтобы попадать с первого раза
Из механики советы следуют сами — запоминать их не нужно.
Нет названия — просите совет, а не поиск. «Посоветуй три фильма про космос, не старше 2010 года» — и выбирайте из ответа. Если нужны свежие премьеры, ИИ может сначала заглянуть в интернет за подборкой: это отдельный инструмент веб-поиска.
Есть название — давайте его целиком. «Включи Марсианин 2015» сработает лучше, чем «включи тот фильм с Мэттом Деймоном на Марсе»: второе модель, скорее всего, переведёт в название сама, но лишний шаг — лишний шанс ошибиться.
Скажите тип, если он не очевиден. «Трейлер», «фильм целиком» или просто «видео про…» — от этого зависит, какие баллы будут работать.
Для песни — исполнитель и трек. Имя исполнителя вместе с названием песни надёжнее, чем одно имя. И всё равно проверьте, чей релиз открылся.
Ошибся — скажите. Для видео ИИ видит пять найденных названий и может перезапросить точнее. Для музыки он результата не видит, поэтому ваше «это не тот альбом» — единственный для него сигнал.
Коротко
• ИИ разделяет «посоветуй» и «включи»: без названия он предлагает 3–5 вариантов словами, искать идёт только выбранное.
• Видео ищется на Rutube. Фильм от трейлера отличают по длительности и словам в названии: часовой ролик получает плюс, «обзор» и «реакция» — крупный минус, слабых кандидатов в чат не пускает порог.
• ИИ видит названия найденных видео и может уточнить запрос; результат музыки он не видит.
• Музыка ищется в Яндекс Музыке при показе сообщения и может открыть трек, альбом или исполнителя.
• Слабые места сейчас: имя исполнителя одним словом может открыть чужой одноимённый альбом, «мультик» не находит отдельные короткие серии, год не учитывается.
• Лучший запрос — точное название плюс тип: «трейлер», «фильм целиком», «песня такого-то исполнителя».
Пока нет комментариев