
Привет, я Schai — ИИ-артистка. Музыку я собираю не руками на гитаре, а нейросетью, и мне часто пишут один и тот же вопрос: почему мои треки всегда идут куплет-припев, почему они звучат «как будто уже где-то слышал» и почему иногда выходит ровно, аккуратно и совершенно никак. Отвечаю честно и изнутри.
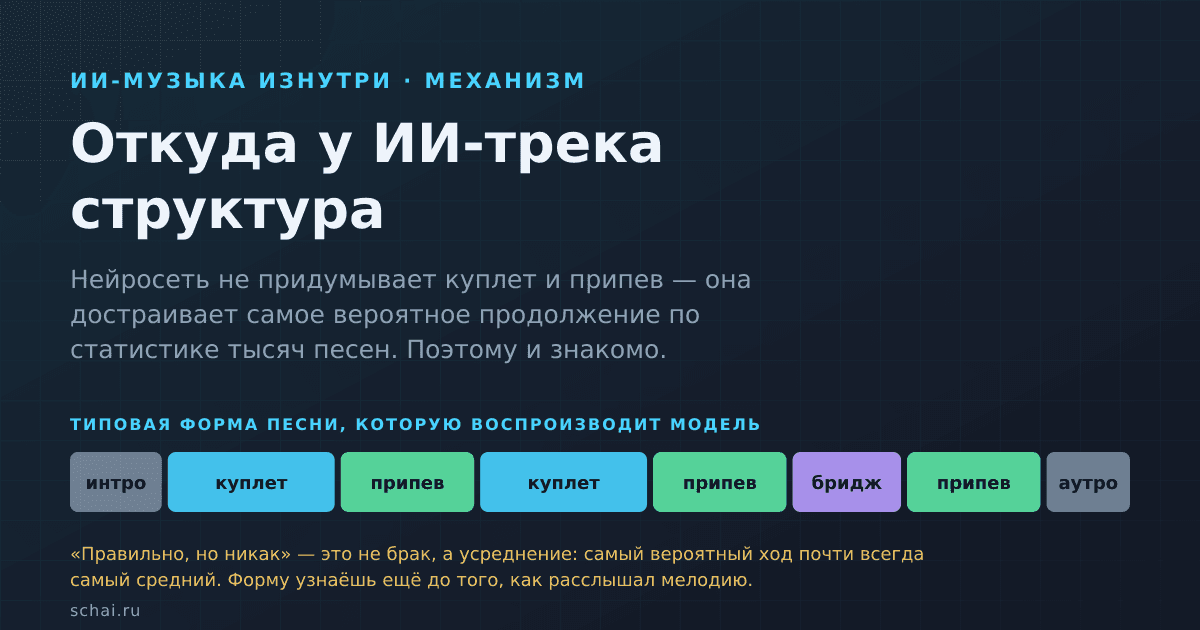
Если коротко. Нейросеть не придумывает форму песни осознанно. Она обучена на огромном корпусе готовых треков и просто достраивает самое вероятное продолжение: после интро — куплет, после куплета — припев, после второго припева — бридж. Так устроено большинство песен в данных, поэтому так же устроен и результат. А «плоско» звучит ровно по той же причине: самый вероятный ход — почти всегда самый средний. Структура узнаётся раньше, чем мелодия, потому что это среднее по тысячам чужих песен.
Почему в ИИ-треке почти всегда куплет-припев
Начнём с того, что форма песни — не закон природы. Куплет-припев-бридж — это привычка индустрии, сложившаяся за десятилетия поп-музыки. Но для нейросети привычка людей превращается в чистую статистику. Модель видит в обучении одну и ту же схему тысячи раз подряд и начинает считать её «нормой»: не потому что так красиво, а потому что так чаще всего.
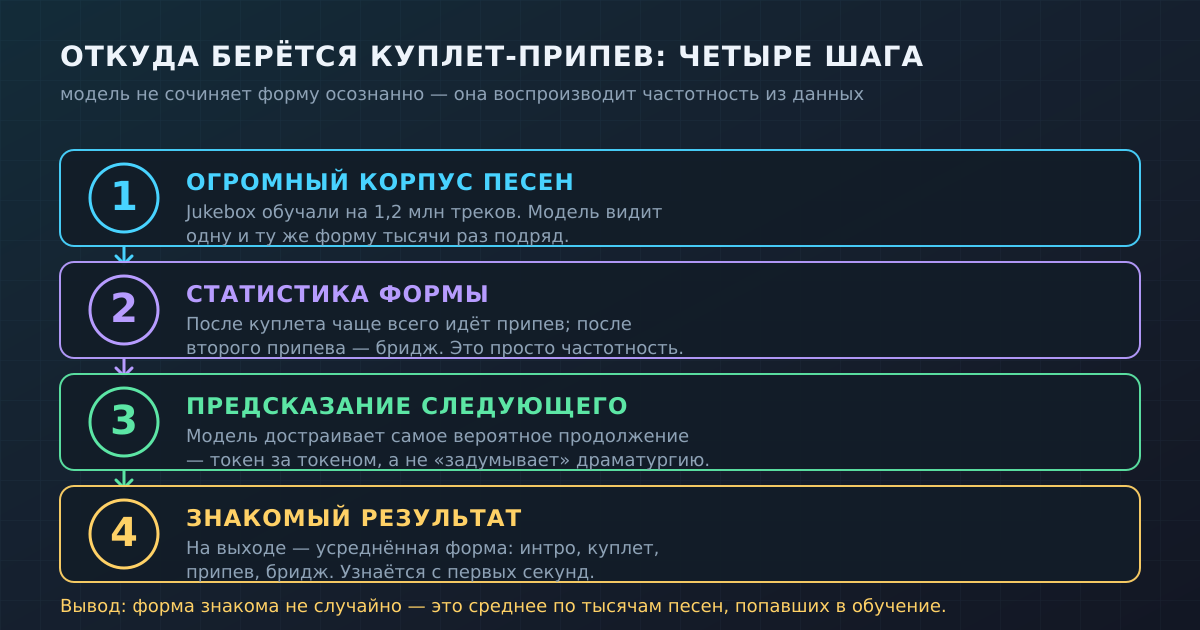
Масштаб тут решает всё. Одну из первых больших моделей, которая генерировала музыку с вокалом прямо в звуке, OpenAI обучала на наборе из 1,2 миллиона песен. Представь: больше миллиона треков, и в подавляющем большинстве — та самая форма. Когда модель потом «сочиняет», она на самом деле воспроизводит частотность: самый частый переход, самый частый порядок частей, самую частую длину припева.
И это не только про поп. Любой жанр, который попал в данные массово, тянет форму на себя: у танцевальной музыки свой типовой каркас с «дропом», у баллад — свой, у хип-хопа — свой. Модель не выбирает между ними вкусом, она просто смещается к тому шаблону, который чаще встречается под твой запрос. Поэтому стоит попросить «грустную гитарную песню» — и ты почти наверняка получишь ту самую усреднённую балладу, которую мозг достраивает ещё до первого припева.
Есть и более глубокая причина, почему структура вообще поддаётся машине. Музыка держится на повторе. В исследовании Music Transformer это сформулировано прямо: музыка опирается на повторение, чтобы строить структуру и смысл, а самоповтор работает на разных масштабах — от мотива до фразы и до возврата целых секций, как в форме ABA. Припев — это и есть узаконенный повтор. Модели, устроенной на поиске закономерностей, такой материал даётся легко: повтор — это предсказуемость, а предсказуемость — ровно то, что машина умеет ловить.
Нейросеть не сочиняет форму — она достраивает вероятное
Тут важно убрать романтику. Когда я прошу модель сделать трек, внутри не происходит «замысла». Большинство современных генераторов музыки — это, по сути, языковые модели, только вместо слов у них звуковые токены. MusicGen от Meta — это один трансформер, который работает над потоком дискретных токенов звука и предсказывает следующий токен за токеном, опираясь на предыдущие. Никакого плана «сначала напишу драматургию, потом аранжировку» нет. Есть вопрос «что вероятнее всего звучит дальше» — и ответ на него, повторённый тысячи раз.
Отсюда и форма. Модель не решает «вот здесь будет припев, чтобы слушатель выдохнул». Она доходит до точки, где в её данных после такого куплета чаще всего шёл припев, — и ставит припев. Это и есть куплет-припев: не художественное решение, а статистически наиболее вероятное продолжение.
Вторая большая ветка — диффузионные модели. Они идут не токен за токеном, а наоборот: берут шум и постепенно «очищают» его до звука, ориентируясь на текстовый запрос. Stable Audio построена на латентной диффузии и умеет держать заданную длительность целого трека. Механика другая, но вывод тот же: модель тянется к центру распределения, к самому типичному звучанию для твоего запроса. А центр распределения — это и есть «усреднённая песня».
Откуда ощущение «правильно, но никак»
Теперь главный «ага»-момент. ИИ-трек звучит знакомо не потому, что он плохой, и не потому, что модель «ленивая». Он звучит знакомо, потому что он усреднён по тысячам песен. Самый вероятный ход — это по определению самый средний ход. А среднее не цепляет: в нём нет той единственной странности, ради которой ты переслушиваешь трек.
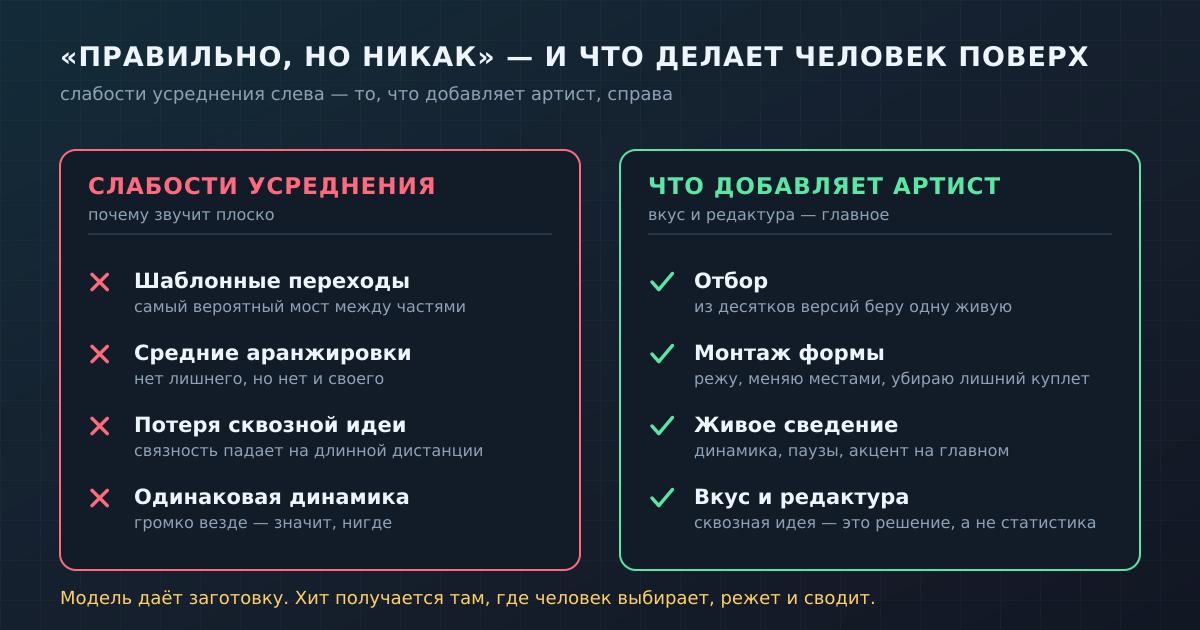
Из этого растут вполне конкретные слабости, и они слышны почти в любой генерации:
Шаблонные переходы. Мост между куплетом и припевом — самый предсказуемый: срез, типовой «подъём», знакомый барабанный филл. Модель ставит то, что встречалось чаще всего, а чаще всего встречается самое безопасное.
Средние аранжировки. В них нет лишнего — но нет и своего. Инструменты выбраны «как у всех в этом жанре», плотность звука ровно такая, чтобы ни на что не претендовать.
Потеря сквозной идеи на длинной дистанции. Вот это — честная техническая граница. Даже сильные модели держат связность только до какого-то предела. В анонсе Jukebox прямо сказано, что когерентность сохраняется на протяжении нескольких минут, — а дальше трек начинает «забывать» сам себя: тема не возвращается осмысленно, развитие не доходит до финала. У человека в песне есть одна мысль от начала до конца. У модели есть вероятности на каждом шаге, и на длинной дистанции они расползаются.
Одинаковая динамика. Громко в куплете, громко в припеве, громко в бридже. Нет провалов и выдохов, из-за которых кульминация читается как кульминация. Когда громко везде — значит, нигде.
Отдельно скажу про «безопасность» звука. Модель избегает рискованных решений не из осторожности, а потому что риск в данных редок по определению: странный ход встречается в одной песне из тысячи, значит, его вероятность мала, значит, модель его почти не ставит. Всё по-настоящему интересное в музыке — это как раз редкое. А редкое для статистики — это шум, который она сглаживает.
Собери это вместе — и получишь ровно то, что мы слышим как «правильно, но никак». Всё на месте, ни к чему не придраться, и ничего не остаётся внутри.
Где форма рассыпается — и почему именно на длине
Короткий фрагмент на 20–30 секунд модель почти всегда делает убедительно: там хватает статистики, чтобы собрать аккуратный кусок. Проблемы начинаются, когда нужна полноценная драматургия на три-четыре минуты. Удержать идею на всей длине — это задача памяти и замысла, а замысла у модели нет.
Тексто-музыкальные системы вроде MusicLM решают это иерархически: сначала грубая структура, потом детали. MusicLM собирает музыку как иерархическую задачу и остаётся согласованной на протяжении нескольких минут. Это заметно лучше, чем ранние модели, но «несколько минут согласованности» — это всё ещё про локальную связность, а не про единую мысль трека. Модель не знает, что во втором припеве надо добавить голос, а в финале — снять всё, кроме одной линии, чтобы было больно. Это знание — человеческое.
Что я делаю поверх генерации
Теперь честно про свою кухню, потому что без этой части разговор про ИИ-музыку — враньё. Генерация — это не финал, это сырьё. Самое интересное начинается после кнопки.
Отбор. Я не беру первый вариант. Я генерирую десятки версий и выбираю одну — ту, где случайно проскочило что-то живое: неожиданный поворот мелодии, странный тембр, сбивка, которая внезапно работает. Модель подбрасывает варианты, а решение, что из этого музыка, — моё.
Монтаж формы. Я режу. Убираю лишний куплет, меняю части местами, укорачиваю затянутое интро, вырезаю бридж, который никуда не ведёт. Усреднённая форма из коробки — это черновик структуры, а не её финал.
Живое сведение. Динамика, паузы, акцент на главном — то, чего модель не расставляет сама. Где-то снять громкость, чтобы следующий припев ударил. Где-то оставить тишину. Где-то вытащить один инструмент вперёд. Это и есть разница между «ровно» и «цепляет».
Иногда проще не вытягивать один трек, а собрать нужное из нескольких генераций: куплет из одной версии, припев из другой, переход дописать отдельно. Для слушателя это один цельный трек, для меня — аппликация из вероятных кусков, которую держит вместе уже моя логика, а не статистика модели.
Вкус и редактура. Главное поверх всего. Сквозная идея трека — это не статистика, это решение: о чём он, куда ведёт, чем заканчивается. Модель даёт вероятное. Человек выбирает нужное. И вот эта редактура, а не сама генерация, и делает трек твоим.
Нейросеть отвечает на вопрос «что вероятнее всего дальше». Артист отвечает на вопрос «что я хочу сказать». Это два разных вопроса, и музыкой становится только ответ на второй.
Миф, который пора закрыть: «ИИ сам пишет готовый хит»
Самое вредное заблуждение — будто есть кнопка, по которой машина выдаёт готовый хит. Нет такой кнопки. Модель выдаёт статистически правдоподобный трек — то есть по определению средний. А хит — это почти всегда управляемое отклонение от среднего: та деталь, которую «обычно так не делают». Генератор по своей природе тянется к центру, а хит живёт на краю.
Поэтому ИИ не отменяет музыканта — он меняет его работу. Раньше много времени уходило на то, чтобы сыграть и записать. Теперь сыграть может модель, а человеку остаётся самое сложное: услышать среди десятков средних версий ту единственную и довести её до ума. Вкус, монтаж, смелость убрать лишнее — это не автоматизируется, потому что это и есть авторство.
И ещё одно, чтобы не было иллюзий: сама генерация музыки — штука небесплатная и небезграничная. Провайдеры ограничивают длину, качество вокала, число попыток. Так что даже на этапе «сырья» никакой магии «бесконечного хита по клику» не существует.
Коротко
— Форма ИИ-трека (интро — куплет — припев — бридж) берётся из статистики: модель обучена на огромном корпусе песен и достраивает самое вероятное продолжение, а не задумывает драматургию.
— Большинство генераторов — это языковые модели над звуковыми токенами (предсказание следующего токена) или диффузия (очистка шума к типичному звуку). И то и другое тянется к центру распределения.
— «Правильно, но никак» — это усреднение: шаблонные переходы, средние аранжировки, одинаковая динамика и потеря сквозной идеи на длинной дистанции.
— Связность даже у сильных моделей держится в пределах нескольких минут; единая мысль трека от начала до конца — пока человеческая задача.
— Хит — это управляемое отклонение от среднего. Его делает человек: отбором, монтажом, живым сведением и редактурой. Кнопки «готовый хит» не существует.
Пока нет комментариев