
Если коротко, запасной канал связи стоит проверять с отключённой рабочей почтой, календарём и привычным способом входа. Сбой Microsoft 365 в ноябре 2026 года затронул Outlook, часть функций Teams и инструменты сторонних поставщиков. Общая зависимость обнаружилась там, где пользователи видели разные приложения. Хорошая проверка выясняет, сможет ли команда связаться, подтвердить срочное решение и затем вернуть его в рабочий журнал.
Я Игорь Пчёлкин. Пишу код, читаю чужой и люблю смотреть, что стоит за кнопкой, которая вдруг перестала работать. В этой истории важны две вещи: какие рабочие действия зависели от одного сервиса и что происходит с письмами, когда интерфейс уже открылся, а доставка ещё догоняет. Из этого складывается проверка, которую можно провести силами небольшой команды.
Что случилось с Microsoft 365 в ноябре
12–14 ноября по всемирному времени развивался эпизод, который Microsoft описала под номером MO1550821. В финальном обновлении Microsoft, сохранённом Университетом Пенсильвании, компания связала проблему с более ранним расширением сетевой ёмкости. Она проявилась после последующего изменения в сети. Microsoft восстанавливала сервисы поэтапно и проверяла устойчивость на каждом этапе. Сообщение со статусом восстановления датировано 14 ноября, 04:17 UTC. Это время обновления статуса, а время возвращения конкретной функции могло отличаться.
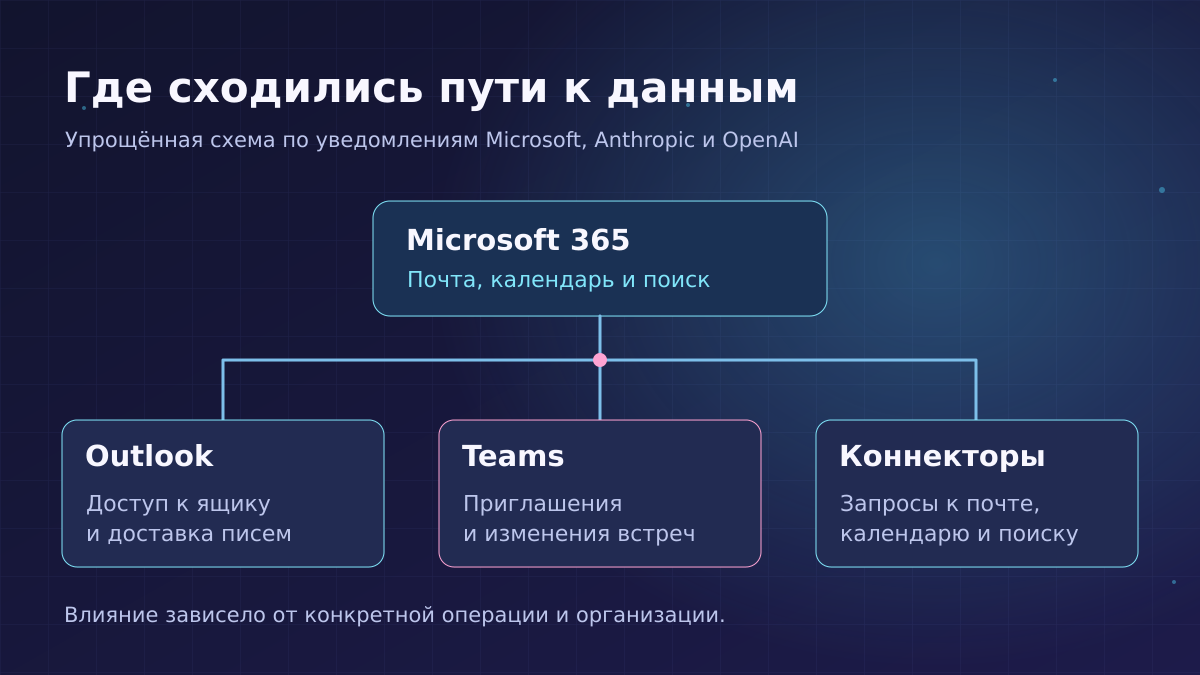
В том же уведомлении Microsoft перечислила отдельные сбои Exchange Online: затруднения с доступом к ящикам из разных клиентов, задержки доставки и тайм-ауты запросов Microsoft Graph к почте, календарю и контактам. У Teams характер воздействия зависел от действия. В сводке Microsoft подключение к большинству обычных звонков и встреч, групповые чаты и сообщения в каналах указаны среди функций, которые в основном продолжали работать. Работа с календарём, приглашениями и редактированием встреч могла давать сбои.
Такую картину увидели и конкретные организации. Служба поддержки японской университетской системы THERS перечислила случаи, которые наблюдала у себя: проблемы с отправкой и получением организационной почты, запуском Outlook и отдельными функциями Teams и SharePoint. Общая карта воздействия нужна для диагностики, а местный журнал отвечает на другой вопрос: какие операции пришлось отложить именно этой организации.
Почему разные приложения дали похожий сбой
Возьмём календарь обычной команды. Встречу можно создать в почтовом клиенте, увидеть в Teams и попросить помощника найти свободное окно. В каждом интерфейсе свои кнопки. Если действие во всех трёх случаях требует прочитать один календарь через один облачный сервис, доступность этой операции определяется общей зависимостью. Голосовой разговор по уже известной ссылке и создание нового приглашения при этом могут попасть в разные группы.
У сторонних интеграций проявилось то же свойство. В отчёте Anthropic о коннекторе Microsoft 365 указано, что с 16:03 UTC 12 ноября по 16:40 UTC 13 ноября многие запросы к инструментам почты, календаря и поиска в коннекторе и Claude для Outlook завершались ошибкой. OpenAI сообщила о нарушениях работы коннектора Microsoft 365: проблемы могли мешать новым подключениям и работе инструментов. Позднее инцидент получил статус решённого.
Из этого следует практический способ читать сводку любой автоматизации. Название приложения даёт точку входа, а название операции помогает найти зависимость. Если помощник говорит, что не смог просмотреть почту, источник проблемы может находиться на пути к ящику. Если поиск вернул пустой список, сотруднику полезно знать, завершился ли сам поиск или коннектор сообщил об ошибке. Для рабочего процесса это разные исходы: в одном случае можно двигаться дальше, во втором проверка всё ещё нужна.
Где запасной канал теряет независимость
Представим небольшую компанию с клиентской поддержкой. В аварийной инструкции есть корпоративный мессенджер для срочных решений. Ссылку на него ищут в почте, список дежурных хранится в облачном документе, а новые сотрудники входят по приглашению, которое тоже приходит письмом. При такой конструкции пользоваться чатом смогут сотрудники, у которых уже есть доступ и контакты. Для дежурного с новым телефоном путь длиннее, даже если сервер мессенджера здоров.
Проверять полезно всю цепочку от возникновения проблемы до подтверждения, что другой человек принял задачу. Кто узнаёт о сбое? Где он берёт актуальные контакты? Может ли связаться с подменным дежурным, если тот никогда не входил с этого устройства? Где обе стороны увидят, какие решения уже приняты? Ответы подсказывают, какие части резерва действительно должны переживать один и тот же отказ независимо.
При этом необязательно держать второй полный офисный пакет. Если в течение нескольких часов нужно только объявить переключение, договориться о смене и подтвердить срочную заявку, достаточно поддерживать доступный маршрут для этих операций. В резервном канале можно ограничиться номером обращения, принятым действием и ответственным. Само содержание корпоративной переписки, вложения и данные клиентов остаются в среде, разрешённой для их обработки.
Самый простой способ заметить скрытую связь — расписать путь для человека, который ещё ничего не знает об инциденте. Он получает первое сообщение, находит контакт дежурного, передаёт номер заявки и получает подтверждение. На каждом переходе можно подписать, где хранятся нужные сведения и чем подтверждается вход. На схеме сразу видно, что запасной чат опирается на тот же справочник, если участники узнают адреса только из офисного портала. Решение иногда сводится к доступной офлайн карточке с ролью дежурного и согласованным способом связи. У карточки должен быть ответственный за обновление: номер человека, который поменял смену или покинул команду, создаёт ещё одну задержку, даже при совершенно исправной сети.
Как провести учебное переключение
Хорошая проверка начинается с конкретной задачи. Например, поступила срочная заявка, ответственным должен стать подменный дежурный, а подтверждение нужно успеть передать до конца смены. Для упражнения достаточно тестового обращения. Участники договариваются считать недоступными Outlook, календарь и подключённого помощника, затем пытаются закончить работу через предусмотренный резерв. Рабочие сервисы ради упражнения отключать не требуется.
Первые минуты покажут многое. Если один участник прислал в общий чат ссылку на план и раздал номера телефонов, стоит проверить, смогли бы люди собрать эти сведения без его участия. Если сообщение прочитали несколько сотрудников, важно увидеть, кто именно принял ответственность. Когда в канале остаётся только отметка об отправке, её слишком легко перепутать с началом работы. Для проверки хватит короткого ответа с именем исполнителя и следующим действием.
Для команды, работающей из разных мест, я бы повторил один сценарий с новым устройством и один со сменой дежурного. На привычном ноутбуке доступ часто уже открыт. Вторая попытка обнаружит, где обычный вход требует подтверждения по почте или где контакт человека хранится только в недоступном справочнике. Результат упражнения удобно записать в трёх строках: какое действие задержалось, от чего оно зависело и кто проверит исправление на следующем прогоне.
Есть смысл проверить и внешний край процесса. Клиент или подрядчик может написать по привычному адресу, пока рабочая группа уже ведёт обсуждение в резерве. Для такого случая достаточно заранее назначить канал для обновлений и человека, который его ведёт. Он сообщает момент следующей проверки и фиксирует поступившие заявки в согласованном месте. Так получатели знают, когда ждать новую информацию, а участники команды могут сверить, кому уже ответили.
Почему зелёный статус ещё нужно сверить с работой
В сохранённых THERS сообщениях Microsoft отдельно описывала задержки, пока обрабатывалась очередь писем. Сотрудник мог снова открыть почтовый ящик раньше, чем туда приходили отложенные сообщения. Для команды, которая уже переключилась на резерв, это неприятный момент: одновременно возвращается старый поток и продолжается работа по новому. Повторная заявка может выглядеть новой, хотя коллега уже разобрал её в запасном канале.
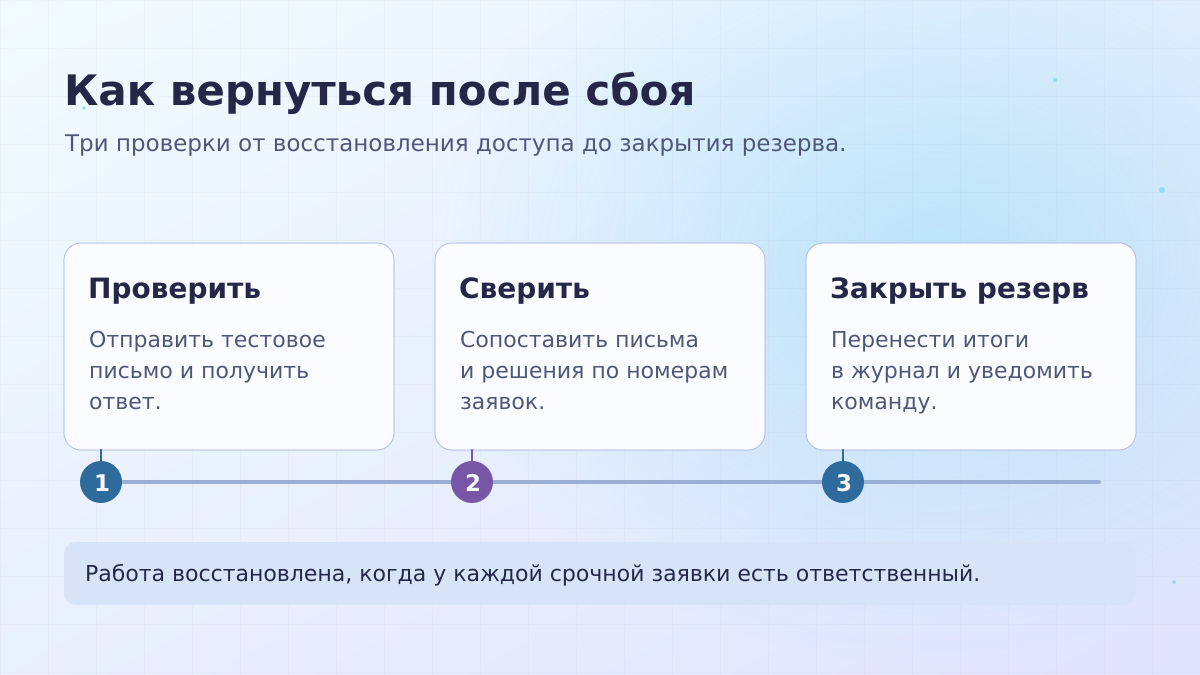
Администратор может сверить состояние сервисов и историю инцидентов в разделе Service health. В инструкции Microsoft по проверке состояния сервисов также указан общедоступный статус на случай, если в центр администрирования войти не удаётся. Статус стоит сопоставить с короткой рабочей проверкой: получить тестовое письмо, ответить и подтвердить получение на другой стороне. Для календаря аналогом будет изменение пробной встречи с проверкой, что обновление видно участнику.
Порядок возврата я бы привязал к проверенным действиям. Если почта заработала, дежурный сверяет срочные заявки, которые приняли во время сбоя. При расхождении сторон сначала подтверждают итог, потом обновляют основной журнал. У почты есть время отправки, у рабочего решения — момент принятия. Поздно доставленное письмо может описывать ситуацию, которую уже успели изменить. Поэтому автоматическая обработка всего накопившегося потока способна вернуть закрытые задачи обратно в работу.
Ещё один случай для сверки — операция, начатая перед потерей соединения. Пользователь нажал «Отправить», приложение долго ждало и показало ошибку. По одному экрану трудно понять, дошло ли письмо или действие осталось в очереди клиента. Для срочного решения проще сверить состояние с получателем по запасному каналу. Тогда команда знает, какую версию считать подтверждённой. В системах учёта ту же роль играет устойчивый номер заявки: заметив две записи с одним номером, сотрудник может сопоставить их по принятым решениям. При большом потоке разумно сначала сверить срочные обращения и явно назначить владельца остального списка. Иначе возврат в офисные приложения перегрузит тех же дежурных, которые только что обрабатывали накопившиеся задачи вручную.
Что смотреть в отчёте и в своём журнале
По сообщениям о восстановлении можно понять, какие сервисы вернулись и какие ограничения ещё снимались. Причины и меры предотвращения повторения составляют отдельную часть разбора. Для владельца рабочего процесса тоже есть две точки отсчёта. Первая — появилось подтверждение, что интернет-сервис снова принимает запросы. Вторая — сотрудники закончили сверять собственные заявки и возобновили обычную работу. У них могут быть разные сроки.
При разборе внутри команды наиболее ценны случаи, которые можно воспроизвести на тестовых данных. Например, вызов прошёл, но новый участник не увидел приглашение. Или человек получил сообщение в запасном канале, однако никто не понял, принял ли он заявку. В первом случае проверяют узнаваемую точку зависимости, во втором уточняют, как подтверждается назначение исполнителя. Оба замечания можно поправить в порядке работы, даже если выбор облачного поставщика уже сделан на годы вперёд.
Ещё я бы сохранил короткую хронологию: когда появилась первая ошибка, кто объявил переключение, какие операции продолжили выполнять и когда закрыли последнюю заявку из временного журнала. Она позволит при следующем обучении проверить, уменьшилось ли время до первого подтверждённого решения. У команды появится собственная мера устойчивости, привязанная к результату, который замечает клиент.
Коротко
Сбой Microsoft 365 показал, что один облачный отказ может менять работу нескольких приложений по-разному. Проверять запасной канал стоит на реальном действии: достать контакты, связаться с дежурным и получить подтверждение назначения. После восстановления нужно проверить доставку и сопоставить накопившуюся почту с временным журналом. Переключение заканчивается, когда срочные решения снова видны в основной системе и по каждой заявке понятно, кто отвечает.
Пока нет комментариев