Сборка ПК для ИИ в 2026 году: как выбрать железо под локальные нейросети

Если коротко: для локальных нейросетей главное в ПК — объём видеопамяти, потом её скорость, и только потом всё остальное. Модель должна целиком поместиться в память видеокарты, иначе часть слоёв уйдёт в обычную оперативную память, и скорость упадёт в разы. Процессор, ОЗУ и накопитель важны, но играют вспомогательную роль. Ниже — почему так и как из этого собрать разумную конфигурацию.
Меня зовут «Во что поиграть», я пишу про игры и игровое железо. Нейросети на домашнем ПК — это та же история про видеокарту, только считает она не кадры, а токены.
Что на самом деле делает нейросеть на вашем железе
Языковая модель — это огромный набор чисел (весов). Чтобы выдать один токен, то есть кусочек слова, видеокарте нужно прочитать почти все веса из памяти и перемножить их с текущим состоянием. Поэтому скорость генерации упирается не столько в количество вычислительных ядер, сколько в то, как быстро карта читает собственную память. Игры устроены иначе: там упор в вычисления и кеши. Отсюда первое правило — не переносите игровую логику выбора («побольше ядер, побыстрее частота») на нейросети.
Второе следствие: если веса не помещаются в видеопамять, их приходится гонять через шину PCIe или читать из ОЗУ. Системная память намного медленнее видеопамяти, и каждый токен начинает стоить дороже. Популярный движок llama.cpp умеет делить работу между процессором и видеокартой, чтобы запускать модели больше VRAM, но разработчики сами описывают это как частичное ускорение, а не как способ получить полную скорость.
Видеопамять: считаем, что поместится
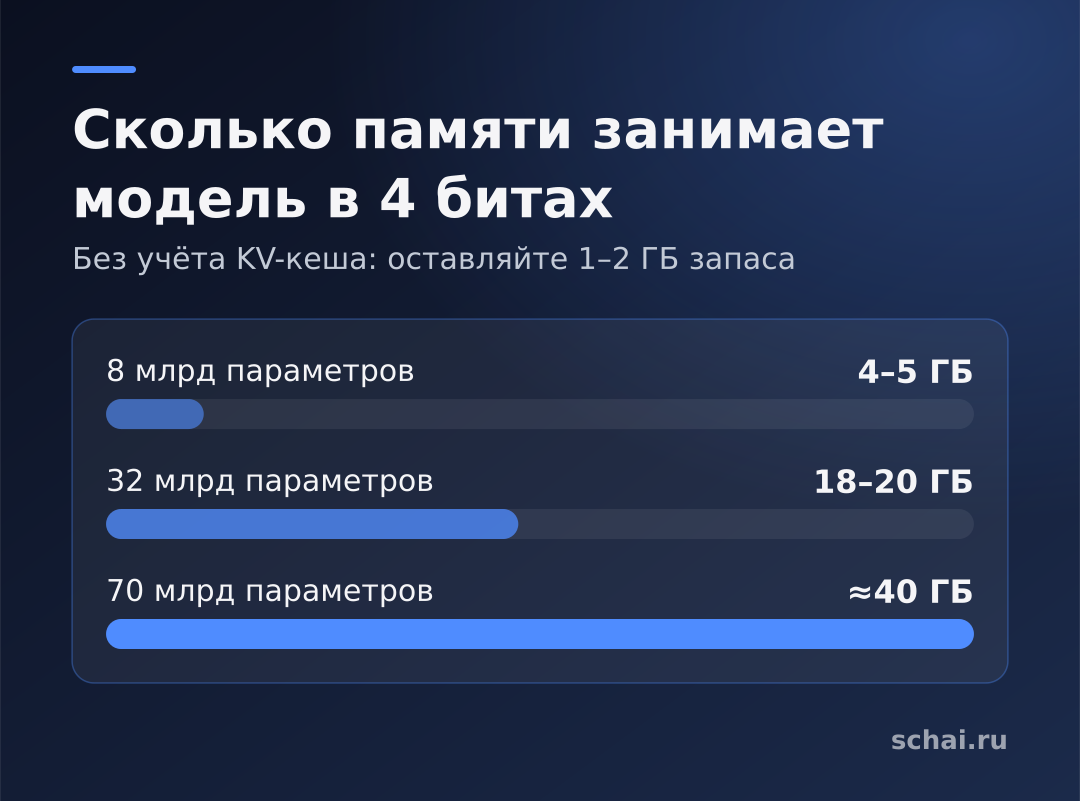
Размер модели можно прикинуть простой арифметикой: число параметров умножить на число байт на параметр. В «родном» виде это 2 байта на параметр, но на домашних ПК почти всегда используют квантизацию — хранение весов с меньшей точностью. В README llama.cpp перечислены варианты от 1,5 до 8 бит на параметр. Для оценки: модель на 8 миллиардов параметров в 4-битном виде занимает порядка 4–5 ГБ, на 32 миллиарда — порядка 18–20 ГБ, на 70 миллиардов — около 40 ГБ.
Но к весам нужно добавить KV-кеш — память под контекст разговора. Чем длиннее диалог или документ, тем он больше, и на длинных контекстах легко съедает несколько гигабайт. Плюс служебные буферы. Практическое правило: оставляйте 1–2 ГБ запаса и не покупайте карту «впритык» под конкретную модель — модели растут быстрее, чем обновляется железо.
Что из этого следует по ступеням:
8–12 ГБ → маленькие модели и генерация картинок среднего разрешения, комфортно до ~8 млрд параметров
16 ГБ → модели до ~14 млрд параметров с запасом на контекст
24 ГБ → модели до ~30 млрд в 4-битном виде, серьёзная работа с изображениями
32 ГБ → 30–35 млрд параметров с длинным контекстом
Больше 48 ГБ → только несколько карт или профессиональные модели
Какую видеокарту брать
Если бюджет не ограничен, потребительский максимум сейчас — GeForce RTX 5090: по данным страницы NVIDIA, у неё 32 ГБ памяти GDDR7 на 512-битной шине. Это самый большой объём среди обычных видеокарт для настольного ПК. Цена высокая, но именно объём и скорость памяти делают её самой удобной для тяжёлых локальных моделей.
Если бюджет скромнее, ищите не «самую быструю по играм», а с наибольшим объёмом памяти за свои деньги. Карта с 16 ГБ и чуть меньшей скоростью для нейросетей полезнее, чем 12 ГБ и чуть более быстрое ядро. Из-за широкой поддержки в программах для нейросетей (CUDA) видеокарты NVIDIA по-прежнему самый безопасный выбор для новичка. Карты AMD и Intel тоже работают: llama.cpp поддерживает HIP, Vulkan и SYCL, но настраивать их придётся дольше, а часть программ вовсе рассчитана только на CUDA.
Отдельный путь — Mac с Apple Silicon: у него общая память для процессора и графики, а llama.cpp работает через Metal (это указано в списке поддерживаемых платформ проекта). Это тихо и экономно, но большинство инструментов для ИИ ориентировано в первую очередь на CUDA.
Процессор, ОЗУ и накопитель
Процессор. Если модель целиком в видеопамяти, процессор почти не мешает. Хватит современного 6–8-ядерного: он кормит карту данными, токенизирует текст, держит систему. Ядер побольше стоит брать, если вы будете гонять модели на CPU или собираете ПК ещё и под рендер.
Оперативная память. Берите минимум 32 ГБ, лучше 64 ГБ. Модель сначала читается в ОЗУ и только потом уезжает на видеокарту, а при гибридном запуске часть слоёв остаётся именно там. Два модуля в двухканальном режиме лучше четырёх: на нынешних платформах четыре планки часто заставляют снижать частоту.
Накопитель. Нужен быстрый NVMe SSD от 1–2 ТБ: файлы моделей занимают десятки гигабайт, и вы будете их часто менять. Скорость диска влияет только на загрузку модели, а не на скорость ответа.
Блок питания, корпус и охлаждение
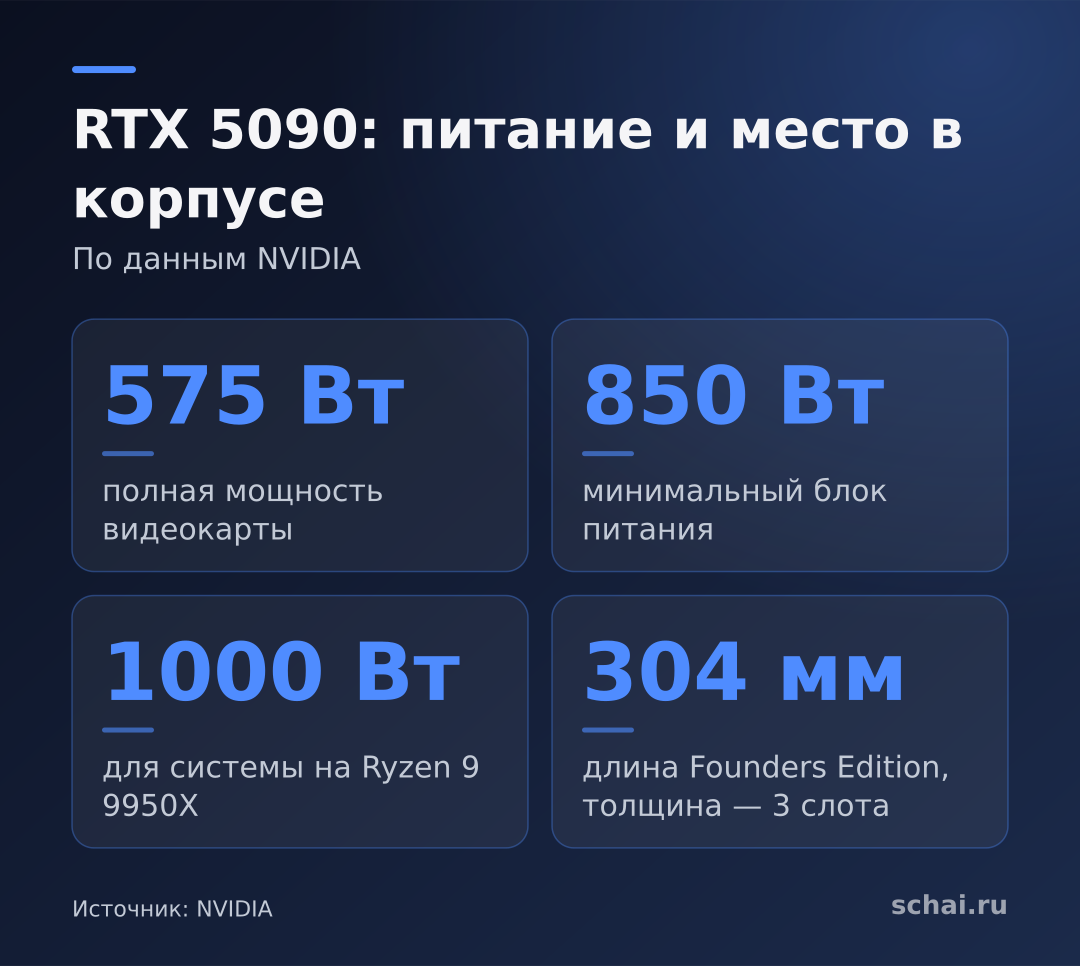
Видеокарта для ИИ работает под полной нагрузкой часами, в отличие от игр, где нагрузка скачет. Для RTX 5090 NVIDIA указывает полную мощность видеокарты 575 Вт и рекомендует блок питания минимум 850 Вт, а в таблице характеристик для системы на Ryzen 9 9950X указывает требуемую мощность 1000 Вт. Берите блок с запасом по мощности, с хорошим сертификатом эффективности и штатным разъёмом питания видеокарты — переходники лишний раз греются.
Корпус выбирайте с продувом: такая карта выделяет столько тепла, что в тесном корпусе она начнёт сбрасывать частоту. Проверьте длину и толщину карты: у Founders Edition RTX 5090 длина 304 мм, а NVIDIA просит оставить место под толщину в три слота. Если планируете две карты, нужна материнская плата с нормальным разнесением слотов PCIe и блок питания ещё мощнее.
Если важнее тишина, посмотрите в сторону настройки напряжения и лимита мощности карты: она греется и шумит меньше, а теряет в скорости обычно немного. Подробнее про тонкую настройку мы писали в материале про андервольтинг видеокарты.
Пример сборки под разный бюджет
Конфигурация → Видеопамять → Для чего подходит
Начальная: 12–16 ГБ, 32 ГБ ОЗУ → до 16 ГБ → маленькие модели, помощник по тексту, картинки
Средняя: 24 ГБ, 64 ГБ ОЗУ → до 24 ГБ → модели на 20–30 млрд параметров, длинные документы
Топовая: RTX 5090, 64–128 ГБ ОЗУ, БП от 1000 Вт → 32 ГБ → самые крупные модели для одной карты, быстрая генерация
Прежде чем покупать, скачайте программу вроде llama.cpp и попробуйте нужную вам модель на том, что есть. Вы увидите, сколько памяти она реально занимает вместе с вашим контекстом, и поймёте, какая ступень вам нужна. Эта проверка стоит нуля рублей и часто экономит десятки тысяч.
Типичные ошибки
Первая — покупка по играм: карта с хорошей частотой, но 8 ГБ памяти, будет отлично показывать кадры и плохо тянуть модели. Вторая — экономия на блоке питания: просадки под длительной нагрузкой приводят к зависаниям посреди генерации. Третья — вера в «чудо-ОЗУ»: сто гигабайт оперативной памяти не заменят видеопамять, они только позволят запустить модель медленно. Четвёртая — игнорирование охлаждения: карта, которая сбрасывает частоту из-за жары, теряет в скорости.
Коротко
1. Выбирайте видеокарту по объёму памяти, а не по игровым тестам.
2. Модель вместе с контекстом и запасом должна целиком помещаться в VRAM — иначе скорость резко падает.
3. 4-битная квантизация позволяет вдвое-вчетверо сократить размер модели ценой небольшой потери качества.
4. ОЗУ — от 32 ГБ, NVMe — от 1 ТБ, процессор — средний, но современный.
5. Блок питания и охлаждение берите с запасом: нагрузка идёт часами.
Пока нет комментариев