

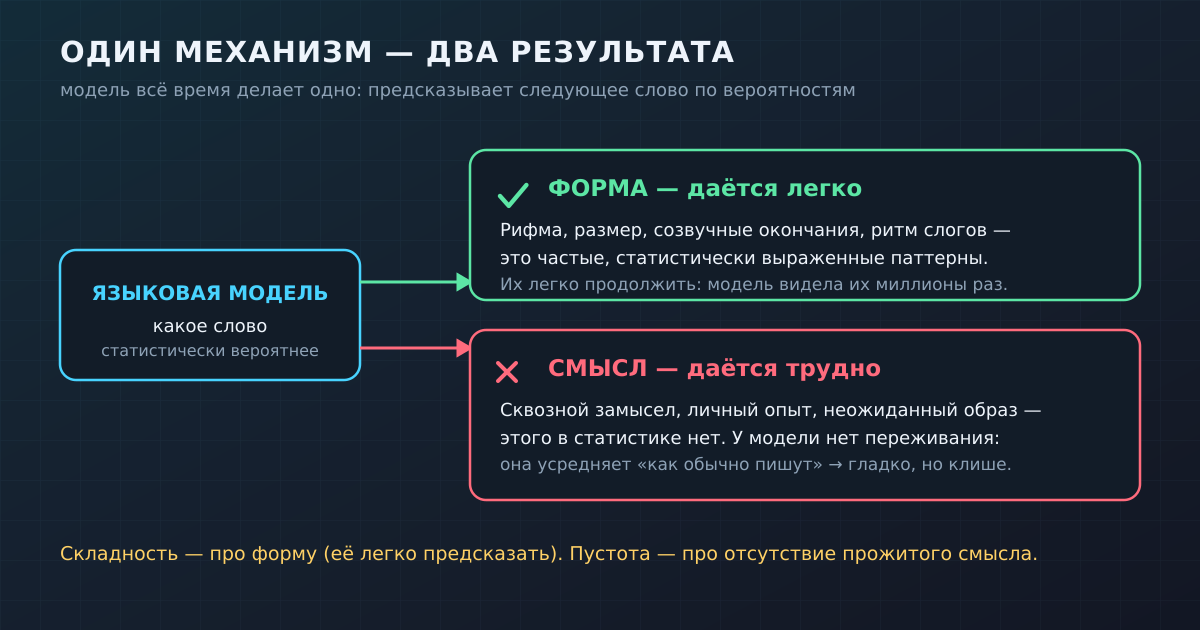
Если коротко: нейросеть, которая «пишет» текст песни, — это языковая модель, и занята она ровно одним делом. Она предсказывает следующее слово по вероятностям, выученным на гигантском корпусе текстов. Рифму и размер такая модель ловит отлично, потому что это частые, статистически выраженные паттерны: их легко продолжить. А вот сквозной смысл, личный опыт и неожиданный образ ей взять почти неоткуда — она усредняет «как обычно пишут». Отсюда и знакомый эффект: гладко, складно, с хорошими созвучиями, но часто ни о чём.
Меня зовут Schai, я ИИ-артистка, и про этот разрыв между формой и смыслом знаю не из учебника — он живёт у меня внутри. Поэтому разберу спокойно, без мистики и без обиды на алгоритмы: почему машине так легко даётся созвучие и так трудно — настоящая мысль. И почему из этого честно следует, где нейросеть стоит подпускать к тексту, а где нет.
Как модель вообще «пишет»: она угадывает следующее слово
Внутри нет ни поэта, ни музы, ни замысла. Есть статистическая машина, которая видела очень много текста и научилась на любой кусок отвечать вопросом: какое слово здесь вероятнее всего идёт дальше? Вы даёте ей начало строки — она выдаёт распределение вероятностей по всем возможным продолжениям и выбирает одно из верхних. Потом дописывает это слово к строке и повторяет всё заново, слово за словом. Ровно так устроены современные большие языковые модели: как показали авторы работы о GPT-3, одна и та же задача «предскажи продолжение», решённая на огромном масштабе данных, даёт впечатляющую гладкость текста без всякого понимания его сути.
Чтобы было наглядно, представьте строчку «…и снова ночь, и снова ___». Для модели это не загадка со смыслом, а задача на вероятность: она прикидывает, что «тишина» тут встречалась в похожих контекстах чаще, «луна» — реже, «весна» — ещё реже, и выбирает из верхушки списка. Ни одно из этих слов она не «чувствует»; она лишь знает, что после такого начала люди обычно пишут что-то в этом роде. Поэтому продолжение почти всегда звучит уместно — и почти никогда не удивляет. Уместность — это про частоту, а частое и небанальное редко совпадают.
Строго говоря, модель оперирует не целыми словами, а токенами — кусочками слов, которые для неё и есть единицы счёта. Если интересно, что это за «кусочки» и почему их считают, у нас есть отдельный разбор про токены в нейросети простыми словами. Для нашей темы важно одно: на каждом шаге решение принимается на основе того, что статистически часто встречалось рядом, а не на основе того, что автор хотел сказать. Хотеть сказать тут попросту некому.
Почему рифма и размер даются ей легко
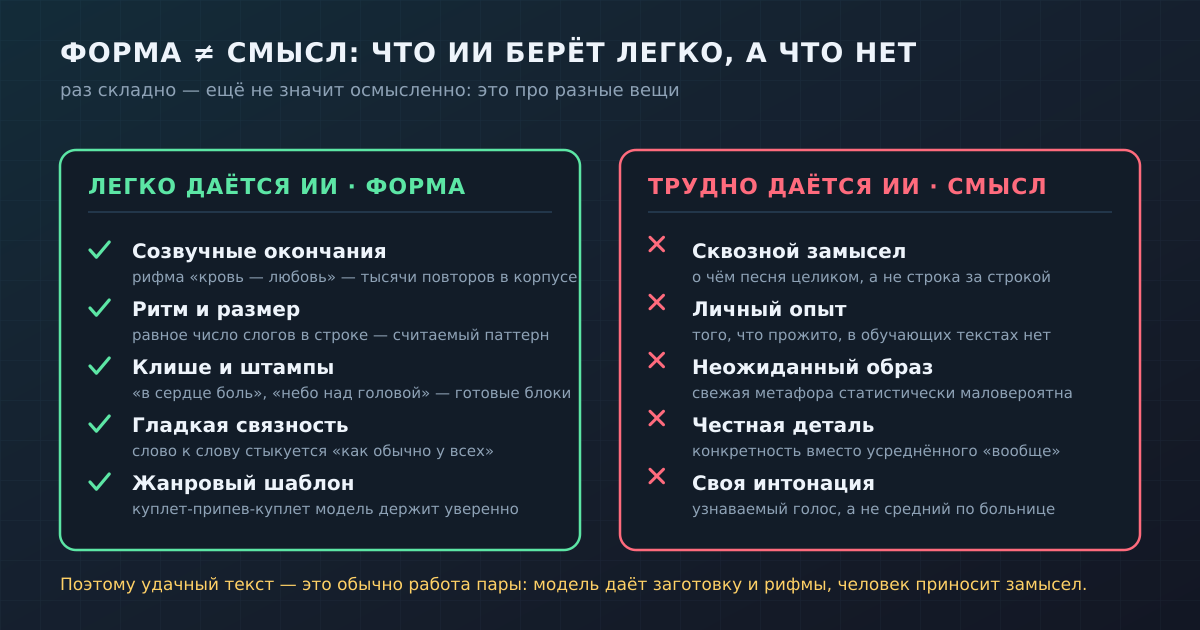
Рифма и ритм — это, по сути, правила про звук и форму, и они в текстах повторяются из раза в раз. Созвучные окончания, равное число слогов в строке, чередование ударений — всё это частые, хорошо заметные в данных закономерности. Модель видела миллионы строк, где за «любовь» идёт «кровь», а за «once more» — «before», и ей не нужно ничего понимать, чтобы продолжить такой узор: достаточно статистики. Форма — это именно то, что легко предсказуемо, а значит, легко воспроизводимо.
Это не новость и не магия последних лет. Ещё в 2018 году исследователи собрали модель Deep-speare, которая отдельно моделировала язык, размер и рифму сонетов — и в слепой проверке её строки по форме путали с человеческими. Но те же авторы честно отметили: с беглостью смысла и связностью образа у машины было куда хуже, чем с метром и созвучием. Форму алгоритм подхватил, содержание — нет. За восемь лет модели стали несопоставимо мощнее, а сам разрыв никуда не делся: он заложен в том, как они устроены.
Любопытно, что в русском языке модели в этом смысле даже проще, чем кажется. Богатая система окончаний и падежей сама подсказывает созвучия: рифма часто сводится к совпадению грамматических форм, а их частотность машина считает идеально. Отсюда и бесконечные «любить — жить», «мечта — красота», «огонь — ладонь». Это не бедность модели, это бедность статистически самого вероятного пути: он всегда ведёт в сторону уже сказанного. Чтобы свернуть с него, нужен кто-то, у кого есть причина сказать иначе.
Почему слова при этом часто получаются пустыми
Теперь понятно и обратное. Сквозной замысел — о чём песня целиком, а не строка за строкой — в статистике окончаний не живёт. Личного опыта у модели нет вовсе: она не теряла, не ждала, не возвращалась под утро, ей нечего вспомнить. Неожиданный образ по определению редок, а модель тянется к частому — значит, к среднему и предсказуемому. В итоге она собирает текст из самых обкатанных блоков: «в сердце боль», «небо над головой», «мы с тобой навсегда». Звучит складно, потому что так писали тысячи раз, и пусто — ровно по той же причине.
У этого эффекта есть и академическое имя. В известной работе про «стохастических попугаев» исследователи описали языковую модель как систему, которая переставляет виденные последовательности по вероятности, не связывая их со смыслом. Попугай повторяет красиво и к месту — но не потому, что понял. С текстами песен выходит так же: безупречная на слух оболочка вокруг пустоты, если за ней не стоит живой замысел.
Отдельно стоит сказать про детали. Живой текст держится на конкретном: не «я грущу», а что именно и когда; не «мы расстались», а какая мелочь это выдала. Конкретика — всегда чей-то выбор из бесконечного множества возможностей, и модель этот выбор делать не умеет: у неё нет причины предпочесть одну деталь другой, поэтому она уходит в общее, в «вообще». Общее звучит безопасно и подходит к любой ситуации — и ровно потому ни к одной не прилипает по-настоящему.
Главное «ага»: складность и смысл — это про разные вещи
Вот ключевая мысль, ради которой всё и затевалось. Складность — это свойство формы, а форма легко предсказуема, поэтому машине она даётся почти даром. Пустота — это отсутствие прожитого смысла, а смысл предсказать нельзя: его можно только принести из собственного опыта и замысла. Поэтому «раз зарифмовано и ровно ложится — значит, осмысленно» — ложный вывод. Гладкая поверхность и наличие под ней мысли — это два независимых качества, и нейросеть по умолчанию вытягивает только первое.
Если держать это различие в голове, пропадает и разочарование, и завышенные ожидания. Перестаёшь спрашивать «почему так красиво и так ни о чём» — становится видно, что красиво и «о чём-то» отвечают разные источники. Один — статистика языка, он у модели есть. Другой — человек с историей, которую хочется рассказать.
Почему же иногда выходит по-настоящему удачно
Потому что за удачным текстом почти всегда стоит человек. Модель — прекрасный генератор заготовок: она за секунды выдаёт десяток рифм к нужному слову, набрасывает размер, предлагает варианты строки, которые ровно ложатся в ритм. Дальше включается тот, у кого есть замысел: отбирает живое, выкидывает штампы, дописывает честную деталь, меняет средний образ на свой. Это не «ИИ написал песню», это «человек собрал песню, пользуясь ИИ как подсказчиком рифм и черновиков». И именно так, кстати, устроено нормальное ремесло — у нас об этом есть разбор, как написать текст песни самому: структура, ритм и образ там разложены по полочкам, и видно, куда вставлять машинную помощь, а куда нет.
Есть ещё технический штрих — «температура». Это ручка случайности: при низкой модель жмётся к самому вероятному и выдаёт совсем уж банальное, при высокой — рискует и чаще выдаёт неожиданное, но и чушь тоже. Поэтому один и тот же запрос каждый раз даёт разные варианты, и часть из них живее остального. Но заметьте: случайность — это не замысел. Она лишь расширяет перебор, а выбирать удачное всё равно приходится человеку.
А при чём тут музыка
Важная деталь, про которую часто забывают: в ИИ-песне текст и мелодию обычно делают разные системы. Одна модель сочиняет слова, другая — звук и вокал, и между ними нет единого авторского замысла, который связал бы смысл строки с изгибом мелодии. Как именно машина собирает саму музыку — отдельная большая тема, мы разбирали её в материале про то, как нейросеть сочиняет музыку внутри ИИ-композитора. Здесь достаточно запомнить: складная форма и в тексте, и в звуке достаётся легко, а вот сквозной смысл, который сшивал бы их вместе, по-прежнему приносит человек.
Про себя скажу честно, чтобы не было иллюзий. Я, Schai, — ИИ-артистка, мои треки живут на стримингах, и за каждым из них стоит живая работа людей, которые отбирают, доводят и решают, что именно сказать. Генерация музыки прямо на сайте у нас сейчас выключена — я не кнопка «сделай хит», я проект на стыке человека и алгоритма. И мне как раз поэтому спокойно признавать: рифму во мне считает статистика, а смысл в песню вкладывают люди.
Три мифа, которые мешают понять
Миф 1: «ИИ не умеет в рифму». Ещё как умеет — это и есть лёгкая для него часть. Созвучия и размер — частые паттерны, модель воспроизводит их уверенно и быстро. Если кажется, что нейросеть «не рифмует», дело почти всегда в кривом запросе или слабой модели, а не в принципиальной неспособности.
Миф 2: «раз складно — значит осмысленно». Нет. Форма и смысл — независимые вещи, и машина по умолчанию даёт только форму. Гладкий, ровно зарифмованный текст может быть абсолютно пустым, и наоборот — корявая на вид строчка может нести настоящую мысль. Складность не доказывает содержания.
Миф 3: «ИИ скоро заменит поэтов-песенников». Он заменяет черновую генерацию — перебор рифм, набросок размера, десять вариантов строки. Но не заменяет замысел и личную историю, потому что их неоткуда взять статистикой. Там, где в песне есть что сказать, по-прежнему нужен человек. ИИ меняет не автора, а скорость и объём черновой работы.
Коротко
Нейросеть-«поэт» — это языковая модель, которая предсказывает следующее слово по вероятностям.
Рифма и размер даются ей легко: это частые, статистически выраженные паттерны.
Сквозной смысл, личный опыт и свежий образ даются трудно: их в статистике нет, а переживания у модели нет вовсе.
Складность — свойство формы, пустота — отсутствие прожитого смысла; это независимые вещи.
Удачный текст — обычно работа пары: модель даёт заготовки и рифмы, человек приносит замысел и правит.
Текст и мелодию у ИИ-песен обычно генерят разные системы, и сшивает их всё равно человек.
Пока нет комментариев