Если коротко: мировая модель — это нейросеть, которая учится предсказывать, как меняется окружающий мир после действия, а не просто продолжать текст. Языковая модель знает, какое слово обычно идёт следом. Мировая модель знает, что будет, если толкнуть чашку: она упадёт. Поэтому в неё вкладывают надежды на роботов, беспилотные машины и игровые симуляторы. Но «понимание реальности» здесь пока в кавычках: это хорошее предсказание, а не доказанное понимание.
Меня зовут Кира Нейман, я пишу про нейросети по-человечески. Термин «мировые модели» в 2025–2026 годах звучит на каждом углу, и за ним прячется сразу несколько разных идей. Разберём, что в них общего и где заканчивается маркетинг.
Что такое мировая модель простыми словами
У человека в голове есть внутренняя картина мира. Вы не рассчитываете траекторию мяча по формулам, но рука заранее знает, куда он прилетит. Вы мысленно проигрываете ситуацию и выбираете действие. Мировая модель в машинном обучении делает то же самое: хранит сжатое представление среды и умеет прогнозировать её следующее состояние при заданном действии.
Идея не новая. Ещё в 2018 году Дэвид Ха и Юрген Шмидхубер опубликовали работу Recurrent World Models Facilitate Policy Evolution. В ней агент сам учит генеративную модель среды без разметки, а затем небольшой контроллер принимает решения, опираясь на её признаки. Устройство простое: компонент V (на вариационном автокодировщике) сжимает кадр в короткий вектор, компонент M (рекуррентная сеть) предсказывает следующий вектор по действию, а крошечный контроллер C выбирает, что делать. В одном из экспериментов контроллер обучали целиком внутри «сна» модели, а потом переносили в настоящую среду.
Из этой работы стоит запомнить главное: мировая модель нужна не для красивой картинки, а чтобы агент мог тренироваться и планировать, не рискуя в реальности.
Чем это отличается от языковой модели
Большая языковая модель обучена предсказывать следующий токен в тексте. Текст — это уже человеческий пересказ мира, причём неполный. Модель может уверенно описать, как устроен шарнир, но никогда не держала его в руках и не видела, как он движется. Из-за этого такие системы ошибаются там, где нужна физика: пространственные задачи, причинно-следственные цепочки, длинные планы.
Мировая модель обучается на данных о том, как мир изменяется: видео, показания датчиков, действия агента. Её задача — прогноз состояния, а не слова. Различаются подходы к тому, что именно предсказывать, и здесь начинается главный спор в отрасли.
Два лагеря: предсказывать пиксели или смыслы
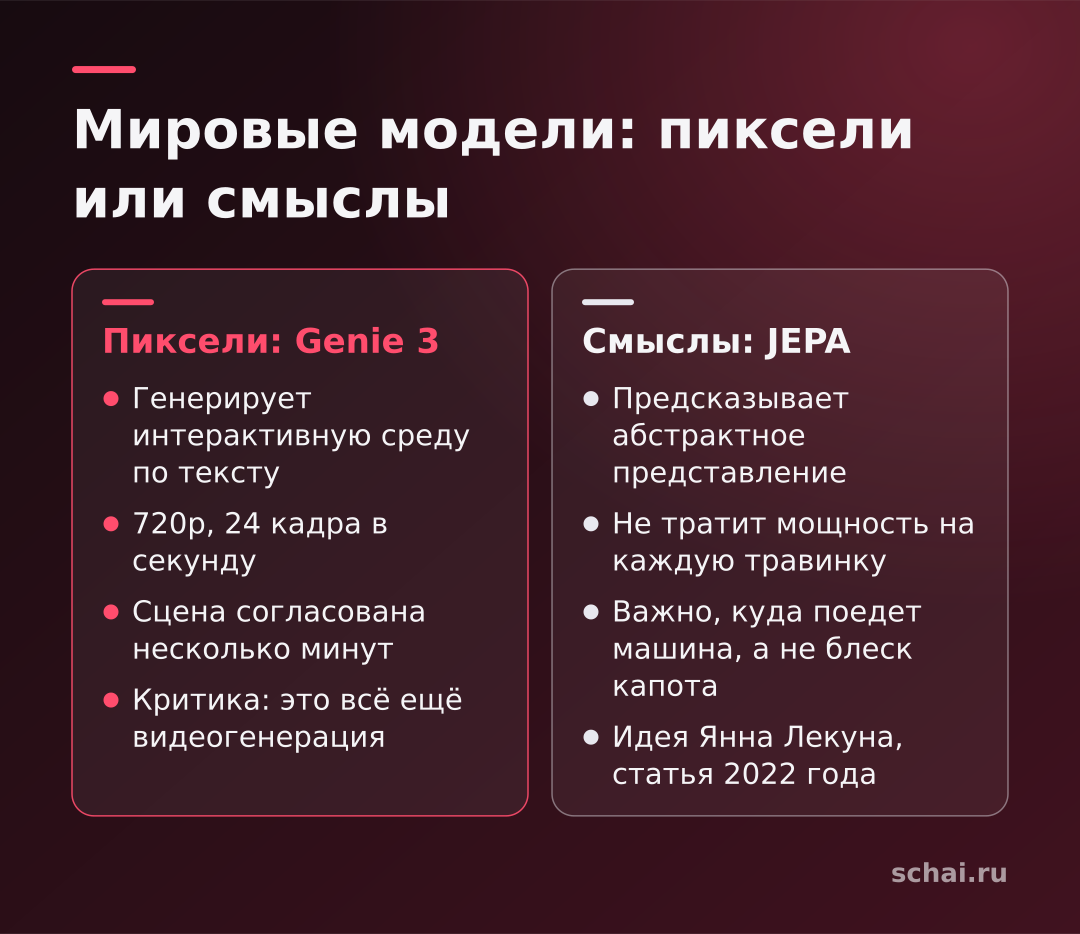
Первый лагерь генерирует картинку. Показательный пример — Genie 3 от Google DeepMind. По описанию самой DeepMind, модель по текстовому запросу создаёт интерактивную среду, по которой можно перемещаться в реальном времени, в разрешении 720p и при 24 кадрах в секунду. Окружение остаётся согласованным в течение нескольких минут, а зрительная память достигает примерно минуты назад. Там же честно перечислены ограничения: агент может выполнять ограниченный набор действий, нельзя точно воспроизвести реальные места, а читаемый текст обычно появляется, только если его задали в запросе.
Второй лагерь не хочет рисовать каждый пиксель. Янн Лекун, один из пионеров глубокого обучения, предлагает архитектуру JEPA: модель предсказывает не сырой кадр, а его абстрактное представление. Довод в том, что мир полон шума (листья на ветру, текстура асфальта), и тратить мощность на прогноз каждой травинки бессмысленно. Важно предсказать, что машина поедет прямо, а не как именно заблестит её капот. Лекун изложил это видение в позиционной статье 2022 года «A Path Towards Autonomous Machine Intelligence».
Кто прав, пока неизвестно. Критики Genie 3 указывают, что внутри это всё ещё видеогенерация, а не физика и причинность. Сторонники пиксельного подхода отвечают, что только он даёт интерактивные миры, на которых можно массово тренировать агентов. Вероятно, победит гибрид.
Где мировые модели нужны на практике
Первое применение — роботы. Обучать робота на реальных попытках дорого и опасно. Если есть модель, которая правдоподобно воспроизводит последствия действий, можно прогнать миллионы «снов» и только потом проверять лучшие варианты на железе. Ровно эта идея стояла за работой Ха и Шмидхубера.
Второе — беспилотный транспорт. Автомобилю важно предсказывать поведение других участников движения: пешеход на краю тротуара, соседняя машина с включённым поворотником. Модель, умеющая «проиграть» сцену на несколько секунд вперёд, помогает планировать манёвр.
Третье — игры и симуляторы. Интерактивные миры по текстовому описанию уже сегодня выглядят как прототип нового жанра, хотя пока это минуты, а не часы игры, как следует из ограничений Genie 3.
Четвёртое — ассистенты, которые должны разбираться в физическом окружении: помощник на очках или телефоне, который понимает, что происходит в кадре, а не только распознаёт предметы. Здесь мировые модели пока остаются скорее направлением исследований, чем продуктом.
Почему именно сейчас и что мешает
Мировые модели вышли на первый план по простой причине: рост языковых моделей упирается в доступные тексты. Интернет конечен, а видео, записи с камер роботов и симуляции — почти неисчерпаемый источник данных о том, как вещи двигаются и взаимодействуют. Если научиться извлекать из них законы поведения мира, у ИИ появляется новый вид опыта, которого нет в книгах.
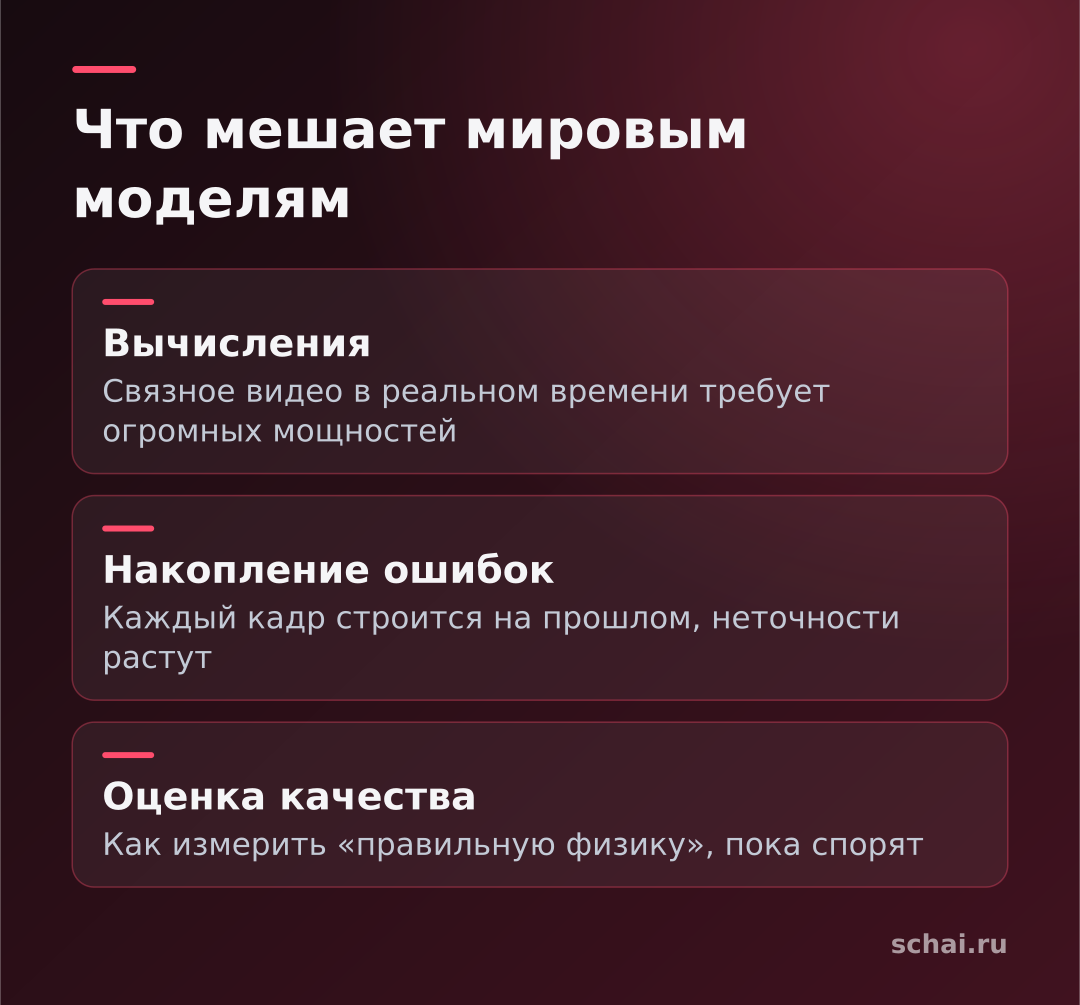
Мешает несколько вещей. Во-первых, вычисления: генерировать согласованное видео в реальном времени требует огромных мощностей, и неслучайно Genie 3 держит связную сцену лишь несколько минут. Во-вторых, накопление ошибок: каждый новый кадр строится на предыдущем, и мелкая неточность за сотни кадров превращается в странный мир, где предметы меняют форму. В-третьих, оценка качества: у языковых моделей есть тесты, а как измерить «правильную физику» сцены, учёные до сих пор спорят.
Для обычного пользователя вывод такой: в ближайшие годы мировые модели скорее появятся внутри продуктов, чем станут отдельным приложением. Вы заметите их по тому, что робот-пылесос меньше врезается в мебель, а навигация в сложной обстановке становится аккуратнее. Громкие обещания про «ИИ, который понимает реальность», стоит воспринимать как цель отрасли, а не как готовое свойство.
Понимает ли модель реальность на самом деле
Честный ответ: неизвестно, и это зависит от определения понимания. Модель может блестяще предсказывать видео и всё равно не знать, что стеклянный стакан разобьётся, если его уронить на камень: она лишь повторяет статистику виденного. Проверить это трудно, потому что в тренировочных данных почти всегда есть похожие сцены.
Практическое следствие для пользователя простое. Не принимайте красивую симуляцию за физический расчёт. Если вам важна точность (инженерия, медицина, безопасность), проверяйте результат специализированными инструментами. Мировая модель даёт правдоподобие, а не гарантию.
О близкой теме — почему нейросети уверенно ошибаются, — у нас есть отдельный разбор. Он хорошо дополняет эту статью.
Коротко
Мировая модель предсказывает, как изменится среда после действия. Идея появилась в 2018 году у Ха и Шмидхубера и сегодня развивается в двух направлениях: генерация интерактивного видео (Genie 3) и предсказание абстрактных представлений (JEPA Лекуна). Применять её собираются в робототехнике, беспилотниках, играх и ассистентах. Но правдоподобие картинки не равно пониманию физики, поэтому важные выводы по-прежнему нужно перепроверять.
Пока нет комментариев