Как работает распознавание речи: почему ассистент не понимает с первого раза

Если коротко: голосовой ассистент не «слышит слова» — он получает поток звуковых колебаний и выбирает самый вероятный текст, который мог бы так звучать. Когда звук чистый, а фраза длинная и предсказуемая, выбор почти всегда верный. Когда вокруг шум, слово редкое, а реплика короткая, вариантов остаётся несколько, и система может выбрать не тот. Поэтому с первого раза не получается чаще всего не из-за «глупого слуха», а из-за нехватки сигнала или контекста — и обе нехватки можно закрыть.
Это канал «Всё про ИИ и Роботов». Мы любим брать бытовую досаду — «опять не так записал!» — и показывать, какой механизм за ней стоит. Сегодня на очереди диктовка и голосовые помощники.
Что на самом деле получает программа вместо вашего голоса
Для компьютера речь — это не слова, а колебания давления воздуха. Микрофон превращает их в ряд чисел. Например, Whisper — открытая модель распознавания речи от OpenAI — работает с аудио, приведённым к 16 000 замеров в секунду, из которого строится 80-канальная спектрограмма: картинка, где по одной оси время, по другой частоты, а яркость показывает громкость. Если вы когда-нибудь видели «отпечаток» звука в аудиоредакторе — это оно.
Никаких букв здесь нет. «П», «р», «и» не лежат в звуке отдельными кирпичиками: звуки перетекают друг в друга, гласные в безударных слогах смазываются, слова слипаются в один поток без пауз. Задача системы — по этой разноцветной картинке написать текст, который человек счёл бы верным.
Раньше эту задачу решали цепочкой отдельных блоков: акустическая модель отвечала за «какой это звук», словарь произношений — за «из каких звуков состоит слово», языковая модель — за «какие слова вообще идут рядом». Каждый блок настраивали вручную. Новая волна начиналась с работы Deep Speech, где авторы показали, что сквозная нейросеть обходится без фонемного словаря и даже без самого понятия «фонема», а шум, эхо и разброс голосов она учится переносить прямо из данных, а не из ручных правил.
Как работает распознавание речи: от колебаний воздуха к тексту
Современная модель вроде Whisper — это encoder-decoder Transformer. Название страшное, идея простая: две нейросети, которые работают в паре.
Первая, энкодер, смотрит на спектрограмму и вытаскивает из неё устойчивые признаки: «тут шипящий», «тут гласный», «тут пауза». Вторая, декодер, пишет текст по одному кусочку слова за раз. Но пишет не «что услышал», а «что вероятнее всего идёт дальше, если звук такой, а уже написано вот это». Фактически декодер — это языковая модель, которой подсунули звук как подсказку. Тот же принцип, что и у чат-ботов, о которых мы рассказывали в разборе про токены в нейросети: текст складывается из кусочков, и каждый следующий кусочек выбирается по вероятности.
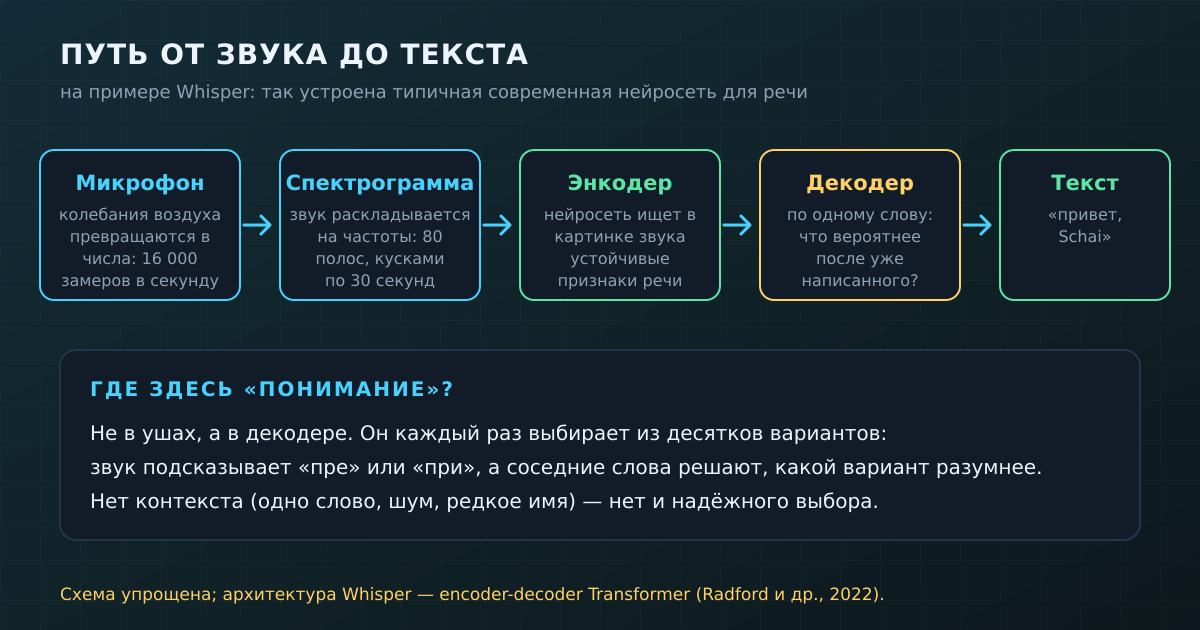
Есть и техническая оговорка: Whisper обрабатывает аудио кусками по 30 секунд, а длинные записи режет на такие окна. Поэтому на стыках иногда рождаются странности: фраза оборвалась на полуслове, и модели досталось мало контекста.
«Ага!»: ассистент не слышит, он выбирает из вариантов
Вот главный момент, после которого всё встаёт на место. Возьмите на слух фразы «придать значение» и «предать значение»: произнесённые бегло, они звучат почти одинаково. Безударные «е» и «и» в русской речи сближаются, и никакой, даже самый чуткий микрофон, не отличит одно от другого. Человек отличает по смыслу: «придать значение» бывает, «предать значение» — нет.
Для нейросети работает точно такой же механизм. Звук даёт ей несколько правдоподобных кандидатов, а контекст — первые слова фразы, тема разговора, соседние предложения — определяет, какой из них победит. Авторы Whisper прямо пишут, что их декодер — это «языковая модель, зависящая от аудио», и что его обучали учитывать историю уже расшифрованного текста: прошлые фразы подсказывают следующие.
Распознавание речи — не слух, а правдоподобная догадка. Чем меньше подсказок, тем выше шанс промаха.
Отсюда ответ на вопрос из заголовка. Скажите ассистенту одно короткое слово — и ему не на что опереться, кроме самого звука. Скажите «позвони маме и скажи, что я задержусь» — и тот же ассистент угадает всё с первого раза: каждое слово подсказывает соседей. Нет, он не стал умнее за секунду. Просто вариантов стало меньше.
Шум, акцент и редкие слова: где система ошибается чаще всего
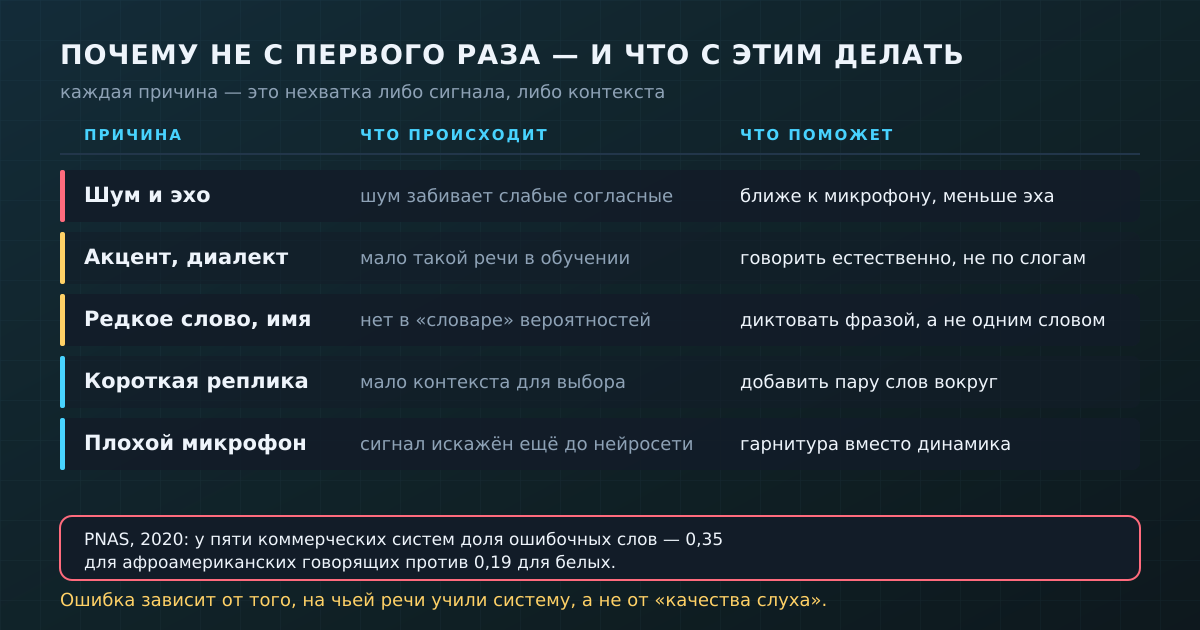
Шум и эхо
Шум закрывает самые слабые части речи — согласные, особенно глухие «с», «ф», «т», «п». Они часто различают похожие слова, и когда их затёрло, остаются гласные: слишком мало, чтобы однозначно выбрать слово. Современные модели с шумом справляются заметно лучше старых: в проверке на аддитивном шуме Whisper обгонял другие модели при сильных помехах (отношение сигнал/шум ниже 10 дБ), при слабом шуме же ряд других моделей были не хуже. Но «лучше» не значит «безупречно».
Акцент и диалект
Здесь причина не в ушах, а в обучении. Система хорошо понимает ту речь, которой её кормили. В работе, опубликованной в PNAS, исследователи прогнали через пять коммерческих систем распознавания интервью с афроамериканскими и белыми американскими говорящими: средняя доля ошибочных слов была 0,35 против 0,19. Авторы связали это именно с акустическими моделями и предложили включать в данные больше разнообразной речи.
Для нас с вами вывод тот же: региональный говор, региональные слова, быстрая «смазанная» речь — всё это точки, где в обучающих данных было меньше примеров. Это не вина говорящего.
Редкие слова, имена и термины
Название вашего района, фамилия коллеги, внутренний термин из вашей работы — для модели это слова с низкой априорной вероятностью. Она слышит «что-то похожее на...» и выбирает ближайшее частое слово. Поэтому диктовка так любит превращать «Schai» в нечто совсем другое: слово встречалось в данных слишком редко, а похожих на слух вариантов хватает.
Почему первые слова фразы страдают чаще всего
У декодера есть неудобная особенность: пока он не написал ни одного слова, ему не на что опираться, кроме звука. Первое слово фразы — самый «голый» момент. Если вы начали говорить ещё до того, как микрофон включился, или сказали «э-э» и вдохнули, система получает обрезанный или шумный кусок и первой же догадкой может промахнуться. Потом цепочка идёт увереннее: каждое новое слово опирается на предыдущие.
Отсюда простая привычка: сначала дождитесь, пока индикатор записи покажет «слушаю», и только потом говорите. А если первые слова повторяются с ошибкой, часто хватает сказать фразу целиком ещё раз — второй заход начнётся с готовой опоры в виде вашего же запроса.
Почему «процент ошибок» — не вся правда
Качество распознавания обычно измеряют долей ошибочных слов (WER): сколько слов пришлось заменить, добавить или удалить, чтобы получить эталон. Метрика честная, но придирчивая. Авторы Whisper отмечают, что она наказывает любые расхождения, даже безобидные — вроде другого оформления сокращений: на некоторых наборах данных простая нормализация текста снижала измеренную ошибку на ряде наборов до 50%. Иначе говоря, цифра «ошибается на 5%» не говорит, насколько ошибки мешают смыслу. Ошибка «ё» вместо «е» и ошибка «не» вместо «ни» для человека — разные вещи, а метрика считает их одинаково.
Поэтому, выбирая голосовой ввод, смотрите не на рекламные проценты, а на свой сценарий: ваши слова, ваш шум, ваш темп. Попробуйте продиктовать три-четыре типичные для вас фразы — и увидите больше, чем в любой таблице.
Миф: «современный ИИ слышит лучше человека»
Можно встретить громкие заголовки: «система распознавания превзошла человека». Они не выдумка — но читать их надо аккуратно. В статье про Whisper приводят показательную историю: в 2015 году система Deep Speech 2 достигла человеческого уровня на тестовом наборе LibriSpeech, и её авторы решили, что дальше улучшать почти нечего. Спустя семь лет лучший результат на том же наборе составил 1,4% ошибок против 5,8% у человека. При этом те же системы, обученные только на LibriSpeech, в других условиях — с шумом, акцентами, обычной бытовой речью — ошибались гораздо чаще людей.
Почему? LibriSpeech — это аудиокниги: чистая речь, чтение вслух, хорошие микрофоны. Человек справляется со всем подряд, а система — с тем, что похоже на её тренировку. Тест измеряет «сдачу экзамена», а не «понимание». Whisper пошёл другим путём: его обучили на 680 000 часов размеченного аудио, из них 117 000 часов — на 96 других языках, собранных из самых разных записей, и именно за счёт разнообразия он лучше переносит новые условия. Но и это не «слух лучше человеческого»: это просто очень большая тренировочная выборка.
Ещё одно подтверждение, что дело в данных, а не в «ушах»: модель wav2vec 2.0 сначала училась на неразмеченном аудио, вообще без текста, а потом ей хватило всего десяти минут размеченных записей, чтобы выдать 4,8% и 8,2% ошибок на чистой и «сложной» частях тестового набора. Ключ — это не «ухо», а то, сколько и какой речи модель услышала в обучении.
Как диктовать так, чтобы понимали с первого раза
Из механизма советы следуют сами — достаточно помнить, что система выбирает из вариантов:
Давайте контекст. Диктуйте фразами, а не одиночными словами: «закажи такси к вокзалу» распознаётся стабильнее, чем «вокзал». Опора на соседние слова сокращает число кандидатов.
Подведите микрофон ближе. Расстояние до источника важнее «качества» микрофона: голос поверх фонового гула — это больший сигнал на фоне того же шума. Гарнитура почти всегда лучше динамика смартфона на расстоянии вытянутой руки.
Говорите в обычном темпе. Модель обучали на живой речи, где слова связаны интонацией, а не разделены паузами; речь по слогам для неё менее привычна.
Сложные имена — отдельно. Если без редкого слова не обойтись, называйте его в окружении понятных слов или поправьте после — один раз, а не сорок.
Не бойтесь повторить. Вторая попытка — это новый звук и новое окно контекста: у системы появляется второй шанс выбрать верный вариант.
Если вы пользуетесь голосовым вводом не от случая к случаю, а регулярно, вам пригодится наш разбор о том, когда диктовать быстрее, чем печатать, а если мешает шум — материал про шум в микрофоне и как его убрать.
Что почитать дальше и где попробовать самому
Мы собираем в Schai всё, что вокруг ИИ: от разборов вроде этого до инструментов, где можно голосом поговорить с ассистентом и сразу увидеть, как он «слышит» именно вас. Начать можно с главной страницы Schai — там же лента статей и каналов.
Коротко
Распознавание речи — это выбор самого вероятного текста под звук, а не «слух». Звук превращается в спектрограмму, энкодер вытаскивает признаки, декодер подбирает слова с учётом уже написанного.
Первая попытка чаще всего ломается там, где мало сигнала или мало контекста: шум, редкое слово, короткая реплика, акцент, которого было мало в обучении.
Миф «ИИ слышит лучше человека» верен лишь для чистых тестов. В живых условиях решает разнообразие тренировочных данных.
Что делать: говорить фразами, держать микрофон ближе, не стесняться повторить — и помнить, что система не глупая, а просто угадывает.
Пока нет комментариев