ИИ-помощник для написания текстов: что он пишет сам, а что придётся переписать

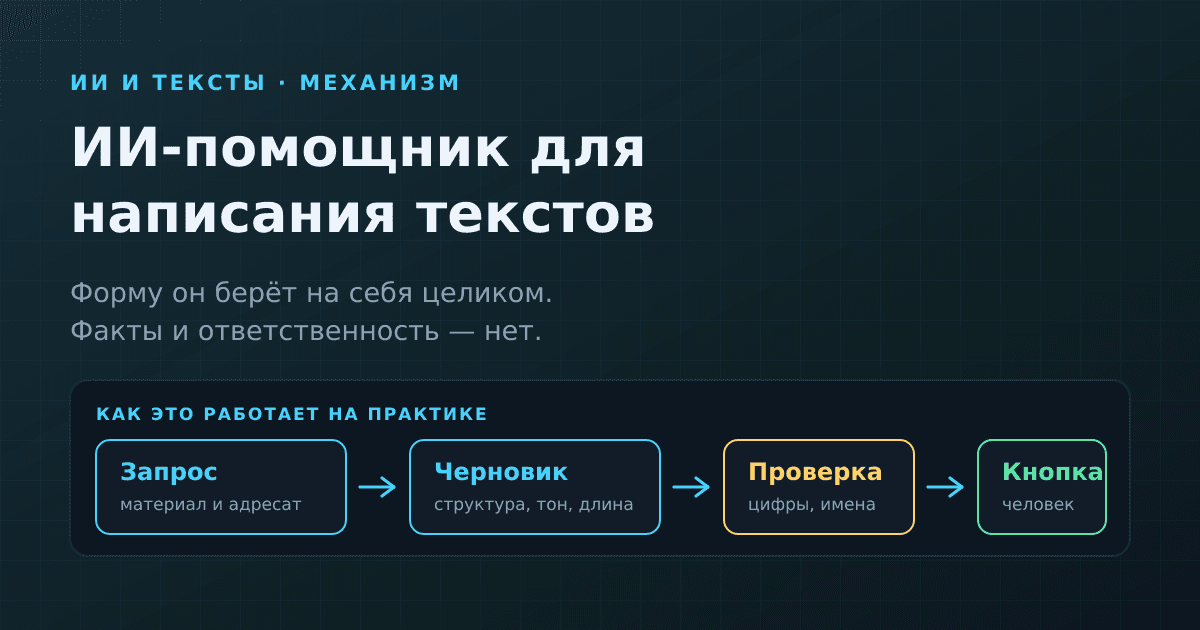
Если коротко. ИИ-помощник для написания текстов уверенно делает всё, что относится к форме: структуру, длину, ритм, тон, десять вариантов заголовка, превращение путаных заметок в связный абзац. И ровно так же уверенно ошибается там, где нужна фактура — цифры, даты, имена, цены, номера документов, ссылки. Переписывать после него приходится не «неудачные фразы», а всё, что в принципе можно проверить. Отсюда рабочее правило: модель пишет черновик, человек проверяет факты и жмёт кнопку.
Это Profile, аккаунт команды Schai. Ниже — разбор механизма, а не список советов: почему одна и та же модель выдаёт гладкий абзац и тут же изобретает несуществующий источник, какие приёмы в запросе убирают «водянистый» ИИ-стиль, где проходит граница уместности и почему в нашем собственном ассистенте ни один пишущий инструмент ничего не публикует сам.
Модель предсказывает следующее слово, а не проверяет факт
Языковая модель устроена просто: она оценивает, каким фрагментом текста вероятнее всего продолжается уже написанное. Всё, что она «умеет», выведено из статистики огромного массива текстов — и это сразу объясняет, в чём она сильна, а в чём беспомощна.
Форма статистична. Порядок слов, длина предложения, переход от тезиса к примеру, регистр делового письма против регистра поста в ленте — устойчивые закономерности, повторённые миллионы раз. Здесь модель работает лучше среднего человека, который садится писать текст раз в неделю.
Содержание нестатистично. Стоила ли конкретная услуга 4900 рублей, подписан ли закон именно 26 июля, зовут ли автора исследования так, как вы прочитали, — это единичные факты о мире. В тексте выдуманный факт выглядит точно так же, как настоящий: та же грамматика, та же интонация уверенности. Отдельного канала, по которому факт отличался бы от правдоподобной подделки, у модели нет — если источник не подан ей прямо в запросе.
Авторы из OpenAI и Georgia Tech в работе «Why Language Models Hallucinate» добавляют вторую половину объяснения: такие ошибки не только возникают при обучении, но и закрепляются при оценке. Большинство тестов ставят ноль и за «не знаю», и за неверный ответ — значит, при сомнении угадать выгоднее, чем промолчать. Модель воспитана как прилежный экзаменуемый, который никогда не оставляет пустую клетку.
Отсюда следствие, которое стоит держать в голове постоянно: по умолчанию ассистент не скажет «я не уверен». Уверенный тон в его ответе не несёт никакой информации о правильности. Если вам нужны отметки о сомнительных местах, их надо потребовать отдельным пунктом запроса — сами они не появятся.
Откуда берётся «водянистый» ИИ-стиль
Тот самый узнаваемый стиль — прямое следствие того же механизма. Модель тянется к наиболее вероятному продолжению; самое вероятное — самое частое; самое частое — самое безликое. Получается текст, усреднённый по всему, что написано на эту тему: без конкретного адресата, без вашего примера, с обязательным обобщающим абзацем в финале.
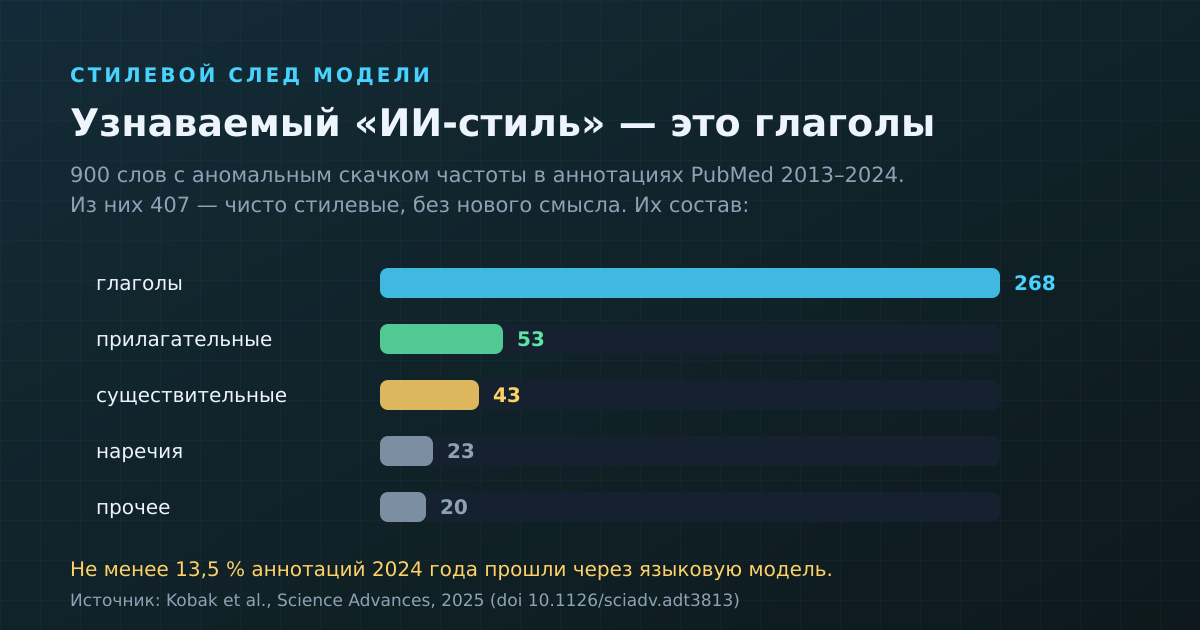
У этого следа есть измеримая сторона. Группа под руководством Дмитрия Кобака сравнила словарь 15 миллионов аннотаций PubMed за 2010–2024 годы и нашла 900 слов, частота которых после появления доступных языковых моделей скакнула аномально. 407 из них — чисто стилевые, не добавляющие смысла, и 268 из этих 407 оказались глаголами. То есть ИИ-стиль опознаётся не по «умным» терминам, а по глаголам-связкам вроде «подчёркивает», «демонстрирует», «освещает», «углубляется». Нижняя оценка авторов по аннотациям 2024 года — не меньше 13,5% написаны с участием модели, а в отдельных странах и журналах доля доходит до 40%.
Если механизм понятен, приёмы выводятся сами. Каждый из них делает одно и то же — сужает распределение, из которого модель выбирает продолжение:
Давайте материал, а не тему. «Напиши про наш сервис» — это запрос на среднее по интернету. Три абзаца ваших заметок, цитата клиента и реальная цифра — запрос на текст из этого материала, и воды в нём физически меньше.
Называйте адресата и ситуацию. «Письмо клиенту, который вчера жаловался на срыв срока» задаёт регистр точнее, чем «напиши вежливо».
Запрещайте обобщающий финал. Формулировка «последний абзац не подводит итог, а даёт следующее действие» убирает добрую половину лишнего.
Требуйте глаголы. «Без отглагольных существительных, предложения не длиннее пятнадцати слов» — прямой удар по той самой стилевой прослойке, которую померили выше.
Просите варианты, а не текст. Пять версий первого абзаца, из которых вы соберёте шестую, полезнее одной «финальной».
Про устройство самого запроса у нас есть два отдельных разбора — они дополняют этот раздел деталями.
Почему выдумываются именно цифра, имя и ссылка
Здесь механизм виден особенно наглядно. У ссылки, фамилии, номера закона, артикула и DOI очень жёсткая форма и совершенно произвольное содержание. Форму модель знает идеально — она видела её миллионы раз. Содержание ей взять неоткуда, и она заполняет знакомый шаблон правдоподобным. На выходе получается объект, который выглядит ровно как настоящий, и именно поэтому проходит беглую проверку глазами.
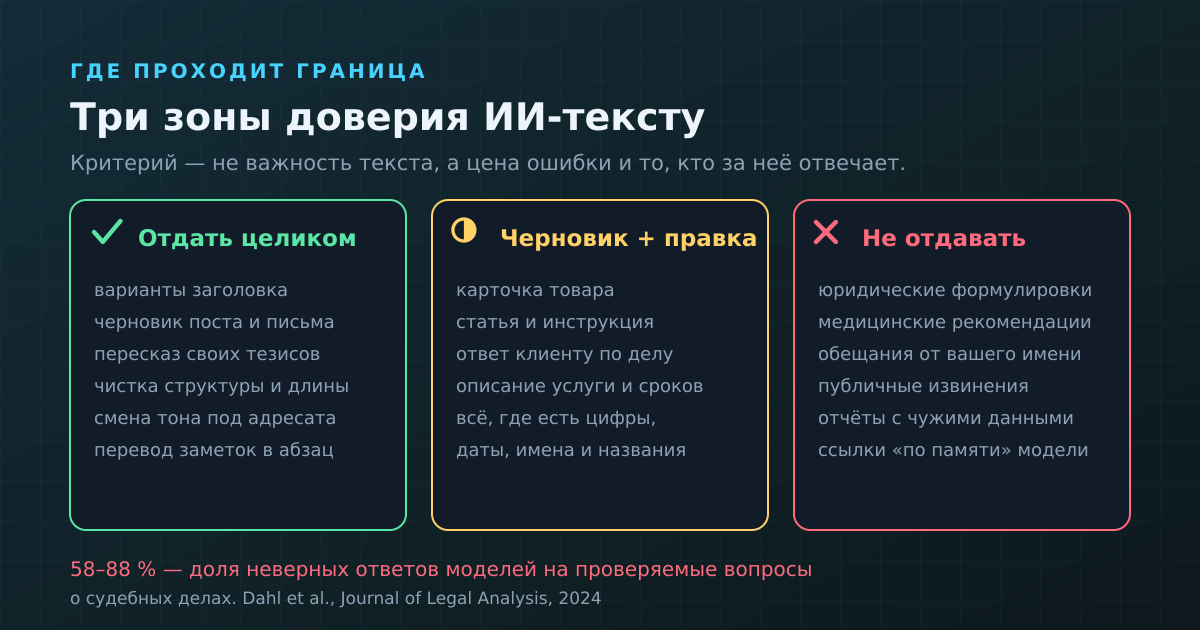
Масштаб хорошо померили на юридических вопросах. Исследователи Стэнфорда в работе, опубликованной в Journal of Legal Analysis, задавали моделям конкретные проверяемые вопросы о федеральных судебных делах США: доля неверных ответов составила от 58% у самой сильной модели до 88% у слабой. Там же два отдельно неприятных наблюдения. Первое: модели плохо откалиброваны — их уверенность почти не связана с их правотой. Второе: они принимают ложную предпосылку вопроса. Спросите «почему суд в деле N решил так-то» — и получите подробное объяснение решения, которого не было.
Отсюда критерий проверки, который сильно экономит время. Проверять надо не «факты» вообще — это слишком размыто, — а всё, что имеет форму: число, дату, имя собственное, название, ссылку, номер статьи. Если такой объект есть в тексте и вы не подавали его модели сами, по умолчанию считайте его непроверенным.
Два приёма делают проверку дешевле. Первый: просить модель в конце ответа отдельным списком перечислить утверждения, которые требуют проверки, — она неплохо опознаёт собственные слабые места, когда её об этом прямо спрашивают. Второй, более надёжный: не спрашивать факты у модели вовсе. Сначала найти источник самому, потом отдать его модели как материал — и попросить не выходить за его пределы.
Где ИИ-текст уместен, а где он вредит
Граница проходит не по важности текста, а по цене ошибки и по тому, кто за неё отвечает.
Отдать целиком можно всё, где ошибка правится следующим сообщением и ничего не стоит: варианты заголовка, черновик поста, пересказ ваших же тезисов, смена тона под другого адресата, сокращение длинного куска вдвое, приведение разнородных кусков к одной структуре.
Черновик плюс обязательная правка — всё, где есть проверяемые объекты: карточка товара со сроками и комплектацией, инструкция, статья, развёрнутый ответ клиенту по существу претензии. Конструкцию модель соберёт быстро и хорошо, но каждая цифра и каждое обещание должны прийти от вас, а не от неё.
Не отдавать стоит три вещи. Юридические формулировки: договор — это не текст, а распределение рисков, и одна неточная фраза меняет его действие целиком; модель воспроизводит вид юридического языка, а не его смысл. Всё, что читатель может принять за медицинскую рекомендацию: ассистент уместен, чтобы объяснить механизм, разобрать непонятный термин и помочь сформулировать вопросы врачу, но не чтобы назначать. И обещания от вашего имени — сроки, суммы, извинения, публичные заявления: подпись под ними ваша, а последствия наступают у вас.
Поиск наказывает не ИИ, а пустые страницы
Расхожий страх «поисковики отлавливают ИИ-тексты и понижают их» устроен иначе, чем кажется. В правилах Google о спаме есть раздел scaled content abuse — массовое производство страниц ради ранжирования. Там сказано прямо: речь о больших объёмах неоригинального контента, приносящего мало пользы или никакой, «no matter how it's created» — независимо от того, как он создан. Генеративные инструменты в списке примеров названы, но в конструкции «сгенерировать много страниц, не добавляя ценности для пользователя».
Разница практическая. Двести страниц под ключевые фразы, собранные за вечер, — нарушение вне зависимости от инструмента, которым их собрали; такой же результат дал бы синонимайзер десять лет назад. Один материал, где модель помогла со структурой, а фактуру, примеры и выводы принёс автор, — не нарушение, и специально отличать его от «полностью человеческого» поиск не пытается. Ставка на объём проигрывает не потому, что текст машинный, а потому, что он пустой.
Маркировка: что уже написано в законе
В России тема свежая, и формулировки стоит знать дословно. Федеральный закон от 26.07.2026 № 243-ФЗ «О поддержке развития технологий искусственного интеллекта в Российской Федерации» содержит статью 9 — «Маркировка информационного материала, созданного с применением больших фундаментальных моделей искусственного интеллекта». По части 1 лицу, применяющему такую модель для создания материала «в аудио- и (или) визуальной форме», обеспечивается возможность разместить информационное предупреждение о применении технологий ИИ. Именно возможность, а не обязанность: формат и порядок определяются соглашением с тем, кто дал доступ к модели. Владельцы крупных сайтов и соцсетей, в свою очередь, обязаны такую возможность пользователю предоставить. Сам закон вступил в силу 1 сентября 2026 года, а статьи 8–10, включая эту, — с 1 марта 2027 года.
Что из этого следует для текстов: обязательной пометки «написано нейросетью» на статье или посте закон не вводит, и ответственность за содержание он ни с кого не снимает — она остаётся там же, где была, на авторе публикации. Маркировка — это про честность перед читателем, а не про перекладывание ответственности на инструмент.
Как это сделано у нас: черновик готовит ИИ, кнопку жмёт человек
Теперь про наш продукт — в той части, где принцип виден в коде, а не в обещаниях. У ассистента Schai GPT единый реестр инструментов; к текстам относятся несколько: черновик поста в ленту, черновик большой статьи, карточка товара для маркетплейса, черновик ответа в личной переписке, создание Google-документа или таблицы, файл Word/Excel/PDF, одностраничный сайт и правка уже собранного сайта.
Ключевое — как они разделены. У всех «пишущих» инструментов внутренний признак побочного действия выключен: они ничего не меняют в мире, а возвращают структуру, которую чат показывает карточкой. Публикация поста и отправка сообщения — два отдельных инструмента, и только они помечены как действие с последствиями. В агентном режиме, где ассистент сам ведёт многошаговую задачу, эти два имени вынесены в отдельный список, который агент не имеет права выбрать самостоятельно. Серверный обработчик черновиков не публикует и не отправляет ничего в принципе: публикацией занимаются другие адреса, и вызываются они по нажатию человека.
Часть правил намеренно вынесена из текстовой инструкции в код — потому что инструкцию пользователь может переопределить своими настройками персоны, а код нет. Длина поста ограничена 2200 знаками, внешние ссылки в ленте запрещены, и пост с ними просто не опубликуется. В инструкции черновика прямо записано: не выдумывать факты о пользователе — город, работу, семью, — если он их не называл. В инструкции ответа в мессенджере — не назначать встречи и не называть суммы, адреса, даты и обещания, которых пользователь не давал, а при нехватке данных задать короткий уточняющий вопрос вместо выдумки. Цену товара ассистент не сочиняет вовсе: без названной суммы он отвечает отказом и просит её назвать.
Про модели. Базовая работает у всех, а в меню есть несколько платных разных уровней. Разброс расхода между ними большой: самая лёгкая из платных обходится примерно вдвое дороже базовой, самая тяжёлая — почти в восемьдесят раз. Тяжёлая модель заметно лучше держит длинную логику, сложную структуру и редкие темы. Чего она не меняет — природы предсказания: проверкой фактов она не становится ни на одном уровне, и черновик от неё остаётся черновиком.
Коротко
Форма — сильная сторона модели, содержание — слабая. Она предсказывает продолжение текста, а не проверяет мир; выдуманный факт выглядит в точности как настоящий.
«Уверенно» не значит «верно». Оценочные процедуры поощряют угадывание, поэтому по умолчанию ассистент не признаётся в незнании — просить об этом надо явно.
Водянистый стиль лечится сужением задачи: свой материал вместо темы, конкретный адресат, запрет на обобщающий финал, короткие предложения и глаголы вместо отглагольных существительных.
Проверяйте всё, что имеет форму — числа, даты, имена, названия, ссылки, номера статей. Если вы не подавали объект модели сами, он непроверен.
Три зоны: отдать целиком, черновик с обязательной правкой, не отдавать вовсе. Критерий — цена ошибки и наличие ответственности.
Поиск наказывает пустые страницы, а не машинное происхождение текста.
Закон 243-ФЗ даёт возможность маркировать ИИ-контент, но не обязанность, и ответственность за текст оставляет на авторе.
В Schai GPT инструменты написания текстов ничего не публикуют: они собирают черновик, а публикацию и отправку выполняет отдельное действие по кнопке человека.
Пока нет комментариев