

Если коротко: соцсеть X (бывший Twitter) выложила на GitHub исходный код, который собирает и ранжирует ленту «Для вас». Из него видно, что лента устроена как конвейер: сначала набираются кандидаты (посты тех, на кого вы подписаны, и «чужие» посты из рекомендаций), потом лишнее отсеивается, потом нейросеть оценивает вероятность ваших реакций на каждый пост, и по сумме этих оценок посты упорядочиваются. Никакого тайного «рубильника» там нет, зато есть понятная логика: лента подстраивается под то, что вы реально делаете, а не под то, что вы говорите.
Меня зовут Игорь Пчёлкин, я пишу код, читаю чужой и люблю, когда технологии можно проверить, а не только пересказать. Открытый код ленты — как раз такой случай. Оговорка сразу: я разбираю то, что написано в репозитории xai-org/x-algorithm, и не берусь судить, как всё это работает в продакшене сегодня вечером: сами авторы пишут, что часть систем не опубликована.
Что именно опубликовано
В описании репозитория сказано, что это «алгоритм, питающий ленту For You на X». Внутри лежат несколько сервисов. Home Mixer собирает ленту и управляет всеми этапами. Candidate pipeline — общий каркас конвейера, где каждый этап называется одним из слов: источник, «гидратор» (дополняет пост данными), фильтр, скорер (оценщик), селектор, побочный эффект. Thunder хранит в памяти свежие посты тех, на кого вы подписаны. Phoenix отвечает за рекомендации «из чужих аккаунтов» и за ранжирование. Есть и другие источники кандидатов, например поиск по кластерам похожих пользователей (SimClusters) и общий список популярных постов.
Важная оговорка из самого README: часть материалов не опубликована, например некоторые подсказки для модели-разметчика и правила для борьбы с ботами, чтобы их не использовали для обхода. По сообщению TechCrunch о расширении релиза в августе 2026 года, в публикацию вошли конфигурация модели, фильтрация, детали ранжирования и параметры, задающие веса сигналов, а код стал в 10–15 раз больше прежнего. Репозиторий распространяется под лицензией Apache 2.0, то есть код можно читать, запускать и использовать по условиям лицензии.
Как собирается лента: пять шагов
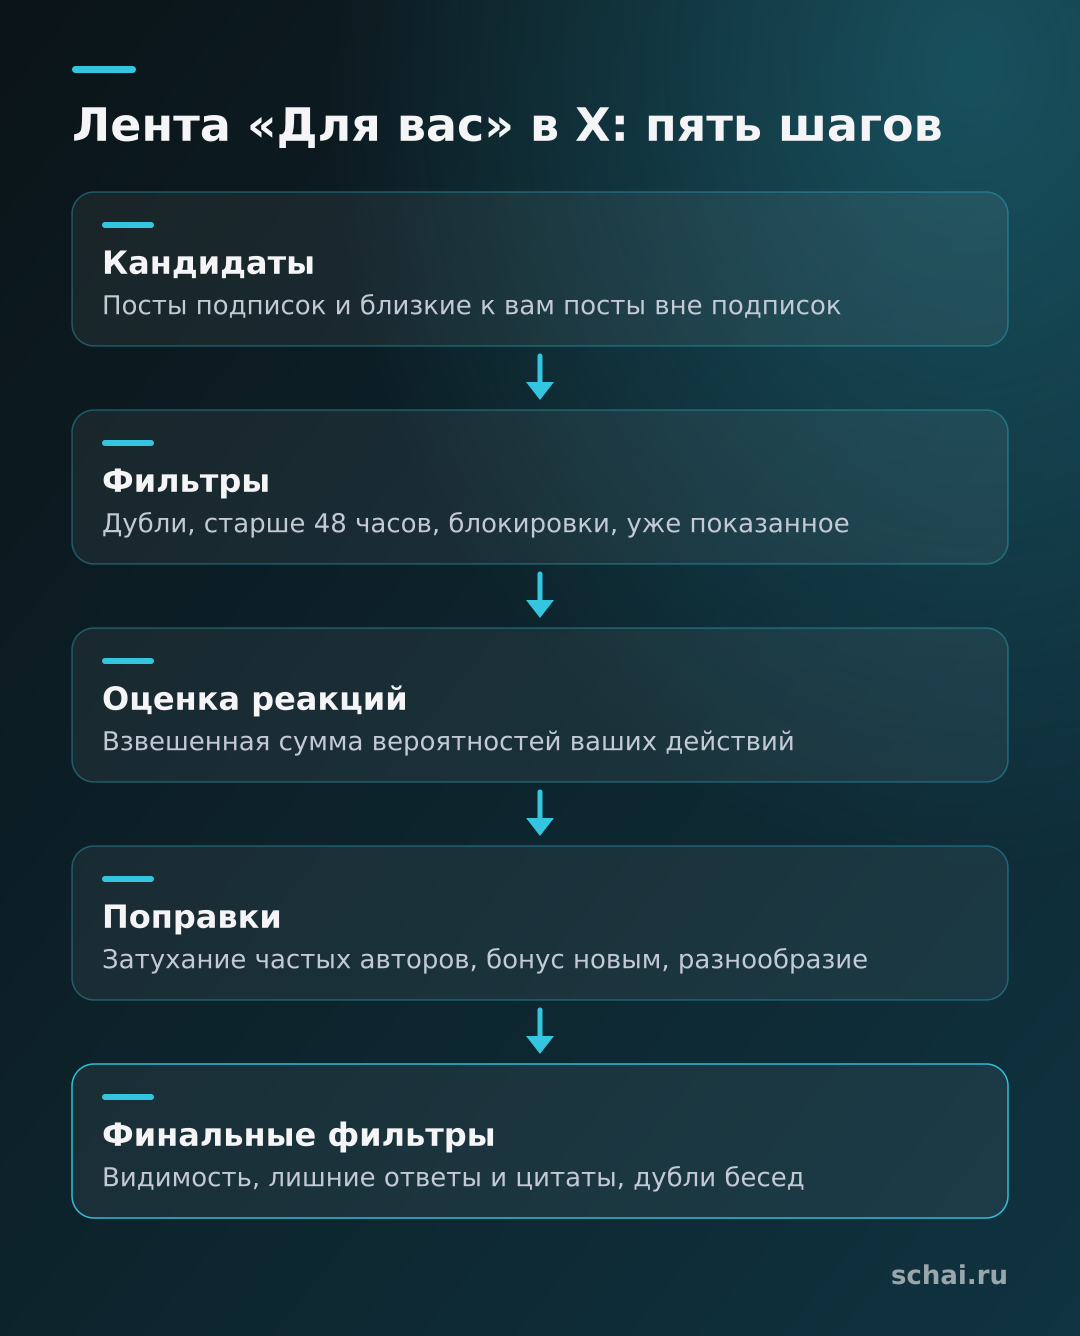
Первый шаг — кандидаты. Лента не просматривает все посты мира: это невозможно и не нужно. Thunder быстро отдаёт недавние посты ваших подписок, а Phoenix ищет «ближайшие» к вам посты вне подписок: система превращает и вас, и посты в наборы чисел (эмбеддинги) и находит те посты, которые лежат рядом с вами в этом числовом пространстве. Это и есть механизм «рекомендаций»: не магия, а геометрия.
Второй шаг — фильтры до оценки. Согласно README, отсеиваются дубликаты, посты старше 48 часов, ваши собственные посты, посты заблокированных и заглушённых аккаунтов, посты с заглушёнными вами словами, уже показанные вам, а также недоступные вам посты по подписке. Практический вывод: свежесть жёстко ограничена, пост двухдневной давности в «Для вас» не попадёт вообще.
Третий шаг — оценка. Phoenix предсказывает вероятность разных ваших действий над каждым постом. Группы действий такие: вовлечение (лайк, ответ, репост, цитата, отправка), переходы, внимание (время просмотра, просмотры видео), подписка на автора и негативные действия (нажать «не интересно», заглушить, заблокировать, пожаловаться). Затем компонент RankingScorer считает взвешенную сумму этих вероятностей. Главное: по README, веса применяются к предсказанным вероятностям, а не к сырым счётчикам лайков. То есть модель оценивает, как вы лично среагируете, а не просто сколько у поста реакций.
Четвёртый шаг — поправки. После взвешенной суммы применяются три корректировки: затухание для повторяющихся авторов (чтобы лента не превращалась в монолог одного человека), скидка для постов не из подписок и бонус для новых авторов. Дополнительно VM Ranker переупорядочивает уже оценённые посты, чтобы лента была разнообразнее, с помощью математического приёма, который называется детерминантным точечным процессом над эмбеддингами.
Пятый шаг — фильтры после отбора: проверки видимости, отсев лишних частей цепочек ответов и цитат, устранение дублей по беседе. Ранжирование и фильтрация видимости, как подчёркивают авторы, — отдельные системы.
Что из этого следует для автора и читателя
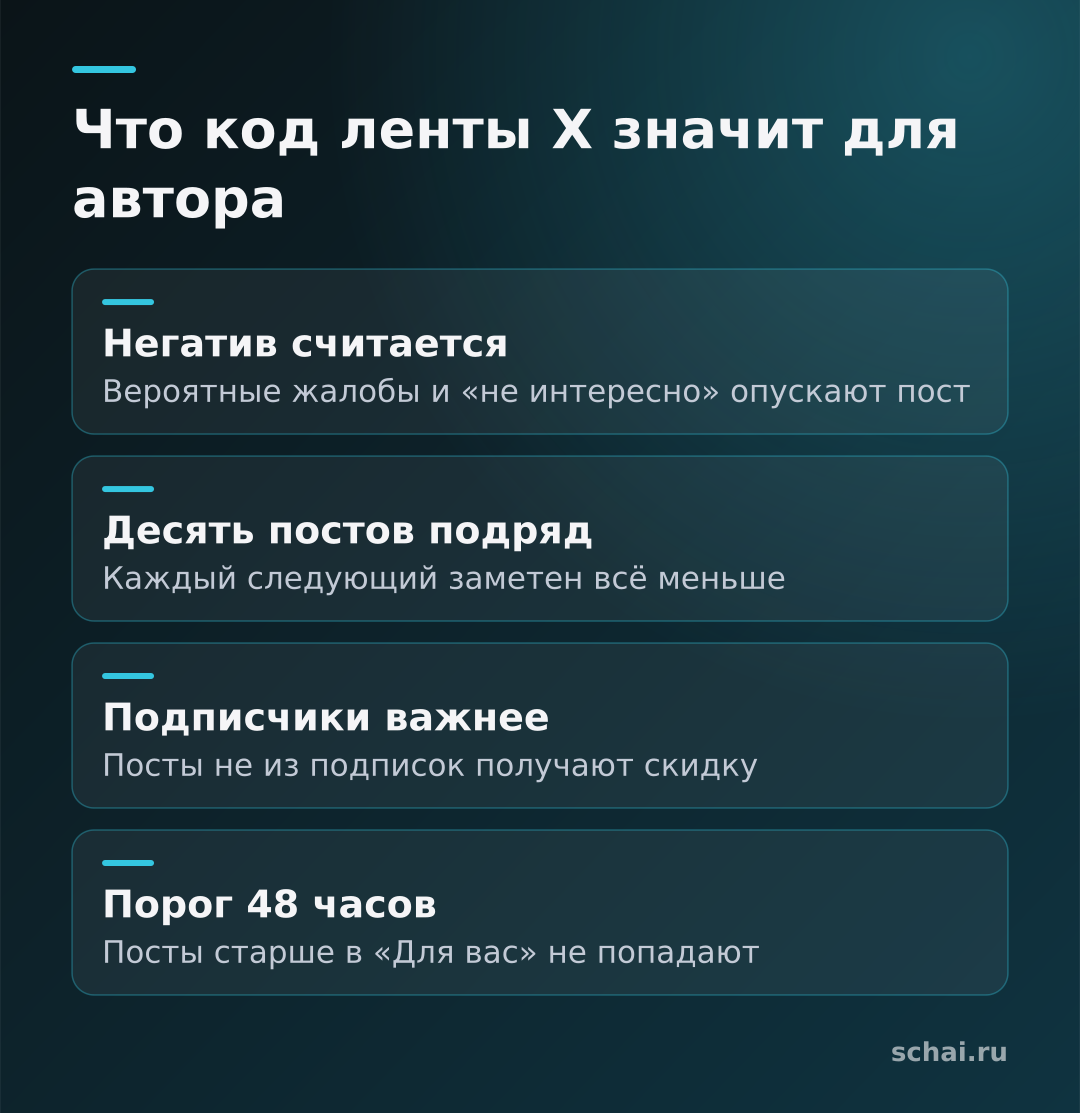
Из этой схемы можно сделать несколько выводов, не прибегая к мифам. Негативные сигналы входят в расчёт наравне с позитивными. Жалоба, блокировка и «не интересно» — это отдельные предсказываемые действия, и если модель считает их вероятными, пост опускается. Поэтому провокация ради охватов может сработать против автора.
Далее: разнообразие встроено намеренно. Если вы публикуете десять постов подряд, затухание для повторяющегося автора делает каждый следующий менее заметным, это видно в самом описании этапов. Новым авторам дан бонус, но и скидка для чужих постов существует: подписчики видят вас охотнее, чем незнакомцы.
Наконец, свежесть имеет жёсткий порог. Фильтр на 48 часов означает, что «вечнозелёные» посты через рекомендации не живут. Если вам важна долгая жизнь материала, нужно, чтобы он возвращался другими путями: через поиск, закладки, ссылки.
Чего в коде нет и почему это важно знать
Читая открытый код, легко решить, что вы увидели всё. Это не так. Во-первых, README прямо говорит, что часть файлов опущена. Во-вторых, TechCrunch пишет, что не опубликованы системы, в которых Grok предсказывает, нарушает ли пост правила: X объясняет это защитой от спамеров. В-третьих, у любой обученной модели поведение определяется её весами, а не только кодом вокруг. В обновлениях за август 2026 года авторы пишут, что демонстрационную модель Phoenix заменили кодом, которым обучают рабочие модели, и добавили генерацию синтетических данных для запуска. То есть вы можете запустить пример и посмотреть, как всё устроено, но это не копия живой системы.
Ещё одно честное замечание. Репозиторий обновляется: в нём есть записи об изменениях с августа по октябрь 2026 года, а в новостях разные источники называют разные даты первой публикации. Поэтому, если вы читаете это позже, проверяйте актуальное состояние на странице проекта, а не полагайтесь на пересказ, включая мой.
Как читать такие репозитории самому
Если захотите заглянуть в код, начните не с файлов моделей, а с README и каталога `home-mixer`: там видно порядок этапов, и вы поймёте, где что происходит. Затем откройте список фильтров и посмотрите, какие правила жёсткие (возраст, блокировки), а какие мягкие (скоринг). Модель Phoenix читайте в последнюю очередь: она сложнее всего, и без понимания каркаса вокруг неё деталей будет слишком много.
И последнее: открытый код не означает, что ленту нельзя «обмануть» или что она справедлива. Он даёт возможность проверить заявленное и обсуждать конкретные места, а не слухи. Это уже много.
Зачем это вообще опубликовали
Официальная мотивация в README простая: прозрачность, чтобы люди могли проверять и критиковать, как распределяются посты. Для разработчика у открытого кода есть и практическая польза: можно увидеть, как устроен промышленный рекомендательный конвейер, и позаимствовать архитектуру. Разделение на источники, фильтры, оценщики и селекторы встречается в рекомендательных системах повсеместно, а здесь оно показано на живом примере с лицензией Apache 2.0.
Есть и ещё один плюс: README отмечает, что кандидаты не «смотрят» друг на друга при оценке, поэтому оценка поста не зависит от того, какие посты оказались в одной пачке. Для инженера это значит, что результат воспроизводим и поддаётся тестированию, а это редкость для систем такого рода.
Коротко
Лента «Для вас» в X — конвейер: кандидаты из подписок и рекомендаций, фильтры, предсказание ваших реакций моделью, взвешенная сумма, поправки на разнообразие и вторичные фильтры. Оцениваются вероятности ваших действий, включая негативные, а не просто число лайков. Посты старше 48 часов отсеиваются. Код опубликован под лицензией Apache 2.0, но часть систем (например, модерационные) не раскрыта, а работа обученной модели зависит от её весов, поэтому по коду нельзя гарантированно «набрать охваты».
Пока нет комментариев